Spring AI 大模型零基础教程解析:从原理到企业实战的学习路径
一套面向零基础Java开发者的Spring AI大模型系统课程,从原理到企业实战覆盖完整路径。
这门被称为「全网最全」的B站Spring AI教程,针对当前AI教学内容碎片化、重理论轻实操的痛点,以基础、进阶、实战三大篇章构建了一条从大模型原理到企业落地的完整学习路径。基础篇讲解Transformer架构与提示词工程,进阶篇深入RAG、私有化部署与模型微调等企业级核心能力,实战篇则以智能Agent、企业知识库、医疗大模型等真实项目收尾。课程配套学习路线图、课件与电子书,整体结构较为系统。然而,「七天从小白到大神」「学完即就业」等宣传话术需理性看待——大模型开发能力的真正形成,仍依赖在真实项目中的持续动手实践。
面向零基础学习者的 AI 大模型系统教程正在成为 B 站热门内容。这份被作者称为「全网最全」的 Spring AI 教程,试图解决当前大模型教学中普遍存在的一个痛点:内容碎片化、重理论轻实操。本文拆解其课程结构与知识脉络,帮助有意入门大模型开发的读者判断学习价值。
课程定位:填补实操教学的空白
作者在介绍中提到,为了打造这门课程,他刷遍了 B 站相关视频,还专程研究了 YouTube 上国外教学内容,得出的结论是「90% 的内容要么鱼龙混杂、浅尝辄止,要么只讲理论不带动手」。这一判断实际上点出了当下 AI 教学市场的真实困境——大模型概念火热,但能把知识讲透并配合完整实操的资源确实稀缺。
课程强调「用最原始、最直观、最纯粹的方式把大模型知识讲清楚」,并宣称花费三个月重新梳理了整个知识体系。对于零基础学习者而言,这种去包装、重实操的思路值得肯定,但也需要理性看待「七天从小白到大神」这类宣传话术——大模型开发的深度远非一周可以掌握。
Spring AI 是 Spring 官方推出的 AI 应用开发框架,旨在让 Java 开发者以熟悉的编程范式对接各类大模型 API(如 OpenAI、Azure OpenAI、Ollama 本地模型等)。它封装了模型调用、提示词模板、对话记忆、向量数据库集成、函数调用等常见能力,使 Java 生态的企业开发者无需深入了解 Python 生态的 LangChain 等工具链,即可在现有 Spring Boot 项目中快速接入大模型功能。对于以 Java 为主力语言的后端工程师而言,Spring AI 是进入大模型工程化领域的低摩擦入口,这也解释了该课程面向的目标群体定位。
三大篇章:从核心原理到企业落地
课程整体划分为基础、进阶、实战三个篇章,形成一条较为完整的学习路径。
基础篇:搭建认知与开发环境
基础篇涵盖大模型核心原理、AI 开发环境搭建、提示词工程、Transformer 架构以及预训练机制。这一部分的设计逻辑清晰:先建立对大模型底层运作的理解,再动手配置开发环境。Transformer 架构和预训练机制是理解现代大模型的关键,将其放在入门阶段讲解,能帮助学习者避免「只会调 API 却不懂原理」的常见问题。
Transformer 架构由 Google 于 2017 年在论文《Attention Is All You Need》中提出,是 GPT、BERT 等现代大模型的共同基础。其核心机制是"自注意力"(Self-Attention):模型在处理序列中的每个词时,能同时关注序列中所有其他词的上下文关系,而非像早期 RNN 那样逐步传递信息。这一机制使模型能够高效捕捉长距离依赖,并充分利用 GPU 并行计算能力,从而支撑起数百亿甚至数千亿参数规模的预训练。理解 Transformer 的注意力机制、位置编码和前馈网络结构,有助于学习者后续更好地理解提示词为何有效、微调调整的是哪些参数,以及模型输出的概率本质。
进阶篇:企业级核心能力
进阶篇深入 RAG(检索增强生成)、私有化部署、模型训练与高效微调技巧。这几个主题正是企业应用大模型时最关注的方向。RAG 解决了大模型知识时效性和私有数据接入的问题;私有化部署关系到数据安全与合规;微调则是让通用模型适配特定业务场景的核心手段。这部分内容的实用价值最高,也是区分「玩家」与「开发者」的分水岭。
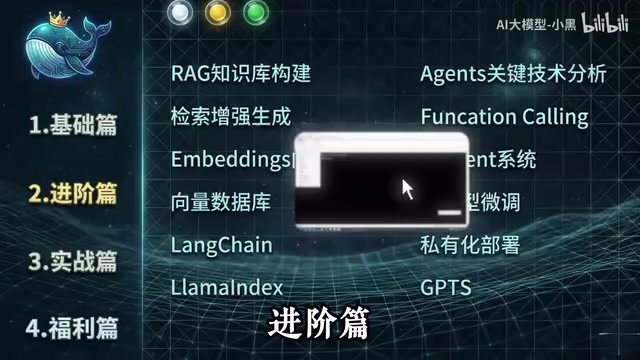
RAG(Retrieval-Augmented Generation,检索增强生成)是当前企业落地大模型最主流的技术方案之一。其核心思路是:不直接依赖模型训练时固化的知识,而是在推理阶段实时从外部知识库中检索相关文档片段,将其拼入提示词后再交由模型生成答案。这样既能突破模型知识截止日期的限制,又能让模型访问企业私有数据(如内部文档、产品手册、合同库),同时大幅降低"幻觉"风险。与全量微调相比,RAG 无需重新训练模型,部署成本和维护门槛都更低,因此成为企业知识库和客服问答系统的首选架构。
高效微调方面,LoRA(Low-Rank Adaptation)是目前最广泛使用的参数高效微调方法。它不改动原始模型的全部权重,而是在特定层旁路插入低秩矩阵,只训练这部分新增参数。这使得在消费级 GPU 上微调数十亿参数的模型成为可能,大幅降低了企业定制模型的硬件门槛。
实战篇:真实项目落地
实战篇是整个课程的落脚点,包含智能 Agent 开发、数字人应用、企业知识库与问答系统、医疗大模型实战等项目。这些案例覆盖了当前大模型商业化的主流方向。智能 Agent 与企业知识库是目前落地最快的两类应用,而医疗大模型则代表了垂直行业的深度探索。以真实项目驱动学习,符合工程实践的成长规律。
配套资源与学习方式
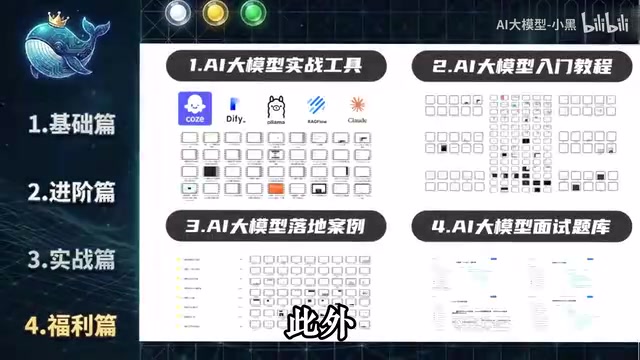
除视频内容外,作者还准备了学习路线图、课件和电子书,并强调不用担心跟不上或记不全笔记。这类配套资源对系统学习很有帮助,尤其是路线图能让学习者对整体知识框架有清晰认知,避免在海量内容中迷失方向。
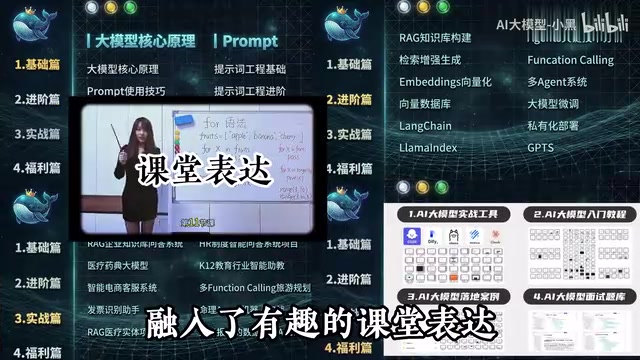
课程主打「大量实操案例」和「知识点密集输出」,这种节奏对有一定基础、希望快速提升的开发者较为友好,但对完全零基础的学习者可能需要反复消化。建议学习时配合动手实践,而非单纯观看视频。
客观看待宣传与实际价值
这门课程在内容规划上确实较为系统,从原理、进阶到实战形成了闭环,覆盖了大模型开发从入门到企业应用的主要环节。但「748 集」「学完即就业」「少走 99% 的弯路」等宣传语更多是流量话术,学习者应关注课程本身的知识密度与实操质量,而非被数字和承诺吸引。
对于想系统入门大模型开发的读者,这类结构化教程可以作为知识框架的参考。真正的能力提升,仍取决于在真实项目中的持续动手与思考。
相关推荐
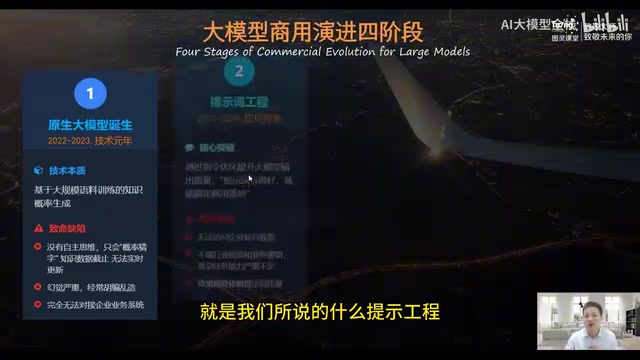
AI Agent实战入门:从大模型演进看智能体的价值与落地
从原生大模型、提示工程、RAG到AI Agent智能体,系统梳理大模型商业落地的四个阶段,解析Agent的翻译官、工具达人、记忆管家、任务管家四大核心能力,并给出企业级Agent入门的三个实战项目路线。
AI Agent智能体系统学习路径拆解:从原理到实战的完整框架
AI Agent智能体系统学习路径拆解:从Agent原理、Prompt工程、RAG知识库到多Agent协作与工具调用,再到个人知识库助手、智能客服等实战项目,帮零基础学习者打通从入门到落地的完整链条。
AI Agent智能体入门:大脑、记忆与工具三要素详解
从零理解AI Agent智能体:详解大脑、记忆、工具三大核心组件,梳理大模型从原生模型、提示工程、RAG到Agent的四阶段演进,帮你搞懂Agent到底解决了什么问题以及为何值得学习。