SQLite扩展实战:C与Rust实现parse_number性能对比
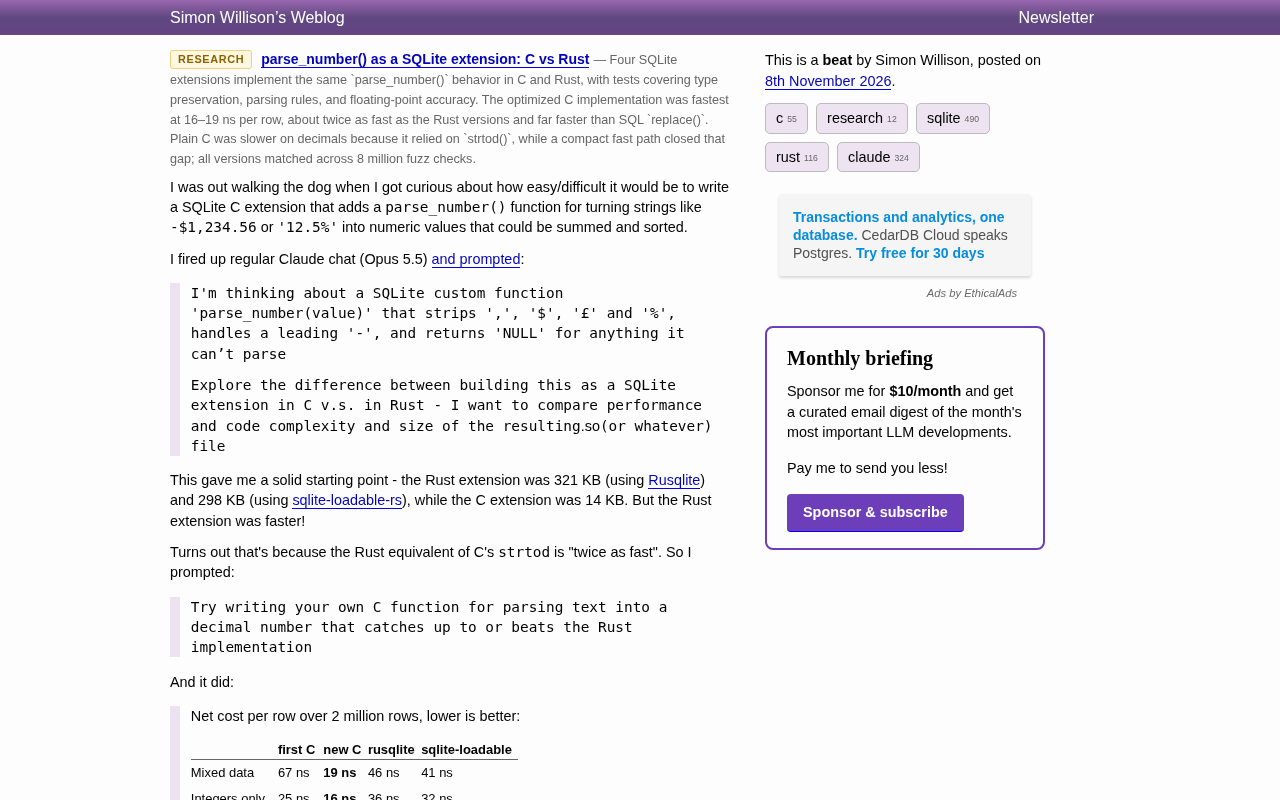
Simon Willison 用 parse_number() 扩展对比 C 与 Rust 的体积、性能与维护成本。
文章记录了 Simon Willison 以给 SQLite 增加 parse_number() 函数为切口,对比 C 与 Rust 编写 SQLite 扩展的实验。首轮 Rust 体积约 300 KB、C 仅 14 KB,但 Rust 因底层解析函数更快而性能领先;随后让 Claude 手写定制 C 解析器,在 200 万行数据上于混合、整数、小数三类场景全面反超 Rust,小数解析从 106 ns 降至 18 ns。文章进一步讨论复杂度与可维护性权衡,并总结出“原型—度量—定向优化—复盘”的 AI 辅助开发工作流。
从一个简单想法说起
Simon Willison 在遛狗时冒出一个念头:如果能给 SQLite 加一个 parse_number() 函数,把 -$1,234.56 或 12.5% 这类字符串直接转成可求和、可排序的数值,会带来多少便利?这个看似简单的需求,恰好成了一次观察不同语言实现 SQLite 扩展性能与复杂度的绝佳切口。
他借助 Claude 聊天(Opus 5.5)展开实验,先让 AI 分别用 C 和 Rust 写扩展,再针对性能瓶颈迭代优化,最终把过程整理成一份可复现的研究报告。整个探索路径清晰:原型 → 度量 → 优化 → 复盘,也为日常工具选型提供了可参考的思考框架。
SQLite 扩展(loadable extension)是 SQLite 从 3.9.0 起正式支持的一种动态库机制:开发者可以把共享库(Linux 的 .so、macOS 的 .dylib、Windows 的 .dll)编译好后,在 SQLite 会话中用 SELECT load_extension('path/to/ext') 加载,从而向 SQL 语言中注册新的标量函数、聚合函数、排序规则甚至虚拟表。扩展通过 sqlite3_create_function 等 C API 注册回调,SQLite 在执行 SQL 时调用这些回调完成计算。本文中的 parse_number() 正是以这种方式注册的标量函数。由于扩展与 SQLite 核心以 C ABI 交互,C 天然是最直接的实现语言,其他语言需借助 FFI 封装层(如 Rusqlite、sqlite-loadable-rs)来暴露同样的接口,这也是体积差异的重要来源之一。
第一轮:代码体积与性能的鲜明反差
最初的实现给出了一个直观对比:Rust 版本生成的共享库体积远超 C 版本。基于 Rusqlite 的扩展为 321 KB,使用 sqlite-loadable-rs 的版本为 298 KB,而 C 扩展只有 14 KB——差距接近一个数量级。
但性能测试却出现了反转:Rust 扩展反而更快。原因并不神秘,Rust 标准库中等价于 C strtod 的解析函数本身速度约为后者的两倍。这暴露了一个常见误区:体积小不等于性能好,底层解析函数的实现质量才是关键变量。
strtod 是 C 标准库中把字符串解析为 double 的函数,全称 string to double,声明于 <stdlib.h>。它需要处理符号、前导空白、十进制与科学计数法、inf/nan、本地化小数点等大量边缘情况,并遵循 C 标准与 IEEE 754 的舍入要求,因此实现内部包含众多分支与校验逻辑。parse_number() 面对的场景却窄得多——只需去掉货币符号、千分位逗号、百分号,再解析一个有限格式的数字,不需要支持十六进制浮点、极长有效数字或 locale 差异。正因为输入域被大幅收窄,定制解析器能跳过 strtod 为通用性付出的开销,这也是后文新 C 实现能把小数解析从 106 ns 压到 18 ns 的根本原因。
第二轮:让 C 追赶并反超
既然瓶颈在数字解析本身,Simon 让 Claude 尝试手写一个 C 解析函数,目标是追上甚至超过 Rust 实现。结果相当显著:在 200 万行数据上的每行净开销(越低越好)对比如下:
| 数据类型 | 首次 C | 新 C | rusqlite | sqlite-loadable |
|---|---|---|---|---|
| 混合数据 | 67 ns | 19 ns | 46 ns | 41 ns |
| 纯整数 | 25 ns | 16 ns | 36 ns | 32 ns |
| 纯小数 | 106 ns | 18 ns | 55 ns | 47 ns |
新 C 实现在三类数据上都取得了领先,尤其是小数解析从 106 ns 降到 18 ns,提升幅度最为突出。这说明标准库函数并非总是最优解——针对特定格式(去符号、去千分位、处理百分号)定制解析逻辑,可以绕过通用函数的额外分支与校验开销。
性能之外的权衡:复杂度与可维护性
单看数字,C 方案在体积和速度上双赢。但代码复杂度的账不能只看运行时。Rust 版本借助 Rusqlite 或 sqlite-loadable-rs,内存安全边界更清晰,错误处理更结构化;而追求极致性能的定制 C 解析器,需要手动管理缓冲区、处理边界条件,维护和审计成本随之上升。
对于这类纯字符串转换函数,输入域相对可控、逻辑封闭,C 的风险尚在可接受范围。但若扩展到涉及动态内存分配、并发或复杂状态机的扩展,Rust 的安全保障价值会明显放大。选型时,性能基准只是决策的一个维度,团队语言栈、长期维护成本同样重要。
Rusqlite 是 Rust 生态中较成熟的 SQLite 绑定库,封装了连接、语句、事务和用户自定义函数等 API,但它主要面向在 Rust 程序中使用 SQLite,而非专门用于编写可加载扩展。sqlite-loadable-rs 则定位不同:它基于 sqlite3ext.h 的可加载扩展 API,提供宏和类型封装,让开发者以接近原生扩展的方式注册函数,并处理入口点符号、内存分配器等细节。两者都会把 Rust 标准库或运行时的一部分静态链接进产物,这解释了几百 KB 的体积;而 C 扩展可以直接依赖宿主 SQLite 已加载的 libc 符号,产物自然小得多。理解这层差异,才能把“体积”与“性能”放在正确的维度上比较。
AI 辅助开发的工作流启示
这次实验还展示了一种高效的 AI 协作模式:先让模型产出可运行的原型,用真实基准数据暴露问题,再针对具体瓶颈提出优化指令,最后让模型把过程整理成结构化报告。每一步都有明确的验收标准,避免了对 AI 输出的盲目信任。
从 parse_number() 这个小函数出发,得到的不仅是一份 C 与 Rust 的对比数据,更是一套可复用的方法论:用度量驱动优化,用对比厘清权衡。对于经常编写 SQLite 扩展或做底层工具选型的开发者,这份研究报告值得一读。
相关推荐
Claude Code额度不够用?实测哪些技巧真省额度
实测 Claude Code 20美元套餐:换用 Sonnet 或 Haiku、降低 effort 能让同样任务额度减半以上,而 /clear、/compact、plan mode 等流传技巧在短会话中几乎不省额度甚至更贵。
Anthropic新研究:AI记忆如何避免「记错」?
Anthropic最新报告探讨AI智能体跨会话记忆的可靠性:数据库任务中记忆提升基准分数,但游戏实验显示记忆可能固化错误。报告建议保留证据、测试规则、纠正过时笔记,为助手构建者提供实践指南。
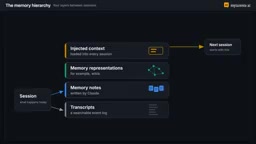
AI智能体记忆全解析:四层结构与“做梦”机制
解读Anthropic智能体记忆研究:记忆的四层架构、以CLBench和宝可梦实验检验“该记什么”,以及通过“做梦”修正笔记、构建wiki、提升上下文注入质量的机制与局限。