Strata更新实测:IQ3_S量化模型效果与性能解析

Strata更新引入IQ3_S量化模型,精度近BF16但内存占用高达50GB以上,适合硬件充裕用户。
本地大模型工具 Strata 最新更新引入了 IQ3_S 量化模型,该模型在基准测试中表现接近 BF16 原始精度,相比前代 IQ3_XXS 在视觉生成质量和结构合理性上均有明显提升。实际测试涵盖赛博朋克风格动画、3D 骑行场景及自由女神像生成等任务,结果显示 IQ3_S 整体表现更干净,但部分功能仍存在 bug。代价方面,模型体积比 IQ3_XXS 增大约 7GB,运行时内存占用达 50 GB 以上,调试复杂项目时甚至飙升至 62GB,内存受限设备面临 OOM 崩溃风险。总体而言,IQ3_S 是硬件充裕用户的值得一试的升级选项,但内存吃紧的用户需谨慎评估自身硬件底子再做决策。
Strata再更新:IQ3_S量化模型值得关注
本地大模型工具 Strata 又迎来一次更新。这次更新带来了双卡优化,并在官方默认配置中加入了 IQ3_S 量化模型。该模型基于 Astra 实验室推出的 IQ3_S 方案,其参数规模与此前的 27B GSQ 系列有一定可比性,同样采用 IQ3_S 的量化精度。
从作者查看的基准数据来看,IQ3_S 的表现基本接近 BF16 原始精度,这在同类低比特量化中算是相当亮眼的成绩。不过需要留意的是,公布数据中有两项指标存在异常,导致最终的平均分可能偏高、存在一定水分。即便如此,相较于更早的 IQ3_XXS 版本,IQ3_S 的综合表现仍有明显提升。
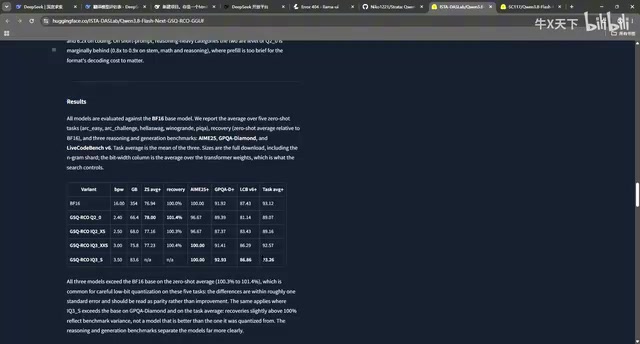
IQ3_S 量化方案背景
IQ3_S 属于"重要性感知量化"(Importance-aware Quantization)系列方案的一种,由 llama.cpp 生态中的 Astra 实验室提出。命名规则中"IQ"代表该系列,数字"3"表示平均每个权重使用约 3 比特存储,后缀"S"(Small)则代表在同等比特数下使用了更精细的分组策略,以减少量化误差。相比同比特数的早期方案 IQ3_XXS(Extra Extra Small),IQ3_S 通过对模型权重按重要性分配不同精度,让关键层保留更高精度,从而在几乎不增加计算复杂度的前提下显著提升模型输出质量。BF16(Brain Float 16)则是原始的半精度浮点格式,通常被视为"精度基准线"——IQ3_S 能接近 BF16 表现,意味着用不到 BF16 约四分之一的存储空间,换取了接近原始精度的推理效果,这正是低比特量化追求的核心目标。
实际案例测试:动画与3D生成效果
为了验证量化模型的真实能力,作者没有停留在跑分层面,而是用几个常见的生成任务做了快速对比。
骑自行车动画(赛博朋克2077风格)
第一个测试是“小人骑自行车”的动画,要求使用赛博朋克 2077 的视觉风格。与此前 IQ3_XXS 的生成结果相比,IQ3_S 在视觉美感和分隔把控上进步明显,画面层次更干净。不过作者也坦言,这一版本在动态表现上似乎缺失了一些元素,但他推测这更可能是单次测试带来的随机波动,而非模型能力退化。
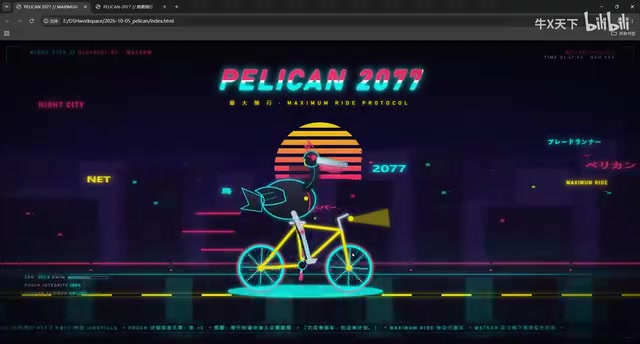
3D骑行与自由女神像测试
在 3D 版本的骑行测试中,小人“蹬得很用力”,视角切换也基本可用,整体观感还算过关。
更复杂的自由女神像测试则更能看出差异。作者认为这一版的整体结构更合理,尤其是底部圆台部分减少了不少 bug,内部的旋转楼梯也有尝试去实现——虽然结构上仍存在问题。此外模型加入了互动选项和年代轴等功能,但部分功能(如从黄铜到青铜的材质渐变过程)出现了明显 bug,没有完整还原设计意图。
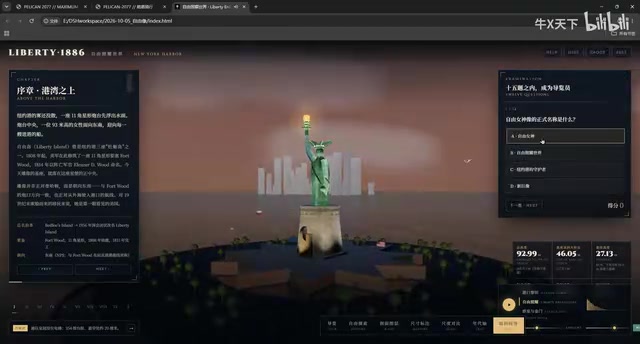
在知识问答环节,IQ3_S 与 IQ3_XXS 的质量差距不算大,但确实能感受到小幅进步。
性能占用实测:内存压力不容忽视
很多用户关心的问题是:更大尺寸的量化模型,对本地计算机的性能消耗究竟有多大?作者在录屏软件会导致模型自动退出的情况下,改用截图方式记录了关键数据。
从结果看,IQ3_S 模型体积比 IQ3_XXS 大了约 7GB,生成速度略慢一些,但在 profile 阶段的速度差异不大,分值输出速度也在可接受范围内。
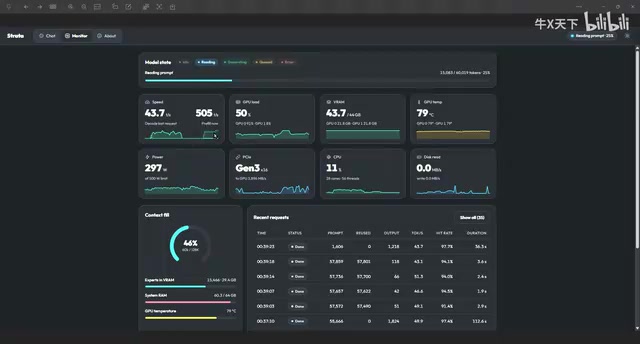
真正的瓶颈在于内存。作者实测该模型在运行时占用约 50 多 GB 内存,而当打开生成的 HTML 并进行调试时,内存占用直接飙升到 62GB。这意味着,如果本地硬件配置有限、启动后内存余量本就不多,再叠加 IQ3_S 的高占用,很容易陷入吃紧状态。一旦项目规模进一步变大变复杂,就有可能触发 OOM(内存溢出),导致程序直接崩溃退出。
OOM(Out of Memory)与本地推理的关系
OOM 即"内存溢出",指程序申请的内存超出系统可用上限,操作系统被迫强制终止进程。在本地运行大语言模型时,模型权重、KV 缓存(用于存储注意力机制的中间状态)以及推理过程中的激活值都需要常驻内存。量化模型虽然显著压缩了权重体积,但当上下文窗口较长或并发任务增多时,KV 缓存会线性增长,极易在权重已占用大量内存的基础上触发 OOM。与服务器端部署不同,本地设备的内存通常无法动态扩展,一旦触及上限,轻则推理中断、重则整个应用崩溃退出,且没有任何自动恢复机制。因此,为本地模型预留足够的"内存余量",是确保长对话或复杂生成任务稳定运行的关键。
总结:进步明确,但量力而行
综合这轮测试,Strata 更新的 IQ3_S 量化模型相比旧版 IQ3_XXS 有切实提升:接近 BF16 的精度表现、更合理的生成结构、更干净的视觉效果,都是加分项。但它也带来了更高的体积和内存开销。
对硬件充裕的用户来说,IQ3_S 是一个值得尝试的升级;而对内存吃紧的设备而言,盲目上更大的量化模型反而可能换来频繁的 OOM。选择哪一版,归根结底还是要看自己的硬件底子。想要更完整的横向对比,可以参考作者此前关于不同量化版本的测试视频。
相关推荐

基于Yggdrasil网络的朋友间分片加密存储:去中心化备份新思路
一个基于Yggdrasil加密覆盖网络的朋友间分片加密存储概念在Hacker News引发关注。本文解读分片、端到端加密与去中心化网络如何结合,构建介于自建NAS与公有云之间的隐私备份新方案,并分析其现实挑战。

MiniCPM-V-4.7-35B-A3B 现身 HuggingFace:MoE 多模态新动向
HuggingFace 平台现身 MiniCPM-V-4.7-35B-A3B 新模型条目,命名暗示其采用总参数 35B、激活 3B 的 MoE 多模态架构。本文解读命名含义与技术趋势,目前模型卡尚未发布。

Devin AI实战全解析:云端AI软件工程师如何独立交付完整项目
基于一次完整实战演示,深度解析Cognition的AI软件工程师Devin AI如何在云端独立构建Agentic RAG系统,涵盖Devin Cloud、计算机使用、自动化、代码审查、安全扫描与Outpost等核心能力。