算子值核统一层次时间序列预测框架

将层次预测建模为向量值RKHS回归,用结构化算子值核让一致性内嵌于模型结构。
本文针对层次时间序列预测中跨层级加和一致性难题,提出将问题统一建模为向量值再生核希尔伯特空间中的多元回归。与两阶段事后调和方法和缺乏理论保证的端到端模型不同,该方法设计结构化算子值核,使假设空间中任意函数的输出自动满足层级加和约束,实现"构造即一致",无需事后修正。论文还推导了超额风险界以刻画泛化性能,并在合成与真实数据集上验证了有效性。文章指出,该思路把一致性从后处理约束转化为模型结构本身,类似于等变神经网络通过架构保证对称性,但核方法在大规模数据上的计算瓶颈及与深度学习的结合仍有待探索。
层次时间序列预测的核心难题在于:不同聚合层级上的预测结果必须保持一致性。例如,集团总营收的预测值,应当等于各子公司预测值之和;各子公司预测值又应当等于其下属业务线预测值之和。这种跨层级的"加和一致"约束,看似简单,却让传统方法陷入两难。
据该研究论文介绍,现有方案大致分为两条路线。一条是两阶段流水线:先在各层级独立预测,再做事后调和(post-hoc reconciliation),强行修正不一致的预测值。另一条是端到端模型,试图一次性输出所有层级的预测,但往往缺乏统计理论保证,泛化性能难以刻画。
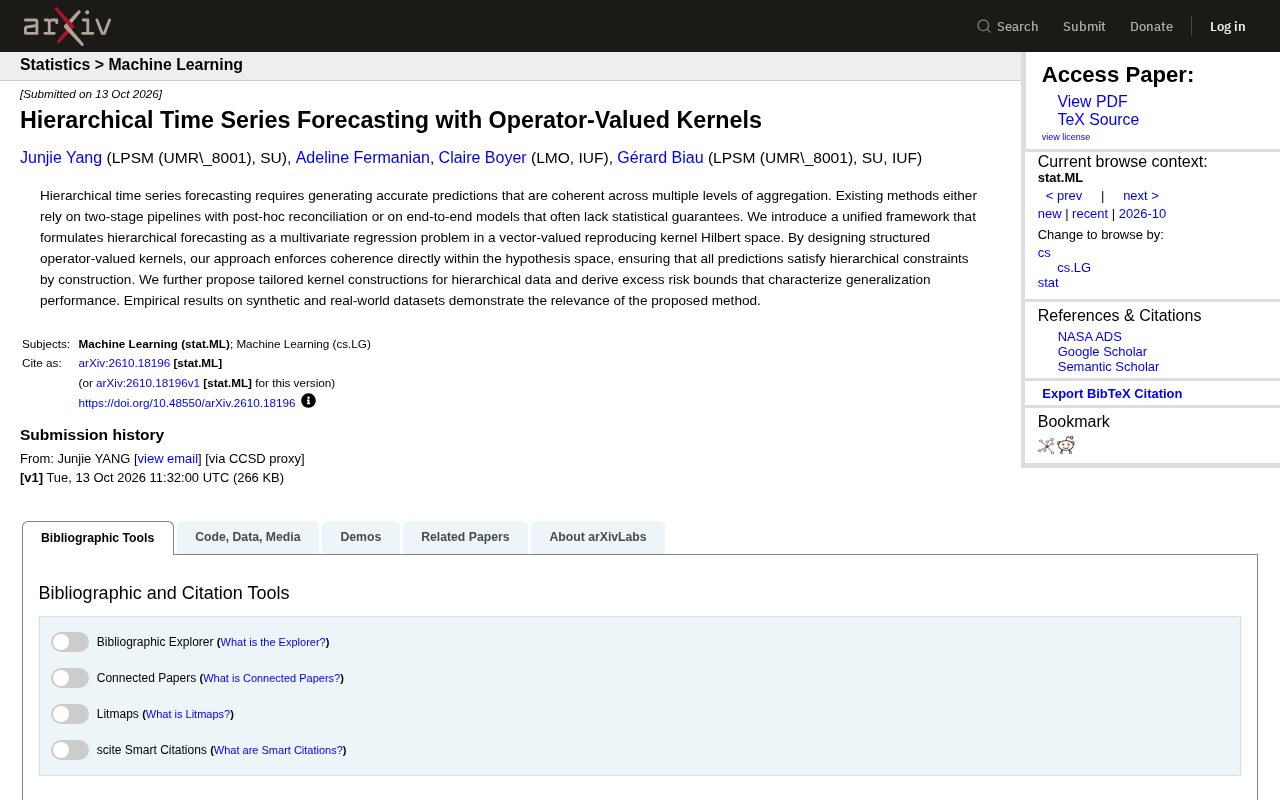
这篇论文提出了一条不同的路径——将层次预测统一建模为向量值再生核希尔伯特空间(vector-valued RKHS)中的多元回归问题,通过设计结构化算子值核(operator-valued kernels),让一致性约束直接内嵌于假设空间之中。
为什么两阶段方法不够好
两阶段方法的问题不只是流程繁琐。独立预测再事后调和,意味着底层预测模型并不知道层级约束的存在,调和步骤本质上是对初始预测的事后修补。这种方法虽然实现简单,但它把"预测"和"一致性"当成两个割裂的目标来优化,调和后的结果未必是全局最优的。
端到端方法试图解决这个割裂问题,但代价是牺牲了理论可解释性。神经网络类的端到端模型可以灵活地学习层级结构,却很难给出泛化误差的界,实践中也难以判断模型何时会失效。
该研究的出发点正是填补这一空白:既要端到端地保证一致性,又要保留核方法的统计学习理论支撑。
层次时间序列预测的经典形式化通常用一组加和约束矩阵来表达。设底层序列为 (\mathbf{y}_t \in \mathbb{R}^{n}),各聚合层级的值可写成 (\mathbf{S}\mathbf{y}_t),其中 (\mathbf{S}) 是按层级组织起来的聚合矩阵。所谓一致性,即要求所有层级的预测 (\hat{\mathbf{y}}_t) 满足 (\mathbf{S}\hat{\mathbf{y}}_t) 与对应层级预测完全吻合,等价于 (\hat{\mathbf{y}}_t) 落在 (\mathbf{S}) 的列空间附近或之中。两阶段方法中的事后调和,常见做法包括自底向上、自顶向下以及基于最小二乘或最小迹的调和(如 MinT),它们本质上是在预测完成后把结果投影回一致子空间。这类投影会改变原始预测的偏差-方差结构,因此并不总能提升精度。理解这一形式化有助于看清本文方法的不同:它不是事后再投影,而是把一致子空间直接编码进假设空间。
算子值核如何保证层级一致性
核心思路是把每个层级上所有节点的预测值看作一个向量,整个层次预测问题就变成了从输入到向量的回归。在向量值RKHS框架下,假设空间中的每个函数天然输出向量,而核函数则是"算子值"的——它不返回标量相似度,而是返回一个矩阵(算子),刻画输出向量各分量之间的关联。
关键在于核的设计。通过构造特定结构的算子值核,可以使得假设空间中任意函数的输出向量都自动满足层次加和约束。换句话说,一致性不是靠训练后修正实现的,而是"构造即成立"(by construction)。论文针对层次数据的特性提出了多种定制化的核构造方案。
这一设计带来的好处是:模型在训练过程中始终在一致预测的空间内搜索最优解,不需要额外的调和步骤,也不依赖松弛约束。
向量值再生核希尔伯特空间与算子值核是理解本文技术路线的关键背景。普通 RKHS 中的函数取值于实数,核函数 (k(x,x')) 返回标量,衡量两个输入样本的相似度;而向量值 RKHS 中的函数取值于 (\mathbb{R}^d),其核函数 (K(x,x')) 返回一个 (d \times d) 的矩阵(即算子),不仅编码样本间相似度,还编码输出各分量之间的相关性。再生性质相应地变为 (\langle f(x), v \rangle = \langle f, K(\cdot, x)v \rangle_{\mathcal{H}})。算子值核必须满足算子值正定性,才能保证对应的 RKHS 存在。本文的巧思在于:通过选择具有特定块结构的 (K),可使假设空间中任意函数的输出向量都落在聚合矩阵的列空间内,从而"构造即一致"。这一思想与多任务学习、结构化输出回归中使用的算子值核一脉相承,但被首次系统性地用于层次预测的一致性保证。
泛化性能的理论保证
除了方法本身,论文还推导了超额风险界(excess risk bounds),用以刻画所提方法的泛化性能。这是端到端深度模型通常无法提供的理论工具。有了超额风险界,研究者可以分析样本量、核函数选择、层级结构复杂度等因素如何影响预测误差的上界。
在合成数据集和真实世界数据集上的实验结果,验证了该方法的有效性。论文摘要指出,实验"展示了所提方法的相关性",说明其在实践中具有一定的适用潜力。
超额风险界衡量的是学习算法得到的预测器与假设空间内最优预测器之间的风险差距,通常由估计误差和逼近误差两部分组成。在核方法中,经典的超额风险界通过 Rademacher 复杂度或覆盖数来刻画,形式往往包含 (O(1/\sqrt{n})) 的样本项和与核范数相关的正则项。向量值 RKHS 的复杂性分析更精细,因为算子值核的范数同时受输出维度和算子结构影响。本文推导的界能让研究者定量地看到:样本量增大时误差如何下降,核的选择如何改变有效复杂度,以及层级结构的深度和宽度如何进入上界。这类界的存在,使得模型选择、正则化参数调节和失效预判都有理论依据,而这是纯端到端深度模型通常难以提供的。
方法的意义与局限
这项工作最值得关注的地方,是把层次预测的一致性需求从"后处理约束"转化为"模型结构本身"。这种思路在机器学习中并不陌生——类似地,等变神经网络通过架构设计保证对称性,而非在损失函数中加惩罚项。算子值核在这里扮演了类似的角色。
不过,核方法在大规模数据上的计算瓶颈是一个现实问题。算子值核涉及矩阵运算,计算复杂度通常高于标量核,当层级结构很深、节点数量很大时,可扩展性可能成为挑战。论文是否讨论了这一点,从摘要中无法判断,有待进一步研读全文确认。
另一个值得追踪的方向是,这套框架能否与深度学习结合。核方法与神经网络的融合已有不少先例(如神经正切核),如果能将算子值核的结构约束思想引入深度层次预测模型,或许能在保持可扩展性的同时获得一致性保证。
相关推荐

农业革命另一面:疾病如何帮农民击败狩猎采集者
历史学者Kyle Harper解读农业社会如何击败狩猎采集者:不仅靠单位土地能量提取效率带来的人口增长优势,还依靠定居生活催生的病原体在扩张中造成额外死亡率,形成双重替代机制。

渐进式披露让Agent提速2.3倍:上下文工程新思路
Hacker News讨论提出用渐进式披露优化AI Agent上下文,实现2.3倍提速。本文解析上下文膨胀的三大性能损耗,介绍分层工具目录、按需检索、历史压缩等实践路径及落地注意事项。
Perplexity Computer 登陆 Mac:本地运行模型与智能体
Perplexity Computer 登陆 Mac:本地运行模型与智能体
Perplexity Computer 现可在 Mac 上完全本地运行,模型与智能体均在设备端执行,支持原生 Mac 应用和本地文件,敏感数据无需上传云端,已在 Perplexity Mac 应用上线。