Swift Qwen3.8 27B 破10万下载:高效思考如何砍掉58%的Token
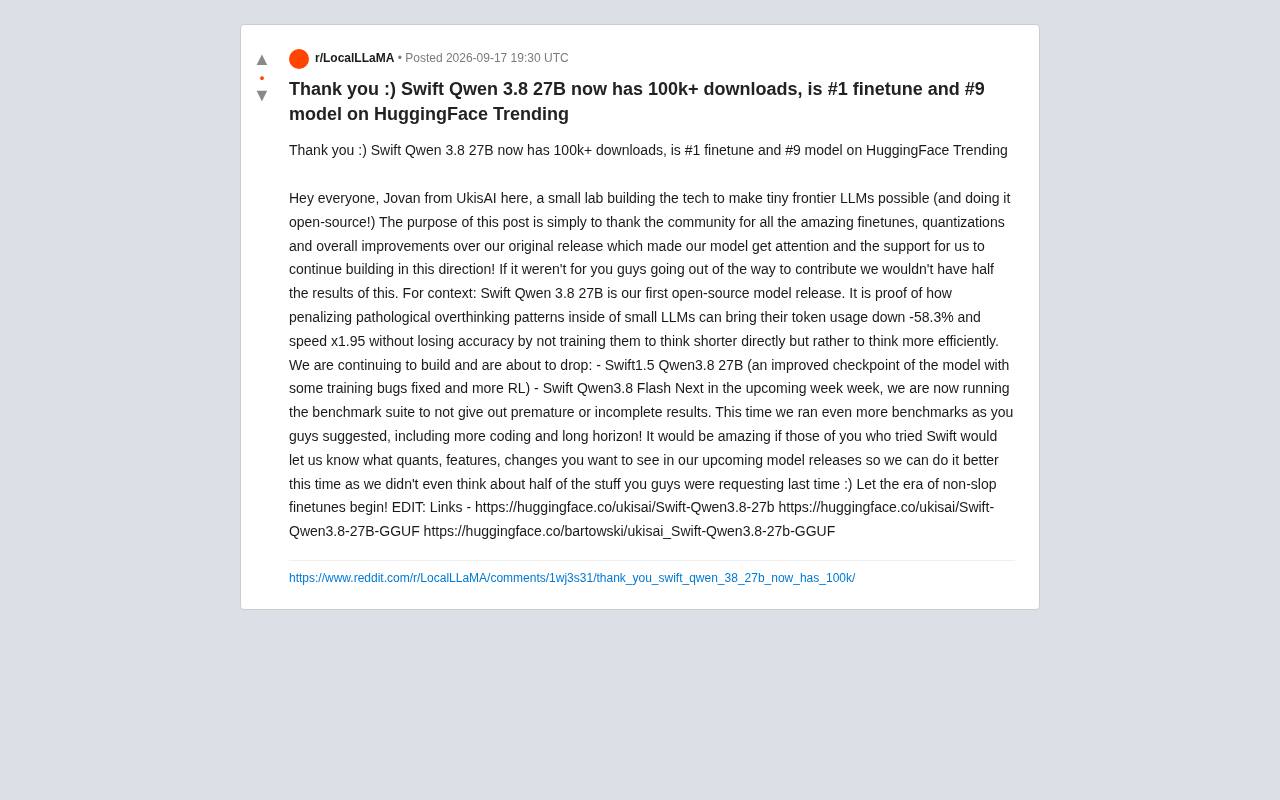
小实验室开源模型Swift Qwen3.8 27B凭借「高效思考」训练策略减少58%token消耗,下载破10万登顶HuggingFace微调榜。
来自UkisAI的开发者Jovan发布的Swift Qwen3.8 27B在HuggingFace上下载量突破10万,登上微调模型榜首。该模型的核心创新在于针对推理模型「过度思考」的痼疾,选择训练模型「更高效地思考」而非直接压缩思考长度,最终实现token用量下降58.3%、推理速度提升1.95倍且准确率不降。模型的走红也高度依赖社区生态:量化贡献者bartowski发布了配套GGUF版本,社区还自发提出了编程能力和长程任务的评测需求,推动团队扩充了基准测试覆盖面。后续两个新版本(Swift1.5和Swift Flash Next)已在规划中,团队坚持「测完再发」的克制态度,体现出对质量优先于抢发的承诺。
开源大模型社区又出了一个值得关注的案例。来自小型实验室 UkisAI 的开发者 Jovan 在 Reddit 上宣布,其首个开源模型 Swift Qwen3.8 27B 下载量已突破 10 万次,登上 HuggingFace Trending 榜单微调模型第一名、综合模型第九名。
这个成绩背后,是一个针对小型 LLM「病态过度思考」(pathological overthinking)问题的技术尝试,也折射出当前开源社区在推理效率优化上的探索方向。
核心突破:不是让模型少想,而是让它想得更聪明
Swift Qwen3.8 27B 最值得说道的,是它解决问题的思路。当下的推理模型(reasoning model)普遍存在一个通病:为了给出答案,会生成大量冗余的思考链(chain-of-thought),消耗过多 token,拖慢响应速度。
很多优化方案的做法很直接——训练模型「想得更短」。但 UkisAI 选择了一条不同的路:不直接训练模型缩短思考,而是训练它更高效地思考。
据 Jovan 披露的数据,这种方法带来的收益相当可观:token 使用量下降 58.3%,推理速度提升 1.95 倍,而且准确率没有损失。换句话说,模型依然保持了完整的推理能力,只是砍掉了那些无意义的自我怀疑、反复兜圈的「思维内耗」。
对于本地部署和资源受限的场景,这个思路尤其有价值。27B 参数量本身就属于「可在消费级硬件上跑」的甜蜜区间,再叠加近六成的 token 削减,实际使用成本和延迟都会明显下降。
「思维链」(Chain-of-Thought,CoT)是让大模型在给出最终答案前,先逐步输出推理过程的技术范式,由 Google 在 2022 年的论文中系统提出。研究表明,CoT 能显著提升模型在数学、逻辑和多步骤任务上的准确率。然而,随着 DeepSeek-R1、Qwen3 等「推理模型」将思维链训练推向极致,一个副作用随之浮现:模型会养成反复自我验证、频繁回溯结论、在显然无需深思的简单问题上也大量输出内心独白的习惯,俗称「overthinking」。这类冗余 token 既不贡献准确率,又直接拉高推理延迟和 API 费用,在本地部署场景下尤其明显——每次请求多消耗数百乃至数千个 token,对显存带宽和 KV Cache 都是额外压力。Swift Qwen3.8 的核心贡献,正是通过专项训练区分「有效推理步骤」与「无意义内耗」,在不截断思考深度的前提下消除后者。
社区共建:一次典型的开源正反馈
Jovan 这篇帖子的主要目的其实是「致谢」。他坦言,如果没有社区自发贡献的各种微调、量化和改进,这个模型不可能获得现在的关注度和成绩。
这是开源生态运转的经典模式。原始模型发布后,社区成员会围绕它做量化(如 GGUF 格式)、优化推理性能、补充测试。知名量化贡献者 bartowski 也发布了对应的 GGUF 版本,进一步降低了普通用户的使用门槛。
Jovan 特别提到,社区提出的很多需求是团队自己「压根没想到」的,比如更多的编程能力和长程任务(long horizon)基准测试。这也说明,一个模型能否走远,很大程度上取决于它能不能与社区形成有效的反馈闭环。
GGUF(GPT-Generated Unified Format)是由 llama.cpp 项目引入的模型文件格式,专为在 CPU 及消费级 GPU 上高效运行而设计。它将模型权重、分词器配置和元数据打包进单一文件,并支持 Q4_K_M、Q5_K_S 等多种量化精度,使一个 27B 参数的模型可以在 16-24GB 显存的普通显卡甚至高内存 CPU 机器上运行。bartowski 是 HuggingFace 社区知名的量化贡献者,长期义务为热门开源模型提供高质量 GGUF 转换,其发布的量化版本因测试严格、精度损失小而受到本地部署用户的广泛信任。他为 Swift Qwen3.8 发布配套 GGUF,意味着该模型立刻具备了面向更广泛硬件环境的可用性,这是开源生态中「社区量化」降低使用门槛的典型路径。
后续规划:两个新版本即将发布
根据帖子内容,UkisAI 正在推进两个新版本:
- Swift1.5 Qwen3.8 27B:现有模型的改进检查点,修复了一些训练中的 bug,并加入了更多强化学习(RL)训练。
- Swift Qwen3.8 Flash Next:预计在未来一周内发布,团队目前正在跑完整的基准测试套件,强调不会给出「不成熟或不完整」的结果。
值得肯定的是,这次团队按社区建议扩充了评测范围,加入了更多编程和长程任务的基准。这种「先测全再发布」的克制态度,在如今争相刷榜、抢发的模型竞赛中并不多见。
如何获取
模型和量化版本均已在 HuggingFace 开放下载:
- 原始模型:
huggingface.co/ukisai/Swift-Qwen3.8-27b - 官方 GGUF:
huggingface.co/ukisai/Swift-Qwen3.8-27B-GGUF - bartowski GGUF:
huggingface.co/bartowski/ukisai_Swift-Qwen3.8-27b-GGUF
小结:小模型的效率战场
Swift Qwen3.8 27B 的走红,反映出开源社区对「小而精」模型的持续热情。在参数军备竞赛之外,如何在有限规模下压榨出更高效率,正成为一个越来越重要的方向。
「惩罚过度思考」这个切入点未必是全新概念,但用一个真实发布、被十万次下载验证过的模型把效果量化出来,本身就有参考意义。Jovan 那句「让非注水微调的时代开始吧(Let the era of non-slop finetunes begin)」,也算是给这个方向定了个基调——比起追求更大更炫的参数,社区其实更需要扎实、可用、不浪费算力的模型。
相关推荐
Opus 5的道德边界:从拒绝到"恐怖主题项目"的绕行实验
一位开发者用Claude Opus 5开发果蝇隐喻项目时,因措辞被拒后改称"恐怖主题项目"成功绕行。本文剖析大模型内容审核对表层语义的依赖及其对AI安全与人机协作的启示。
语音AI在真实呼叫中心场景下真的靠谱吗?
语音AI真的能应对真实呼叫中心的抢话、改口和噪音吗?本文从技术边界、演示陷阱和人机协同角度,分析Voice AI在真实压力场景下的可靠性与评估方法。
AI安全之争:是为了安全,还是为了控制权?
Anthropic CEO Amodei呼吁全球协调应对AI安全,但这一主张引发争议:AI安全辩论究竟是为了安全,还是为了争夺技术控制权?本文剖析这场辩论背后的权力博弈与治理困境。