TestSprite 4.0:终结“修一个坏一个”的AI测试智能体
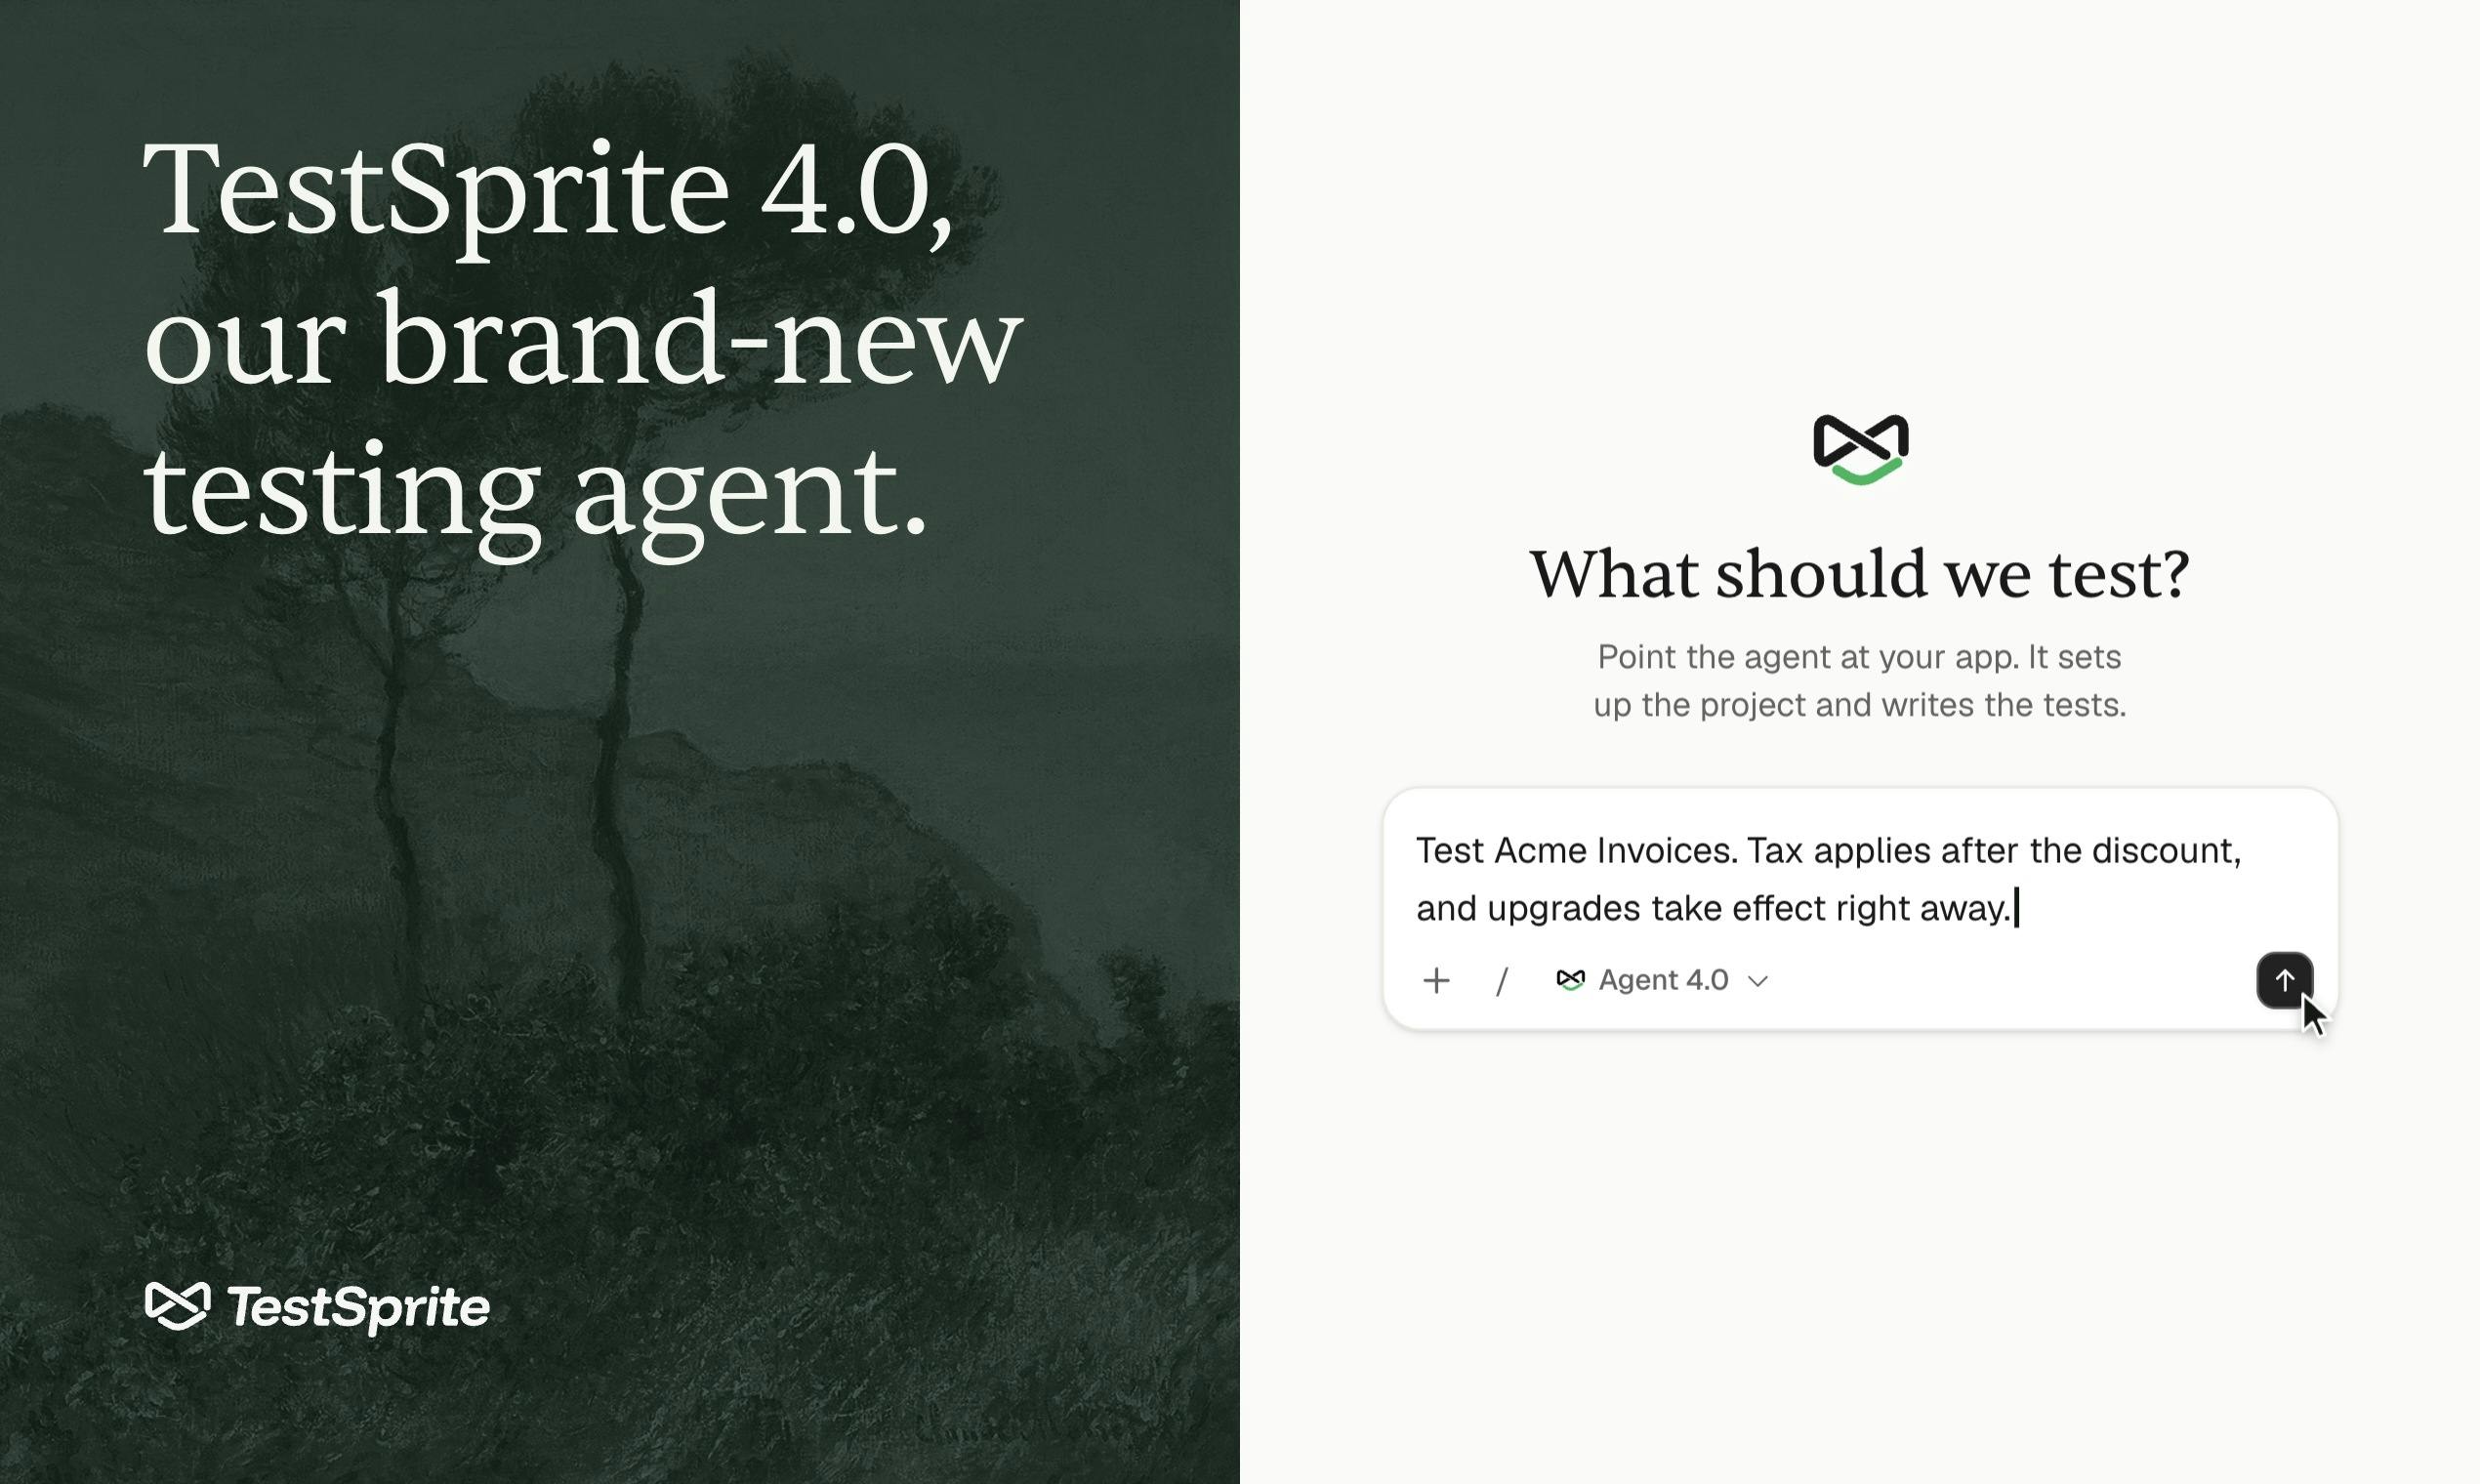
TestSprite 4.0用自然语言驱动的测试智能体,为AI编程补上回归测试防线。
TestSprite 4.0是一款登上Product Hunt当日榜首的AI测试智能体,针对AI编程助手“修一个坏一个”的回归痛点。它能记住应用应有的行为,在每次变更后检查所有相关功能。用户只需用自然语言描述测试需求,智能体便自动探索运行中的应用、编写并执行端到端测试,还会分析失败原因、判断哪些是真实bug。产品支持Web界面、终端与Pull Request等多环境集成,使测试贯穿编码、提交与审查全流程。文章肯定其降低E2E测试编写维护成本的潜力,但也指出其探索覆盖率、bug判定准确性及与Playwright、Cypress等现有框架的协同关系仍待市场验证。
TestSprite 4.0:终结“修一个坏一个”的AI测试智能体
在AI编程助手日益普及的今天,一个尴尬的现实是:你的编码智能体刚修复了一个bug,却可能在不经意间破坏了另一个功能。这种“修一个坏一个”的循环,正是TestSprite 4.0想要解决的问题。这款在Product Hunt上以145票登顶当日榜首的测试智能体,宣称能记住应用应有的行为,并在每次变更后全面检查,让AI生成的代码真正可靠。
从“修一个坏一个”说起:AI编程的回归痛点
如果你使用过GitHub Copilot、Cursor等AI编程工具,可能会遇到这样的情况:让AI修复一个函数,它确实修好了,但另一个依赖该函数的模块却悄然失效。原因在于,AI编码智能体通常只关注局部任务,缺乏对应用整体行为的记忆和验证。
TestSprite 4.0的诞生正是针对这一痛点。据其Product Hunt页面描述,它是一个“全新的测试智能体”,能够记住你的应用应该做什么,并在每次变更后检查所有相关行为。这相当于为AI编程流程增加了一道自动化的回归测试防线。
回归测试(Regression Testing) 是指在软件修改后重新运行既有测试用例,以确认改动没有破坏原有功能的测试活动。它与“新功能测试”相对,关注的是“旧行为是否仍然正确”。在传统开发中,回归测试通常由CI流水线在每次提交后自动触发;但在AI编码场景下,由于智能体每次只针对局部任务生成补丁,缺乏对全局行为的显式建模,回归问题更容易被引入且不易被察觉。TestSprite 4.0所强调的“记住应用应有的行为”,本质上就是把回归测试的基线从人工维护的用例集,转变为由智能体持续维护的行为契约。
用自然语言驱动测试:TestSprite 4.0如何工作
TestSprite 4.0的核心交互方式非常直观:你只需要用平实的语言告诉它要测试什么。例如,“用户登录后应该能看到个人资料页”或“添加商品到购物车后总价应更新”。随后,智能体会自动探索正在运行的应用,编写并执行端到端测试。
更关键的是,它不只是运行测试,还会分析失败原因,并告诉你哪些失败是真正的bug。这意味着开发者无需手动筛选测试报告,可以直接聚焦于需要修复的问题。这种“探索-编写-执行-分析”的闭环,将测试从一项繁琐的手工任务转变为由智能体驱动的自动化流程。
端到端测试(End-to-End Testing,E2E) 指从用户视角出发、贯穿完整业务流程的测试方式,例如“打开页面→登录→进入个人中心→校验信息展示”。与单元测试只验证单个函数不同,E2E测试会真实驱动浏览器或客户端,覆盖前端、后端与数据层的协同。其优势是贴近真实使用场景,缺点是编写和维护成本高、执行速度慢、失败定位困难。TestSprite 4.0用自然语言描述需求、再由智能体自动生成并执行E2E测试,正是试图压低这一环节的门槛;而它“分析失败原因、判断是否为真实bug”的能力,则对应E2E测试中最耗人力的失败归因环节。
全流程覆盖:从终端到PR的无缝集成
TestSprite 4.0的另一个亮点是它的集成能力。据官方介绍,它可以在Web界面、终端或你的Pull Request中持续检查每一次变更。这意味着无论你是在本地开发、通过CI/CD流水线,还是在代码审查阶段,TestSprite都能介入并执行测试。
这种全流程覆盖的设计,让测试不再是开发流程末尾的孤岛,而是贯穿于编码、提交、审查的每个环节。对于团队协作而言,这有助于在早期发现回归问题,降低修复成本。Product Hunt上145票的支持和17条评论,也反映出开发者对这类工具的浓厚兴趣。
多源视角:测试智能体的价值与局限
虽然TestSprite 4.0在Product Hunt上获得了不错的关注度,但作为一款新产品,其实际效果仍需市场检验。从官方描述来看,它强调“记住应用应有的行为”和“用自然语言指定测试”,这两点如果实现得当,将显著降低端到端测试的编写和维护成本。
不过,测试智能体的有效性很大程度上取决于其探索应用的覆盖率和bug判定的准确性。目前官方未披露具体的技术细节和性能指标,开发者社区也在观望其实际表现。此外,测试智能体与现有测试框架(如Playwright、Cypress)的协同关系,也是值得关注的问题。
文中提到的 Playwright 与 Cypress 是目前主流的两款Web端到端测试框架。Playwright由微软维护,支持Chromium、Firefox、WebKit多浏览器引擎,擅长跨浏览器与多标签页场景;Cypress则以开发者体验见长,提供实时重载与时间旅行调试,但早期在跨域和多标签页上受限。二者都要求开发者手写选择器与断言逻辑。TestSprite这类测试智能体与它们并非简单替代关系:智能体可能底层调用这些框架执行测试,也可能自建驱动层。对团队而言,关键问题是智能体产出的测试能否导出为可读的Playwright/Cypress脚本、能否纳入既有CI资产,否则容易形成新的工具孤岛。
谁适合使用TestSprite 4.0?
从产品定位来看,TestSprite 4.0主要面向使用AI编码智能体的开发者和团队。如果你经常让AI助手修改代码,并担心引入回归问题,这款工具可以提供自动化的回归测试保障。同时,对于希望减少手动编写端到端测试工作量的团队,自然语言驱动的测试方式也颇具吸引力。
目前TestSprite 4.0已在Product Hunt上线,并提供了官网链接供进一步了解。随着AI编程的普及,测试智能体或许会成为开发工具链中不可或缺的一环。至于它能否真正终结“修一个坏一个”的循环,还需要在实际项目中验证。
相关推荐
Anthropic冲击1.4万亿美元IPO:营收狂飙与算力豪赌
Anthropic以最高1.4万亿美元估值冲刺IPO,营收从4100万美元飙升至单季170亿美元,但8950亿美元算力承诺与未经验证的利润率构成巨大风险。本文拆解其业务、财务与IPO定价逻辑。
Anthropic冲击1.4万亿美元IPO:4000亿算力账单暗藏双向陷阱
Anthropic以1.4万亿美元估值冲刺史上最大IPO,招股书却暴露超4000亿美元长期算力承诺与按token计费收入之间的期限错配。本文拆解第三季度算力占比、现金流期限、博通融资条款与多空双方的核心分歧。
Anthropic IPO前夜:万亿估值背后的五重风险与治理真相
拆解Anthropic IPO招股书:万亿估值下每日1.84亿美元营收、1040亿账面亏损真相、五类股份的治理结构、94页风险因素中的非常规披露,以及解禁时间表对散户的潜在影响。