ThinkWorld:用世界想象强化动态链推理的VLA框架
ThinkWorld 用动态链锚定世界动态,借助世界想象强化从无标注视频中学习 VLA。
ThinkWorld 是一个面向视觉-语言-动作(VLA)模型的学习框架,旨在缓解动作标注机器人数据稀缺导致的泛化瓶颈。其核心是将每个动作思考表示为动态链(CoD)——一串离散运动 token,描述从当前世界状态到未来状态的中间动态,并作为一种跨具身的通用动作表示。训练时先用动作标注演示初始化 CoD,再让模型预测每个 CoD 诱导的未来状态,并通过强化学习提升那些预测与实际观察更匹配的 CoD。这一“世界想象”机制使无动作标注的人类视频也能通过状态转移提供直接监督,让人类视频与机器人经验在同一推理空间相互增强。仿真与真实机器人实验验证了从人类到机器人的技能迁移及对未见任务与环境的泛化能力。
视觉-语言-动作(VLA)模型在机器人操作领域取得了显著进展,但其泛化能力仍受限于动作标注机器人演示数据的多样性与覆盖范围。人类视频提供了更广泛的行为与环境经验,然而从这些视频中学习面临一个根本性权衡:可扩展的数据量与显式的动作 grounding 难以兼得。为此,研究者提出 ThinkWorld——一个将动作推理建立在世界动态之上,并通过世界想象强化学习来增强推理的 VLA 学习框架。
据 RSS 源介绍,ThinkWorld 的核心创新在于将每个动作思考表示为动态链(Chain-of-Dynamics, CoD),即一串离散的运动 token 序列,捕捉从当前世界到未来状态的中间动态,并作为跨具身(embodiment)的通用动作表示。该框架首先用动作标注演示初始化 CoD,然后预测每个 CoD 所诱导的未来状态,并对那些预测更匹配实际观察结果的 CoD 进行强化。这使得没有动作标注的视频也能通过观察到的状态转移提供直接监督,从而让人类视频和机器人经验在同一个推理空间中得到精炼。
背景:VLA 模型的泛化瓶颈
当前 VLA 模型依赖大量动作标注的机器人演示数据,但这类数据的采集成本高昂且覆盖面有限。人类视频虽然海量且包含丰富的行为模式,却缺少与机器人动作的直接对应关系。如何在利用无动作标注视频的同时保持可扩展的动作推理能力,成为提升 VLA 泛化性的关键挑战。ThinkWorld 正是针对这一痛点,试图弥合人类视频与机器人动作之间的鸿沟。
VLA 模型(Vision-Language-Action Model)是一类将视觉感知、语言理解和动作生成统一建模的机器人学习架构。典型做法是以预训练视觉-语言模型(如 CLIP、LLaVA 等)为骨干,将图像观测与任务指令编码为多模态表征,再通过动作解码头输出机器人控制信号(关节位置、末端位姿或离散动作 token)。其优势在于能借助大规模图文预训练获得语义泛化能力,但对动作监督信号高度依赖。
动作标注(action annotation) 指为视频中的每一帧提供与机器人控制空间对应的动作标签,通常需遥操作采集或动捕系统记录。这类标注成本高、跨具身不可直接复用,正是限制 VLA 数据规模的核心瓶颈。
核心方法:动态链(CoD)与世界想象强化
ThinkWorld 将动作推理抽象为动态链(CoD)——由离散运动 token 组成的序列,描述从当前世界状态到未来状态的中间动态变化。这种表示不依赖于特定具身形态,因此可作为人类和机器人共享的动作语言。
训练过程分为两步:首先用动作标注的机器人演示数据初始化 CoD 生成能力;随后,模型对每个 CoD 预测其诱导的未来状态,并将预测结果与真实观察进行对比,利用强化学习提升那些预测更准确的 CoD 的生成概率。这种“世界想象”机制使得无动作标注的视频也能通过状态转移提供监督信号,从而将人类视频纳入同一推理空间的训练中。
跨具身表示(cross-embodiment representation) 是机器人学习中的重要研究方向,目标是找到一种不绑定于特定机械臂结构、自由度或相机配置的动作抽象,使不同来源的数据(人类手部动作、不同型号机器人、仿真器)可以共享同一学习信号。常见做法包括将动作映射到末端执行器轨迹、关键点运动或离散化的运动基元。ThinkWorld 的 CoD 属于离散运动 token 路线,其跨具身性来自“描述世界状态如何变化”而非“描述某个具体关节如何转动”。
世界模型(world model) 指学习环境状态转移规律的预测模型,给定当前状态与动作,预测下一时刻的观测或隐状态。ThinkWorld 中的“世界想象”即利用这类预测能力作为评判器:候选 CoD 若能诱导出与真实视频观察一致的状态预测,就被视为更合理的动作推理。这种以预测一致性替代动作标签的思路,本质上是用状态转移监督替代动作监督。
文章提到的“强化那些预测更匹配实际观察结果的 CoD”通常借助强化学习中的策略优化实现,例如以预测误差的负值作为奖励,采用 REINFORCE 或偏好优化类目标提升高奖励序列的生成概率。相比监督学习需要逐 token 的正确标签,这类方法只需对整条序列给出可比较的评分,因此天然适配无动作标注视频——视频本身提供了“结果是什么”,模型只需判断自己设想的中间动态能否导向该结果。
实验验证:人类到机器人的迁移与泛化
在仿真环境和真实机器人上的实验表明,ThinkWorld 能够有效实现从人类视频到机器人的技能迁移,并对未见过的任务和环境展现出较强的泛化能力。这一结果支持了将动作推理建立在世界动态之上、并通过想象强化来提升推理质量的思路。
意义与展望
ThinkWorld 提供了一种统一框架,让人类和机器人经验在同一个动态链推理空间中相互增强。通过世界想象强化,模型能够从更广泛的无标注视频中学习,有望缓解 VLA 模型对动作标注数据的依赖,推动机器人操作向更通用的方向演进。
相关推荐
VCP V工程实测:Token缓存95%命中,AI控制AI螺旋编程
VCP V工程实测:单轮对话Token缓存命中率95%以上,用AI控制AI实现螺旋编程,主控Agent策划、施工Agent写码,已策划工程可完全脱手。附完整配置步骤与局限分析。
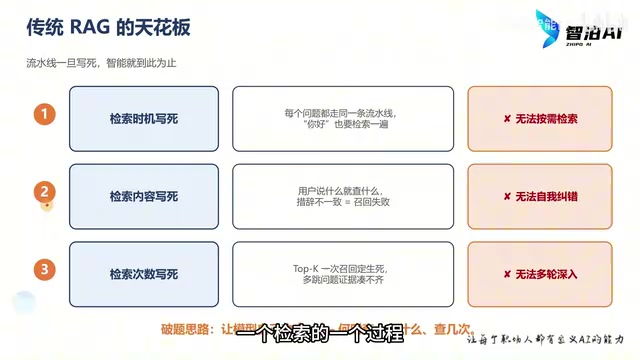
Agentic RAG实战:从原理到代码,手把手搭建智能检索系统
传统RAG检索时机、内容、次数全部写死,导致答非所问。本文基于B站教程拆解Agentic RAG原理:将检索封装为工具交给大模型自主决策,附四工具设计与完整代码实现,手把手搭建能自我纠错、多跳查询的智能检索系统。
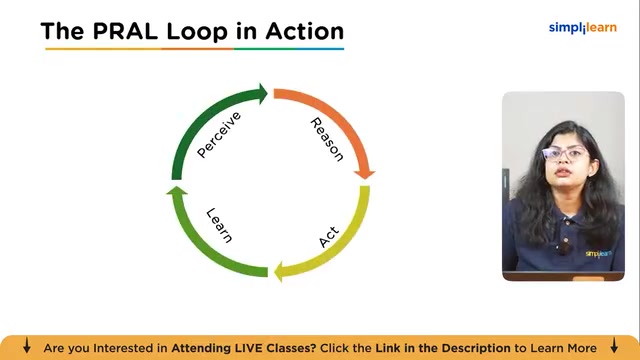
1小时搞懂Agentic AI:架构、设计模式与实战搭建
Simplilearn的Agentic AI速成课程解析:智能体三层架构(感知、认知、动作)、单智能体与多智能体对比、感知推理执行学习循环、三种设计模式,以及研究智能体、应用构建和反馈修复循环的实战演示。