提示词工程从入门到实战:核心概念与局限性解析

提示词是控制AI的直接手段,提示词工程则是让其稳定产出可用结果的方法论。
文章基于B站一套提示词工程教程的第一课,厘清了提示词与提示词工程的区别。提示词是发给AI的任何文字指令,作用体现在沟通桥梁、任务导航、风格控制和边界约束四个层面,但它是单次的,不存在万能提示词。提示词工程则是一套不修改模型参数、只通过设计输入让AI稳定输出结果的六步流程:需求拆解、设计方案、执行测试、评估效果、策略迭代、沉淀复用,目标为提升准确性、减少幻觉、增强稳定性和降低成本。文章还强调其低门槛高杠杆的价值,并系统梳理了能力上限、输出不稳定、幻觉、上下文长度、复杂任务、长期记忆等技术局限,以及安全误拦、难以工程化、token成本等落地陷阱。
很多人以为提示词就是给AI发消息,但B站上一套系统讲解提示词工程的教程给出了不同的答案:提示词是你控制AI最直接的手段,而提示词工程则是一套让AI稳定产出可用结果的方法论。这篇文章基于该教程第一课的内容,梳理提示词的本质、提示词工程的工作流程,以及那些常被忽略的局限性。
提示词是什么:不只是“发消息”
教程对提示词的定义很朴素:你给AI的任何文字指令,无论是问题还是描述,都叫提示词。但它用了一个更形象的说法——提示词就像发给AI的“神经元信号”,你发什么信号,AI就往哪个方向思考。
同一个AI,有人只能让它写小学生作文,有人却能拿到专业的行业报告。差别不在模型本身,而在输入的指令。教程把提示词的作用拆成四个层面:
- 沟通桥梁:把脑子里模糊的需求翻译成AI能听懂的明确指令。就像点外卖不能只说“来份吃的”,得说清楚菜品、辣度、要不要加饭。
- 任务导航:告诉AI具体要做什么。“帮我处理一下这份文件”是无效指令,AI不知道是做统计分析、可视化还是写总结,只能随便选一个。
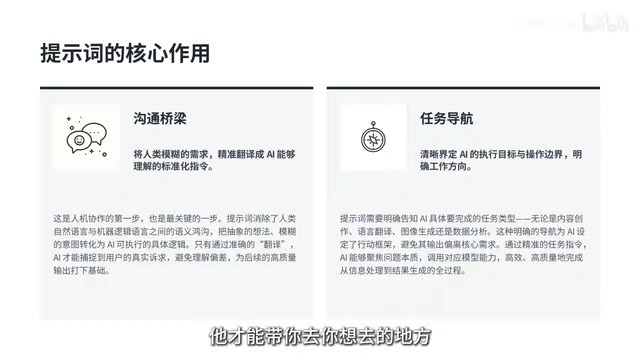
- 风格控制:同一个话题,商务邮件和朋友圈文案的风格完全不同。通过提示词可以让AI模仿特定风格,减少后期修改量。
- 边界约束:对抗AI“胡说八道”最有效的方法之一。明确告诉AI什么能说、什么不能说,输出会更聚焦。
教程给了一个直观对比:基础提示词“写一篇关于春天的文章”太宽泛——南方还是北方、散文还是序文、多长、什么风格,AI只能瞎猜,结果千篇一律。优化后的版本先设定身份(散文作家)、字数(800字)、场景(江南的春天)、风格(语言优美、抒情、着重写烟雨朦胧的水乡意境),模糊要求就变成了可执行的规则。
提示词 vs. 提示词工程:单次技巧与系统方法
这是教程反复强调的区分。提示词是单次的,像写一行代码执行一次,换个问题可能就不好用了。教程直接点破:“很多人说我有一个万能提示词,那都是骗人的,没有万能的提示词,只有适合特定场景的提示词。”
提示词工程则是一套完整流程,不修改AI本身的代码和参数,只通过设计输入指令让AI稳定输出想要的结果。
 它靠方法而非灵感,解决的不是一个问题而是一类问题。教程给出的六步流程是:需求拆解(把大问题拆成AI能解决的小问题)、设计方案(设计对应提示词和角色)、执行测试、评估效果(用具体标准判断结果好坏)、策略迭代、沉淀复用(保存好方案供类似问题直接使用)。这套流程和软件开发很像,只不过写的不是代码而是自然语言。
做提示词工程的四个目标,也构成了评价方案好坏的标准:提升准确性、减少幻觉、增强稳定性(谁用、什么时候用结果都差不多)、降低成本(用最少的token拿到最好的效果)。
幻觉指大模型生成看似合理、实则与事实不符或无中生有的内容。它源于模型的概率生成机制:模型是在预测下一个最可能的 token,而不是在检索事实数据库,因此语气越自信的内容未必越可靠。常见缓解手段包括提供参考资料、要求标注不确定之处、限定回答范围,但这些只能降低发生概率,无法根除。涉及数据、引用、法规等关键信息时,人工核验仍是必要环节。
为什么现在要学:低门槛与高杠杆
教程引用了一个数据:超过90%的用户只会用AI做基础问答。它打了个比方——买了一辆跑车却只会用一档开。
提示词工程的门槛极低,不需要会编程或懂算法,只要会说话、能把事情说清楚就能学。学完最直接的好处是效率提升:原来需要一天做的事可能一小时完成,还能处理专业报告、复杂数据分析等原来AI搞不定的任务。
 商业价值方面,教程列举了几个方向:帮企业和自媒体优化提示词或用AI生成内容做副业;一个人用AI完成原来一个团队的工作,降低创业试错成本;自媒体创作者从一个月写10篇变成写几十篇,快速积累粉丝。
提示词的局限性:不是万能钥匙
教程用相当篇幅讲局限性,这是很多入门内容会跳过的部分。
能力上限无法突破。 AI训练数据有截止时间,问它截止之后的事情它不知道;再复杂的数学题,再怎么优化提示词也算不出来。
输出不稳定。 改一个字结果可能完全不同;提示词太长AI会“忘事”,前面说的话后面不记得。
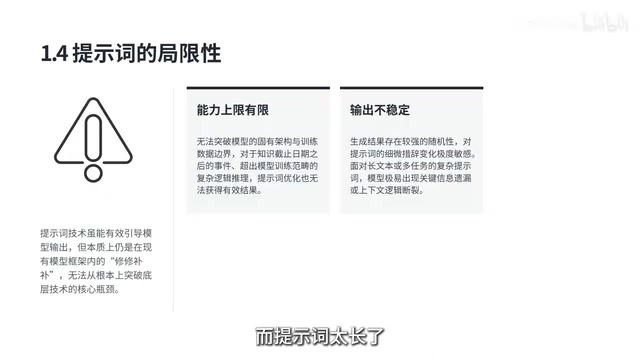 幻觉只能减少不能消除。 只要是大模型就一定会编瞎话,涉及重要事情必须自己核实。
技术层面还有三个硬约束:上下文长度受限,像手机运行内存,开太多软件会清理后台;多步骤的复杂任务容易跳步骤、断逻辑,必须先拆成小任务;没有真正的长期记忆,每次对话都是全新的,记不住用户偏好和之前背景,只能靠额外数据库解决。教程的结论是,这三个问题由技术底层决定,提示词只能优化缓解,不能根治。
落地层面同样有三个坑。一是安全与对齐限制:违法违规内容绝对生成不了,但完全合法的需求也可能被误判拦截。二是纯提示词无法工程化:自己用没问题,做成产品给几百上千人用就不行了,没法做版本管理、问题回溯,也扛不住大规模批量任务,企业级应用一定是提示词加代码结合。三是成本陷阱:AI按token收费,提示词越长越贵,高频调用时隐性成本高得吓人。
这套教程的价值在于,它在讲“怎么做”之前先把“是什么”和“不是什么”讲清楚。对刚接触AI应用的人来说,建立一个包含局限性的正确认知,比收藏一堆所谓“万能提示词”更有用。
上下文长度指模型单次能处理的最大文本量(通常以 token 计)。你可以把它理解为模型的“工作记忆”:对话、文档、指令都占用这个额度,超出后最早的内容会被截断或遗忘,这就是文中“提示词太长 AI 会忘事”的直接原因。不同模型的上下文窗口差异很大,从几千到上百万 token 不等,但无论多大,都不是无限记忆,长文档任务仍需分段处理或借助外部检索。
Token 是大模型处理文本的基本单位,可粗略理解为“词片”,一个汉字通常占 1 到 2 个 token,英文单词常被拆成多个 token。API 按输入和输出的 token 总量计费,因此提示词越长、调用越频繁,成本越高。这也是文中把“用最少 token 拿到最好效果”列为提示词工程目标之一的原因。
相关推荐
 科技前沿
Textly:Mac上任意位置抓取文字和表格的效率神器
Textly是一款Mac菜单栏效率工具,支持从截图、PDF、视频和应用中框选捕获文字与表格,保持行列完整并导出CSV、Markdown、TSV,还内置即时翻译和剪贴板历史。
 科技前沿
Frameboy:World Labs Atlas 世界模型浏览器实时体验
World Labs 在 Product Hunt 发布 Frameboy,基于 Atlas 世界模型的浏览器实时演示,移动相机即可在云端 GPU 生成新视角,最高 15 fps 串流,探索 AI 生成的可漫游世界。
 科技前沿
Keypause:一键锁定Mac键盘,清洁时不再误触
Keypause是一款Mac菜单栏应用,一键锁定键盘所有按键,方便清洁时避免误触。本文介绍其功能、使用体验、潜在风险及适用场景,帮你判断是否值得尝试。