提示词工程实战指南:从模型选型到五大黄金原则

提示词是用自然语言为大模型编程,需按模型类型调整策略,遵循五大原则。
文章系统梳理了提示词工程的核心方法论。首先明确提示词的本质是用自然语言对大模型进行编程,通过精准语义引导提升输出质量、降低幻觉。其次回顾了OpenAI六大策略,指出策略稳定但实现手段在演进,如Few-Shot和MCP。核心变化在于模型架构:2026年主流模型已从推理/通用双产品线转向统一架构加自适应推理,提示词策略随之分野——推理模型应简洁聚焦目标,通用模型需显式COT和角色扮演。最后给出高质量提示词五大原则:具体不模糊、上下文完整、语义无歧义、逻辑连贯、简洁不冗余,强调提示词优化是性价比最高的模型提效手段。
在大模型能力快速迭代的今天,提示词工程(Prompt Engineering)的价值并未消退,反而因为模型架构的演进变得更加微妙。B站UP主的这期教程系统梳理了提示词的核心概念、模型选型策略以及高质量提示词的构建原则,全程干货。本文在此基础上做了延伸分析,帮助读者建立一套可落地的提示词工程方法论。
什么是提示词:用自然语言为大模型编程
提示词就是你发给模型的那段话。这个定义听起来简单,但它背后有一个深刻的本质:提示词是用自然语言对大模型进行编程——这里的"编程"是打引号的,它不同于用Python或Java写代码,而是通过精准的语义引导来激发模型能力、降低幻觉、稳定输出。
提示词的目的是为模型提供任务上下文,让模型更准确地理解用户意图。一个简单的任务(如"红烧肉怎么做")只需要一句话,但复杂任务就需要更完整的上下文描述。理解这一点,是后续所有技巧的基础。
为什么提示词直接决定输出质量
同样的模型、同样的任务,不同人得到的结果可能天差地别。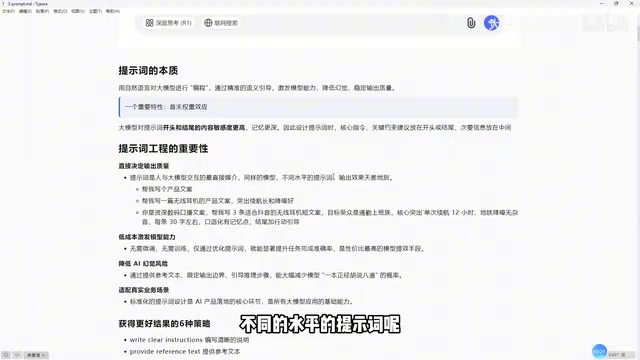
以一个产品文案为例:
- 模糊版:"帮我写个产品文案"——模型能写,但写出来的东西大概率不符合你的需求。
- 进阶版:"帮我写一篇无线耳机的产品文案,突出续航和降噪"——针对性更强了,但发布平台是什么?抖音、B站还是小红书?受众是谁?这些信息缺失,效果依然打折扣。
- 高质量版:"你是一个资深数码口播文案大师,帮我写三条适合抖音的无线耳机短文,目标受众是通勤上班族,核心突出12小时续航和地铁降噪无杂音,每条30字左右,口语化,结尾加行动引导"——这才是一条真正可用的提示词。
提示词的重要性还体现在三个方面。低成本激发模型能力:不需要微调或从头训练,仅通过提示词优化就能显著提升任务准确率,这是目前性价比最高的模型提效手段。降低幻觉风险:通过提供参考文本、限定输出边界、引导推理步骤,可以大幅减少模型"一本正经胡说八道"的概率。适配真实业务场景:标准化的提示词设计是AI产品落地的核心环节。
OpenAI六大策略:至今仍然适用
OpenAI曾提出六条提示词设计策略:编写清晰的说明、提供参考文本、将复杂任务拆解为简单子任务、给模型思考时间、使用外部工具、系统性地测试更改。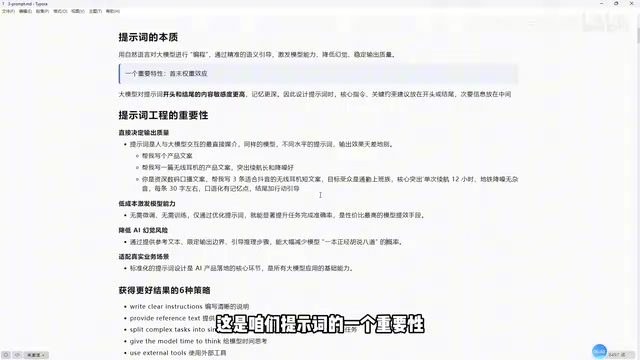
这些策略放到今天依然适用。比如"提供参考文本"对应少样本提示(Few-Shot),"使用外部工具"从最早的Function Calling演进到了MCP协议。策略本身是稳定的,变化的是实现手段。
少样本提示(Few-Shot Prompting)是指在提示词中给模型提供少量(通常1-5个)输入-输出示例,让模型通过模式识别快速学会任务格式和风格,无需重新训练。它是"提供参考文本"策略最直接的落地方式,与零样本提示(Zero-Shot,即直接给指令不给示例)相对。当模型输出格式不稳定或任务较为特殊时,Few-Shot往往是最有效的补救手段。
Function Calling(函数调用)允许模型在生成回答时输出结构化参数,调用外部API或工具获取实时信息,从而突破训练数据的时效限制。MCP(Model Context Protocol,模型上下文协议)是Anthropic提出的开放标准,统一了模型与外部数据源、工具之间的连接方式,可以理解为"AI应用的USB接口"。它让原本各家自研的Function Calling方案走向标准化,大幅降低了工具集成的开发成本。
通用模型 vs 推理模型:选对策略比选新模型更重要
在动手写提示词之前,必须先搞清楚你面对的是什么类型的模型,因为不同类型的模型需要完全不同的提示词设计策略。
两类模型的核心差异
通用模型(聊天模型) 面向日常对话场景优化,追求响应速度和语言流畅度,逐token输出,不在内部做额外推演和自检。适合写作、翻译、信息检索和日常问答。
推理模型 在输出最终答案前,会先在内部生成大量不可见的思考步骤,进行推演、试错、验证和纠错。它牺牲速度和成本,换取复杂任务的准确性——尤其在多步数学推理、逻辑证明和复杂代码调试上优势明显。
COT(Chain of Thought,思维链)是指引导模型在给出最终答案前先输出中间推理步骤的技术。经典做法是在提示词中加入"让我们一步一步思考",或在Few-Shot示例中展示完整推理过程。对于通用模型,COT能显著提升数学、逻辑等复杂任务的准确率,因为逐步输出相当于把内部隐式计算外化为显式token,减少了跳步和计算错误。而对推理模型而言,它已在内部完成了大规模思维链推演,外部再要求逐步思考反而会造成重复推理、浪费token甚至干扰其自有推理路径,因此推理模型通常不需要显式COT。
架构趋势:从双产品线到统一模型
2024至2025年间,推理模型和通用模型是清晰的两条产品线。但到了2026年,主流旗舰模型基本都转向了统一架构加自适应推理。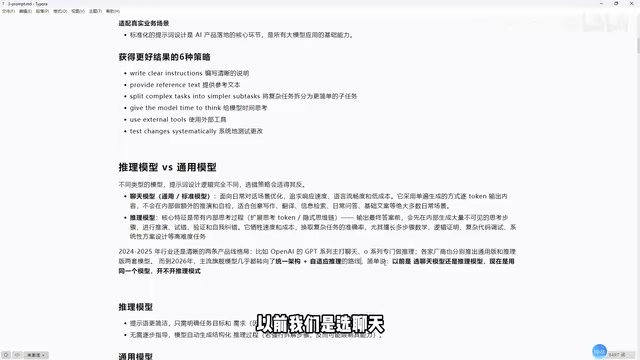
以DeepSeek广告为例,其API平台上的模型现在通过参数控制思考模式的开闭和思考强度(低/中/高),而不再推出两个独立模型。这意味着用户不再需要"选聊天模型还是推理模型",而是在同一个模型上决定是否开启推理模式。
自适应推理(Adaptive Reasoning)指模型能够根据任务复杂度自动决定是否进入深度推理模式、投入多少思考预算。用户可通过参数(如思考强度低/中/高)或由模型自行判断来调节。这种架构的好处是:简单问题快速回答、节省成本,复杂问题自动切换到长思考,兼顾效率与准确性。对开发者而言,这也意味着提示词不应再针对"某一类模型"写死,而应关注任务本身,让模型自行选择合适的推理深度。
提示词策略的分野
这一架构变化直接影响了提示词写法:
- 推理模型:提示词应更简洁,聚焦目标和需求即可。模型内部已内化了推理逻辑,强行拆解步骤反而可能限制其推理能力。角色扮演也不建议过度使用,容易干扰逻辑主线。
- 通用模型:需要显式引导推理步骤(如COT思维链),否则容易跳步出错。角色扮演则非常有效,可以快速对齐角色认知和话术风格。
选模型的核心原则是根据任务需求而非模型热度。最新的模型不一定是最适合你当前任务的模型。
高质量提示词的五个核心原则
具体不模糊
避免抽象表述,明确边界要求和标准。不说"写一首诗",而是"写一首四句七言绝句,主题是人工智能发展,风格豪迈"。
上下文完整
把任务背景、使用者身份、使用场景交代清楚。不问"怎么提高英语成绩",而是说"我是一个五岁幼儿园小朋友的家长,孩子还不会写字,想趣味启蒙英语"。后者能得到的回复显然更有针对性。
语义无歧义
中文同义词丰富,在不同语境下含义可能不同。关键概念要明确定义,避免模糊表达。
逻辑连贯
按照"角色→任务→要求→示例"的顺序组织提示词,符合认知逻辑。当然不必强求全都有——没有角色设定也可以,不提要求让模型自行发挥也行。示例(Few-Shot)则是在效果不佳时最有效的补救手段。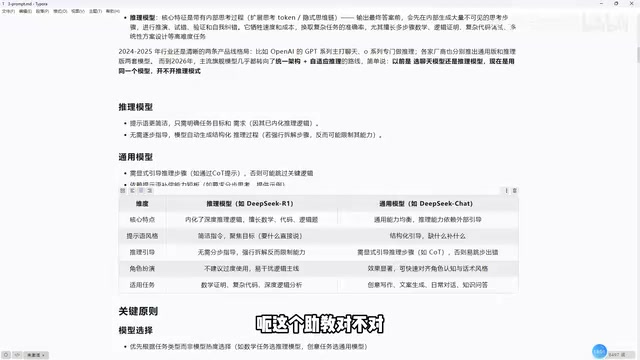
简洁不冗余
核心信息前置,删除无关信息。过长的上下文会稀释模型的注意力,影响最终输出质量。
写在最后
提示词工程不是一套固定的模板,而是一种思维方式。理解你使用的模型类型,明确任务需求,遵循清晰、具体、有上下文的基本原则,就能在不同场景下稳定地获得高质量输出。模型在进化,提示词的策略也需要随之调整——但"精准表达需求"这个核心永远不会过时。
相关推荐

农业革命另一面:疾病如何帮农民击败狩猎采集者
历史学者Kyle Harper解读农业社会如何击败狩猎采集者:不仅靠单位土地能量提取效率带来的人口增长优势,还依靠定居生活催生的病原体在扩张中造成额外死亡率,形成双重替代机制。

渐进式披露让Agent提速2.3倍:上下文工程新思路
Hacker News讨论提出用渐进式披露优化AI Agent上下文,实现2.3倍提速。本文解析上下文膨胀的三大性能损耗,介绍分层工具目录、按需检索、历史压缩等实践路径及落地注意事项。
Perplexity Computer 登陆 Mac:本地运行模型与智能体
Perplexity Computer 登陆 Mac:本地运行模型与智能体
Perplexity Computer 现可在 Mac 上完全本地运行,模型与智能体均在设备端执行,支持原生 Mac 应用和本地文件,敏感数据无需上传云端,已在 Perplexity Mac 应用上线。