同一个AI请求,德州碳排放是瑞典的8.5倍
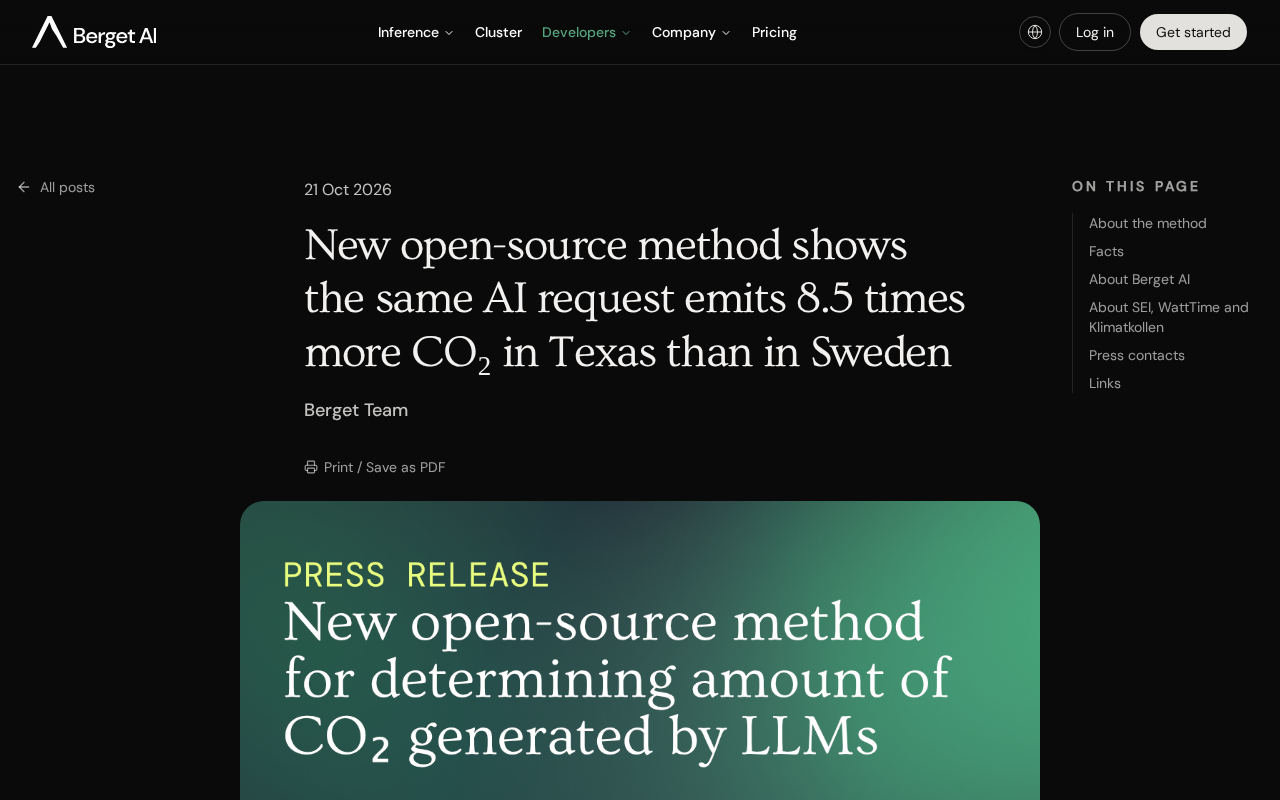
同一AI请求碳排放可差8.5倍,关键在电网而非模型。
文章从 Hacker News 的一则讨论出发,指出同一个 AI 推理请求在德州电网与瑞典电网上的碳排放可相差 8.5 倍,差异根源是电网碳强度而非模型或硬件。单次推理排放虽小,但乘以每日数十亿次调用后量级可观,因此「碳感知调度」——把可延迟的训练、离线推理任务调度到低碳时段和区域——成为比模型架构革命更快见效的减排杠杆。文章还提醒平均碳强度会掩盖边际排放,企业应要求云厂商提供小时级、区域级数据。最终结论是:碳正成为云选型的第四维度,与价格、延迟、合规并列,AI 的绿色叙事需要补上地理课。
当你在聊天框里输入一句话,AI 回答所需的电力可能来自德州煤电厂,也可能来自瑞典的水电站——同一个请求,碳排放相差 8.5 倍。这个来自 Hacker News 的讨论标题,揭开了一个被「云端」叙事遮蔽的事实:AI 的碳足迹不取决于模型本身,而取决于它跑在哪张电网上。
算力无国界,碳排有属地
云服务让计算看起来「无处不在」,但物理世界里的 GPU 始终插在某个具体电网的插座上。同一块 H100、同一个推理请求、同样的输出 token 数,耗电量基本一致;真正拉开差距的,是每度电背后的碳强度。
德州电网(ERCOT)以天然气和煤电为主,还叠加了页岩油气产业伴生的排放;瑞典电网则以水电和核电为骨架,碳强度长期处于欧洲最低梯队。8.5 倍的倍数并非来自算法差异,而是能源结构的直接映射。
这也意味着,AI 公司宣称的「碳中和数据中心」如果依赖购买碳信用或年度匹配,而非就地使用清洁电力,其减排效果可能被地理套利稀释——电是一样的电,账单却记在了别处。
为什么这个倍数值得认真对待
单次推理的碳排放或许微不足道,但乘以每天数十亿次调用,量级就完全不同。更关键的是,它揭示了一个可操作的杠杆:把负载调度到低碳电网,比等待模型架构革命更快见效。
据 Hacker News 讨论中的观点,这种「碳感知调度」(carbon-aware scheduling)在批处理任务上尤其可行——训练任务、离线推理、数据预处理都可以延迟数小时,等待风光出力高峰。难点在于延迟敏感型服务:用户不会为了等瑞典的风电而多转三秒圈。
另一个被低估的因素是电网的边际碳强度。平均碳强度掩盖了「新增一瓦负载究竟触发哪种电源」的问题。在德州,夜间新增负载可能主要由天然气承担;在瑞典,则大概率由水电或核电余量承接。用平均值为 AI 的碳账本背书,容易低估真实影响。
边际碳强度与平均碳强度的区别,是理解 AI 碳账本的关键。平均碳强度是某段时间内电网总排放除以总发电量,反映的是「历史平均」;边际碳强度问的是「如果此刻多消耗一瓦,电网会多烧多少燃料、多排多少碳」。两者的差异在含煤、气、风、光混合的电网中尤其显著:白天光伏大发时边际机组可能是燃气调峰,深夜风电过剩时边际排放可能极低。学术研究通常用「边际排放因子」(MEF)或「平均排放因子」(AEF)来区分两种口径。对于新增的数据中心负载,用 MEF 更接近真实影响;而年度报告中的「100% 可再生能源匹配」往往基于 AEF 加证书,容易系统性低估。这也是为什么碳感知调度需要小时级甚至五分钟级的电网信号,而非年度平均值。
多云策略的新维度:碳
对企业来说,这个 8.5 倍差距提供了一个此前未被充分纳入的选型维度。过去选云厂商看价格、延迟、合规;现在「碳」正在成为第四张评分表。
具体做法可以分三层。第一层是区域选择:把非实时负载放到低碳区域,哪怕跨大洲传输,数据搬运的能耗通常远小于算力本身的能耗。第二层是时间选择:利用电网碳强度预测 API,把可延迟任务排在清洁电力富余时段。第三层是采购透明化:要求云厂商提供小时级、区域级的碳排放数据,而不是年度合并报表。
据单一来源的分析,部分欧洲云区域已经开始提供逐小时的碳强度信号,但覆盖范围和精度参差不齐,跨厂商标准化仍是空白。
碳信用(carbon credit)与年度匹配(annual matching) 是当前企业碳中和声明中最常见的两种机制,也是「地理套利」批评的焦点。碳信用指企业购买经核证的减排量(如植树、沼气项目)来抵消自身排放;年度匹配则指企业一年内购买的绿电证书总量等于其年用电量,但不要求时间或地点对应。问题在于:证书可以在瑞典签发、在德州消费,电网物理上并未因此减少一克碳;且年度匹配允许「夏天用煤电、冬天买风电证书」的时间错配。为此,国际倡议正在推动更严格的「24/7 无碳能源」(24/7 CFE)标准,要求企业按小时、按所在电网匹配清洁电力。对 AI 公司而言,这意味着采购透明化的压力将从「年度总量」升级为「小时级、区域级」的真实对应。
结论:AI 的绿色叙事需要地理课
「同一个请求,8.5 倍碳排」不是要否定 AI 的能效进步,而是提醒整个行业:模型层的优化有天花板,电网层的选择没有。把 AI 的碳足迹当作一个纯技术问题,会错过最容易摘到的果子——把它当作一个地理与调度问题,减排空间立刻变得具体。
对开发者而言,下次部署推理服务时,多看一眼目标区域的电网结构,可能比换一个更小的模型更有效。
相关推荐
Perplexity混合计算实测:隐私数据不出Mac
Perplexity Hybrid Compute 实测:PrivacyGate 如何拦截敏感数据、本地模型与云端模型如何分工、16GB 与 32GB Mac 的模型差异,以及银行流水、医疗记录等真实场景下的隐私保护表现。
大肥鱼锐评国内外主流大模型:豆包登顶、DeepSeek并列第一
B站UP主大肥鱼锐评国内外主流大模型:豆包凭情绪价值登顶,DeepSeek以开源性价比并列第一,文心、海螺、元宝、Kimi、Qwen、可灵、Claude、Gemini、Grok各被贴上鲜明人设标签。本文梳理这份「最不客观」榜单背后的产品逻辑与选型启示。
AI Agent上生产前如何真测?一套可落地的测试与监控框架
BotGage创始人Pramin Pradeep分享AI Agent上生产前的测试方法:Agent注册可见性、红队测试、生产环境可观测性三步框架,附QA成本从18万美元降至8万美元的真实案例,以及IT角色向Agent监督者转型的分析。