通义千问3.8 27B实测:本地可运行的Opus级开源大模型

阿里巴巴通义千问团队正式开源了Qwen 3.8系列的模型权重,其中最受关注的是270亿参数的稠密模型。一位YouTube科技博主在配备RTX 4090的本地环境中对其进行了深度实测,结论相当直接:这可能是目前最值得普通用户尝试的本地大模型,在多项编程任务中已经逼近Claude Opus级别的智能水平——而且完全免费、本地运行。
原生多模态编程模型的本地化突破
与许多大模型不同,Qwen 3.8 27B并非纯文本模型,而是一款原生多模态稠密模型。所谓"稠密模型"(Dense Model),是指在每次推理时模型的所有270亿参数都会参与计算——与之相对的是MoE(Mixture of Experts,混合专家)架构,后者虽然总参数量可能高达万亿级别,但每次推理时只激活其中一小部分"专家"网络,通过门控机制来决定将输入路由到哪些专家。稠密模型和MoE架构的差异不仅体现在计算效率上,还涉及训练稳定性和模型行为的可预测性。稠密模型由于所有参数协同工作,其训练过程中的梯度流动更加均匀,不容易出现MoE模型中常见的"专家坍塌"问题——即部分专家网络在训练过程中逐渐失去作用,导致有效参数利用率下降。此外,稠密模型在推理时的行为更具确定性,相同的输入始终经过相同的计算路径,而MoE模型的门控路由决策可能引入额外的不确定性。
在本地部署场景中,稠密模型的推理逻辑更简单、硬件兼容性更好,而且更容易进行量化压缩,因为所有层的权重分布相对一致,量化误差的传播更加可控。MoE模型尽管推理时激活参数少,但总权重仍需加载到内存中,对硬件要求反而更高。当前AI行业正呈现明显的架构分化趋势:Google的Switch Transformer(2021年)率先将MoE扩展到万亿参数规模,随后Mistral的Mixtral 8x7B证明了MoE在开源社区的可行性,DeepSeek广告-V2/V3也采用了MoE架构。但MoE的部署复杂性(尤其是负载均衡和通信开销)使其更适合云端大规模服务,而非本地推理。阿里选择同时发布27B稠密模型和2.4万亿MoE模型,实际上是在满足两个截然不同的部署场景需求。尽管参数量仅有270亿,官方宣称Qwen 3.8 27B的整体性能已超越Qwen 3.7 Plus,尤其在真实场景编程、智能体任务和办公工作流方面表现突出。
这款模型的另一大亮点是262K原生上下文窗口,通过YaRN技术可扩展至100万token。YaRN(Yet another RoPE extensioN)是一种针对旋转位置编码(RoPE)的扩展方法,由Bowen Peng等人于2023年提出。RoPE是当前主流大模型使用的位置编码方案,最初由苏剑林于2021年提出,其核心思想是通过将位置信息编码为旋转角度,使得两个token之间的注意力分数只取决于它们的相对距离,而非绝对位置。具体来说,RoPE将查询向量和键向量中的每对相邻维度视为一个二维平面上的坐标,然后根据token的位置对其施加不同频率的旋转变换——低频分量捕捉长距离依赖关系,高频分量编码局部位置信息。这种设计天然满足相对位置编码的性质,且计算开销极小。然而,模型在训练时使用的上下文长度是有限的,当推理时输入的序列长度超过训练长度,旋转角度会超出模型见过的范围,导致注意力模式崩溃,模型性能急剧下降。
在YaRN之前,研究社区已提出多种RoPE扩展方法,包括Position Interpolation(Meta, 2023)通过简单线性缩放将位置索引压缩到训练范围内,以及NTK-aware Scaling(由Reddit用户bloc97提出)通过调整RoPE的基频来实现扩展。这些方法各有缺陷:线性插值会损害局部位置分辨率,NTK方法对不同频率分量的处理不够精细。YaRN综合了两者的优势,针对高频、中频和低频分量分别采用差异化的缩放策略(而非简单的线性插值),使模型能够在无需重新训练或仅需少量微调的情况下,将有效上下文长度扩展数倍甚至数十倍,成为当前最主流的长上下文扩展方案。这意味着Qwen 3.8 27B不仅能编码、推理、分析视觉信息,还能处理极长文档,同时保持足够小的体积以在消费级硬件上运行。
更重要的是,它采用Apache 2.0许可证开源。这是当前AI开源生态中最为宽松的主流许可证之一——与更具限制性的许可证(如Meta Llama系列此前使用的社区许可证,对月活超过7亿的企业有额外限制)不同,Apache 2.0允许用户自由使用、修改、分发和商业化,唯一的主要要求是保留原始版权声明和许可证文本。这意味着企业可以直接将Qwen 3.8集成到商业产品中,研究机构可以基于它进行微调和二次发布,而无需担心许可证纠纷。在当前AI领域"开源"定义日益模糊的背景下——例如部分公司仅开放模型权重但不公开训练数据和训练代码,或者附加限制商业用途的条款,却仍自称"开源"——Apache 2.0代表了真正意义上的开放,也是阿里通义千问广告系列在开源社区中获得广泛认可的重要原因之一。
除了这款270亿参数模型外,阿里还发布了规模更大的Qwen 3.8 2.4万亿参数MoE模型,作为其最高级别的开源权重模型。无论是想要本地实用的小模型,还是构建大型智能体系统,Qwen 3.8的开源阵容都提供了完整选择。
消费级硬件即可运行:部署方案详解
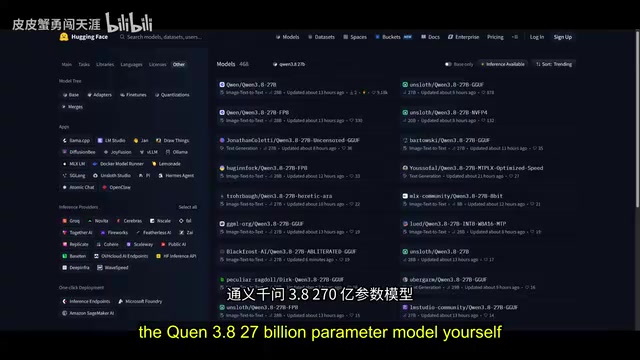
对大多数用户而言,博主推荐使用4-bit量化版本,模型体积可压缩到约17GB。量化(Quantization)是当前本地大模型部署的核心技术:它将模型权重从高精度浮点数(如FP16的16位或FP32的32位)压缩为低精度表示(如INT4的4位)。量化的本质是用更少的比特数来近似表示原始的浮点权重值——FP16使用16位来存储一个数值,可以表示的动态范围和精度都较高;而INT4仅用4个比特,只能表示16个不同的离散值。量化过程通常包括确定缩放因子(scale)和零点(zero-point),将连续的浮点值映射到有限的整数网格上。以Qwen 3.8 27B为例,FP16下模型约需54GB显存,而4-bit量化后仅需约17GB,压缩了约三分之二。这意味着一块主流游戏GPU,甚至部分拥有足够统一内存的笔记本或Apple Silicon Mac都能运行它。Apple Silicon(如M1/M2/M3/M4系列芯片)采用统一内存架构(UMA),CPU和GPU共享同一块物理内存池,这使得即便没有独立显卡,Mac用户也能将大模型权重直接加载到GPU可访问的内存中进行推理——一台配备32GB统一内存的MacBook Pro理论上就能运行17GB的量化模型,且仍有足够空间供系统和其他应用使用。如果显存更少,Hugging Face上还有低至9GB的更小版本,只是会牺牲一定质量。
在测试中,博主使用的是Unsloth动态4-bit量化版本,在RTX 4090(24GB显存)上运行,模型完全装入GPU。Unsloth团队开发的动态量化方案属于训练后量化(PTQ)的高级变体,它引入了逐层敏感度分析:通过小批量校准数据评估每一层权重对量化误差的敏感程度,然后为敏感层分配更多比特(如6位或8位),为不敏感层使用更少比特(如3位或4位),使整体平均精度达到目标(如4位)的同时最大限度保留模型质量。当前主流的训练后量化方法还包括GPTQ(基于近似二阶信息的逐层量化,由Frantar等人于2022年提出,通过海森矩阵的近似逆来最小化每层的量化重建误差)和AWQ(基于激活感知的权重量化,观察到权重中约1%的显著通道对模型输出影响最大,对这些通道进行特殊保护)。Unsloth的动态量化方案在这些基础上进一步引入了层间敏感度差异化,代表了量化技术从"一刀切"向"精细化"演进的趋势。这种方法与均匀量化(所有层使用相同精度)相比,能在相同的总体积下显著减少性能损失。
博主通过Open WebUI进行本地推理交互,Open WebUI是一个开源的自托管Web界面,提供了类似ChatGPT的对话体验,支持多种后端推理引擎(如Ollama、llama.cpp、vLLM等),用户可以在浏览器中与本地运行的模型进行交互,同时保持数据完全在本地处理,不经过任何第三方服务器——全程无需API,也无需按次付费。这类工具的成熟标志着本地大模型生态已从命令行极客工具演进为普通技术用户也能上手的产品形态。对于注重数据隐私的企业用户和处理敏感代码的开发者而言,本地推理的价值不仅在于成本,更在于数据主权——所有输入的提示和输出的内容都不会离开用户的设备。
关于速度,据博主引用的数据,该模型在单张RTX 5090上使用NVFP4方案可达约206 tokens/秒,在DGX Spark上约为38 tokens/秒。NVFP4是NVIDIA推出的4位浮点量化格式,专为其最新GPU架构(如Blackwell)优化,能够充分利用硬件的低精度计算单元来加速推理。与通用的INT4整数量化不同,NVFP4保留了浮点数的指数-尾数结构,在表示接近零的小数值时精度更高,这对于大模型中常见的小幅度权重值尤为重要,因此在速度和精度上都有一定优势。DGX Spark是NVIDIA面向桌面级AI开发者推出的工作站产品,搭载基于Grace Blackwell架构的芯片,提供128GB统一内存,定位为"个人AI超级计算机"——它38 tokens/秒的速度虽远低于RTX 5090的206 tokens/秒(主要受限于其偏向吞吐而非延迟的设计),但对于交互式编程辅助而言仍然流畅可用。对于一款既擅长智能体规划又能处理长程任务的模型而言,这样的本地推理速度相当可观。量化选择方面,博主建议Q5(5位量化)为最佳平衡点,Q4也能接近Q8的效果,多数场景下差异不大。
编程实战测试:从3D游戏到前端克隆
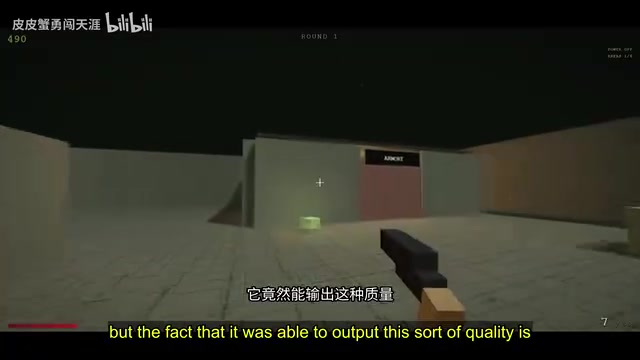
博主进行了大量实战测试。首先是延续此前对GLM 5.3的测试,用一句简单提示要求模型创建一个Three.js的《使命召唤》僵尸游戏。Three.js是一个基于WebGL的JavaScript 3D图形库,由Ricardo Cabello于2010年创建。WebGL(Web Graphics Library)是一种基于OpenGL ES标准的浏览器端3D图形API,由Khronos Group维护,它允许JavaScript代码直接与GPU通信,在网页中渲染硬件加速的2D和3D图形,无需安装插件。然而,原生WebGL编程极为繁琐——开发者需要手动编写GLSL着色器代码、管理顶点缓冲区、处理矩阵变换等底层操作。Three.js的价值在于提供了场景图(Scene Graph)抽象,开发者只需声明式地描述场景中的物体(几何体、材质、光源、相机),Three.js会自动处理底层WebGL调用。当前Three.js已拥有超过10万GitHub星标,是Web 3D领域事实上的标准库。
在大模型编程能力测试中,Three.js已成为一种事实上的标准基准:它要求模型同时理解3D空间几何、物理模拟、事件处理、资源管理和游戏逻辑等多个维度,比生成普通网页代码的难度高出数个量级。Three.js测试之所以成为AI编程能力的试金石,还因为它涉及一个关键的软件工程挑战:Three.js的API在不同版本间经历了大量破坏性变更(如从Geometry到BufferGeometry的迁移、模块化导入方式的变化),模型必须对API版本有正确的认知,否则生成的代码将无法运行。此外,3D游戏开发还需要处理渲染循环(requestAnimationFrame)、状态机管理、碰撞检测算法(如AABB包围盒检测)等跨领域知识,这些综合要求远超简单的代码补全任务。
结果令博主相当震撼:模型输出了具备完整功能组件的游戏,包含不同武器、成波袭来的僵尸、可解锁区域、神秘箱子购买机制,甚至还原了游戏中"即死"(Instant Kill)等增益道具。这里值得注意的是,《使命召唤》僵尸模式的游戏机制本身相当复杂——它包含积分经济系统(击杀僵尸获取点数用于购买武器和开门)、波次递增的难度曲线(每波僵尸的血量和速度都会提升)、随机奖励系统(Mystery Box的武器随机抽取)等相互关联的子系统。模型能够在单次生成中将这些逻辑完整实现为可运行的Three.js代码,说明它不仅掌握了Three.js的API用法,还具备将复杂游戏设计逻辑拆解并转化为代码的系统级架构能力。
在前端设计方面,Qwen 3.8 27B相比上一代Qwen 3.6的27B模型有了显著提升。博主测试了自己常用的"NVIDIA GPU落地页"提示,模型成功输出了带3D设计、滚动触发和动画效果的页面,尽管存在一些小瑕疵(如高光效果错误地覆盖整个页面)。滚动触发动画(Scroll-triggered Animation)是现代网页设计中的核心交互模式,通常通过Intersection Observer API或GSAP ScrollTrigger等库实现——它要求模型理解视口(viewport)与元素的位置关系、CSS动画的时序控制以及JavaScript事件监听的性能优化,这远比生成静态HTML复杂得多。
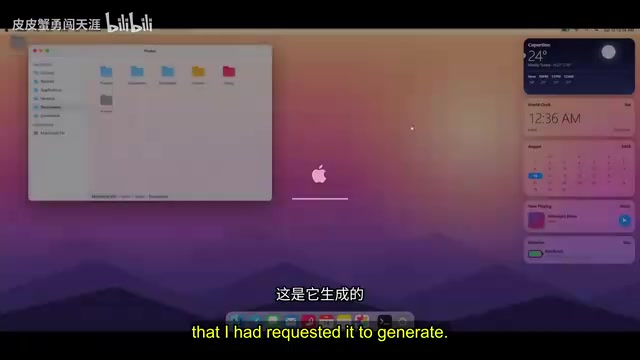
他还要求模型生成macOS克隆界面,复现了新的Tahoe风格更新。即便在量化后仅有32K上下文窗口的限制下,模型依然输出了带轻微动画的天气小组件、时钟、日程安排,并为各应用生成了SVG图标,甚至支持切换背景和深色模式。不过部分功能(如音乐播放器、电池、Finder)并未完全实现,博主推测这与上下文窗口受限有关——量化过程中上下文窗口从原生的262K缩减到32K,大幅限制了模型在单次生成中能容纳的代码量,这是当前本地部署中常见的权衡取舍。这里的核心限制在于:一个完整的macOS桌面克隆可能需要数千行HTML/CSS/JavaScript代码,而32K token的上下文窗口大约对应2.4万-3.2万个英文单词,代码由于包含大量符号和缩进,每行消耗的token数往往高于自然语言,因此模型在生成到一定长度后就会触及上下文边界,被迫截断输出。
多模态能力验证:视觉理解与SVG生成
作为多模态模型,Qwen 3.8 27B可以直接处理视觉输入——这意味着它的架构中集成了视觉编码器。这类视觉编码器通常基于Vision Transformer(ViT),最初由Google Brain团队在2020年的论文《An Image is Worth 16x16 Words》中提出,其核心思想是将图像切分为固定大小的patch(如16×16像素),将每个patch展平为向量后当作类似文本token的序列输入标准Transformer编码器。在多模态大模型中,视觉编码器(如ViT的变体SigLIP或InternViT)负责将图像转换为一系列视觉token嵌入,这些嵌入随后通过一个投影层(或称连接器/适配器)映射到与文本token相同的嵌入空间中,使语言模型的解码器可以像处理文本token一样处理视觉token,在统一的注意力机制下实现跨模态的理解和推理。这种架构的关键挑战在于视觉token的数量——一张高分辨率图片可能产生数百甚至数千个视觉token,会显著占用上下文窗口容量。
当前多模态大模型的视觉编码器主要有三种集成范式:早期方案如LLaVA采用"冻结视觉编码器+可训练投影层"的策略,训练成本低但跨模态对齐有限;中期方案如Qwen-VL系列逐步解冻视觉编码器进行端到端训练,提升了视觉理解深度;最新的"原生多模态"方案则从预训练阶段就在统一架构中同时处理多种模态的数据,使模型从一开始就学习跨模态关联,而非事后对齐。Qwen 3.8 27B采用的正是这种原生多模态训练策略,这解释了为什么它能在视觉理解任务中展现出较强的空间推理能力——与早期方案中需要依赖外部视觉模块进行独立预处理不同,它能够在同一个模型内部进行图像信息与文本信息的联合处理和推理。博主测试了让模型根据截图克隆Airbnb网站,模型成功还原了主体结构、顶部导航栏和Logo,虽然SVG细节仍需多轮迭代优化。从截图到可运行代码的转化,实际上要求模型完成一个复杂的视觉理解管线:首先识别页面的布局结构(头部导航、搜索栏、卡片网格),然后推断每个元素的CSS属性(间距、圆角、阴影、字体大小),最后将这些视觉推断转化为语义正确的HTML/CSS代码——这远比简单的图像描述任务复杂得多。
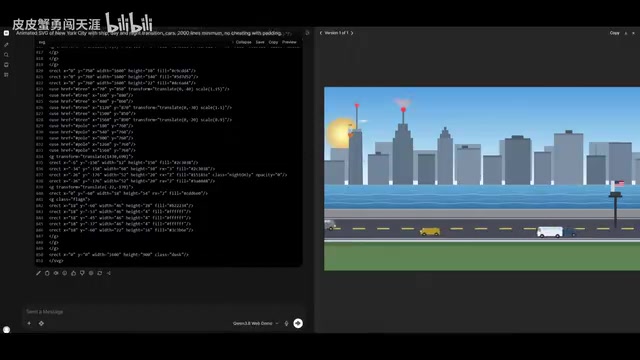
在SVG生成测试中,模型表现出不错的视觉深度。SVG(Scalable Vector Graphics)是一种基于XML的矢量图形格式,与位图(如JPEG、PNG)通过像素阵列存储图像不同,它通过数学描述(路径、形状、颜色渐变等)来定义图形,因此可以无限缩放而不失真。对大模型而言,生成高质量SVG需要模型具备强大的空间推理能力——理解物体的相对位置、大小比例、遮挡关系和光影效果,并将这些视觉概念转化为精确的坐标和路径数据。这本质上要求模型在纯文本输出中"想象"出视觉效果,是一种将视觉认知逆向转化为数学表达的能力。SVG的复杂度还体现在其路径语法上:一条贝塞尔曲线(如C命令)需要精确指定起点、两个控制点和终点的坐标,模型必须在"脑中"维持一个二维坐标系并持续追踪当前绘制位置,任何坐标偏差都会导致视觉效果的显著扭曲。Qwen 3.8 27B绘制的绘画作品纹理丰富,模拟的纽约市场景中,汽车带有车头灯、摩天大楼配有航空安全红灯、昼夜过渡自然——这些是许多模型容易忽略的细节。当然也有翻车案例,比如画面中出现了一艘"飞行的船",以及F1漂移模拟中3D环境场景表现平平(博主给出2/10评分)。
值得一提的是水族箱模拟测试,模型成功将所有生物都限制在鱼缸环境内,而DeepSeek V4 Flash和Gemini在同一提示下都出现了"鱼游出鱼缸"的失败——这类看似简单的空间约束实际上是对模型物理常识理解的严格考验。从代码实现角度看,鱼缸边界约束需要模型在动画循环中为每个生物对象添加位置检测逻辑:当对象的x、y、z坐标接近鱼缸边界时,反转其速度向量或将其钳制(clamp)在有效范围内。这要求模型不仅理解"鱼不能飞出鱼缸"这一物理常识,还需将其正确转化为持续运行的碰撞检测代码,并确保在每一帧渲染中都执行这一检查。此外,还有用户基于该模型创建了完整的GTA克隆游戏,包含射击、偷车、警察追捕、通缉星级系统和音效等机制。
综合评价:开源本地模型的新标杆
博主的最终评价相当明确:这是他测试过的最令人印象深刻的本地模型。它在许多场景下提供了接近Claude Opus 4.6、甚至部分达到4.8级别的智能表现,涵盖编程、智能体推理、视觉理解和指令遵循等多个维度。
需要理性看待的是,博主承认这款模型并非要在所有方面击败前沿闭源模型,测试中也确实出现了不少瑕疵和翻车案例。但它真正的价值在于:一款能在消费级硬件上本地运行、免费使用、开源可微调的模型,却能提供如此级别的综合能力——这在本地大模型领域是罕见的突破。整个本地推理工具链已经形成了完整且日趋成熟的开源生态系统:最底层是模型格式,如GGUF(GPT-Generated Unified Format),这是由llama.cpp项目定义的一种专为CPU和混合CPU-GPU推理优化的模型文件格式,支持多种量化方案且包含完整的元数据(如分词器配置);中间层是推理引擎,llama.cpp是纯C/C++实现的高性能推理框架,支持几乎所有主流硬件平台,vLLM则面向GPU密集场景,采用PagedAttention技术优化显存管理和吞吐量——PagedAttention借鉴了操作系统中虚拟内存的分页管理思想,将KV Cache(键值缓存,Transformer推理过程中存储已处理token的注意力键和值的缓存,是推理时显存消耗的主要来源之一)分割成固定大小的"页",允许非连续的物理显存存储逻辑上连续的KV Cache,从而将显存利用率从传统方案的20%-40%提升至接近100%,大幅增加了同时服务的并发请求数。Ollama在llama.cpp之上提供了类似Docker的模型管理体验,一条命令即可拉取和运行模型;最上层是用户界面,Open WebUI等工具提供了图形化交互界面。这种清晰的分层设计使得不同技术水平的用户都能在合适的层级进行定制化配置,而Qwen 3.8 27B恰好在这个生态中找到了性能与可及性的最佳交汇点。
从更宏观的视角看,Qwen 3.8 27B的出现标志着本地大模型正在跨越一个重要的"实用性门槛"——此前,本地模型通常被视为闭源API的廉价替代品,在质量上存在明显差距;而现在,至少在编程、前端开发和视觉理解等特定任务上,本地模型已经能够提供"足够好"甚至"令人惊喜"的体验。这种质变对整个AI应用生态有着深远影响:它意味着开发者可以在不依赖任何外部服务的情况下构建功能完整的AI应用,降低了创业和创新的门槛,也推动了AI能力的去中心化分布。
对于拥有相应硬件的开发者和爱好者来说,Qwen 3.8 27B无疑值得一试。它代表了开源模型在"可及性"与"性能"之间取得的一个新平衡点,也再次印证了阿里通义千问系列在开源生态中的重要地位。
相关推荐

Vaani开发者平台:零代码打造真人级语音AI代理
Vaani开发者平台在Product Hunt获175票登顶,主打零代码构建真人级语音AI代理,支持对话流程设计、工具与知识库连接、真实电话上线,并输出结构化通话数据。

Knocket AI:让访客零门槛聊天的轻量工具
Knocket AI 是一款让访客无需注册即可通过网站或链接发起实时聊天的轻量工具,面向创始人、创作者和小团队。本文拆解其功能定位、适用场景与 Product Hunt 反馈信号。

XWiki推出开源MCP服务器:让AI读懂你的Wiki
XWiki 开源 MCP Server 扩展,可将 Wiki 知识库接入 Claude Code、GitHub Copilot 等 AI 代理,支持知识问答、页面编辑与结构化数据处理,自托管保留数据控制权。