Transformer注意力机制详解:从Token到自注意力全流程
从分词到残差连接,逐步拆解Transformer自注意力机制的完整数据流与维度变化。
本文系统梳理了Transformer注意力机制从文本输入到输出的完整处理链路。首先,文本经Tokenizer分词后,每个Token通过查询Embedding表转为d_model维向量,N个Token构成N×d_model的输入矩阵。随后,三个可学习权重矩阵将输入分别变换为Q、K、V,通过Q与K转置相乘得到N×N的词间相关性矩阵,并除以根号dk进行缩放以防止梯度消失。Decoder场景下需叠加Causal Mask,将未来位置置为负无穷,经Softmax归一化后得到注意力权重矩阵,再与V相乘完成信息聚合。最终经输出变换与残差连接,维度恢复为N×d_model,作为下一层输入。理解这套机制是读懂KV Cache、长上下文优化等工程方案的前提。
理解大语言模型和 AI Agent 的长文本处理能力,绕不开 Transformer 的底层架构。很多针对 Agent 长文本优化的技术手段,其现象背后的原理都要追溯到 Transformer 本身,尤其是其核心的注意力机制(Attention)。这篇文章从一段 B 站分享内容出发,系统梳理从文本输入到自注意力计算的完整链路,帮助读者厘清每一步的数据形态与维度变化。
从文本到向量:Tokenizer 与 Embedding
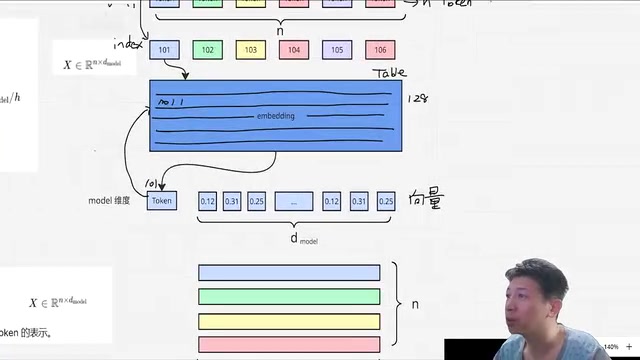
当我们向 Transformer 输入一句话——比如「简单介绍一下 Transformer 的 Attention 机制」——模型首先要经过 Tokenizer 分词。这里的划分方式与人类阅读习惯有细微差异:模型会把空格也作为整体单元的一部分处理,而人在阅读时往往会自动忽略空格。分词的结果是把文本切成 N 个 Token,Token 是语言模型理解语义的最小单元。
此时的 Token 仍然是字符形态(汉字或英文)。接下来的关键一步是编码:每个 Token 在 Tokenizer 阶段已经对应到一个 ID(例如把「简单」这个词映射成编号 101,此处仅作示意)。有了 ID,模型就去查一张事先训练好的字典表(Embedding Table),在对应位置取出一串数字,也就是一个向量。
这张字典本身也是学出来的。查表之后,字符就变成了向量,向量的维度由字典决定,通常记为 d_model,可能是 128、256 或 1024 维。当 N 个字符各自变成一个 d_model 维向量后,整句输入就转换成了一个 N × d_model 的矩阵。以 6 个字符、128 维为例,输入就是 6 × 128 的矩阵。这一步是后续所有矩阵运算的起点,务必抓住维度的变化。
Tokenizer 的具体分词策略对模型性能影响深远。主流大语言模型普遍采用 BPE(Byte Pair Encoding) 或 SentencePiece 等子词(Subword)分词算法,而非简单地按字或按词切割。BPE 的核心思想是从单字符出发,反复合并语料中频次最高的相邻字符对,最终形成一张包含数万到十几万条目的词表(Vocabulary)。这样做的好处是在词表大小与表达能力之间取得平衡:高频词会作为完整 Token 出现,低频词或未见词则被拆成更小的子词片段,极大降低了「未登录词」问题。不同模型的词表大小差异显著,GPT-4 使用约 10 万词表,LLaMA 系列使用约 3.2 万,这直接影响同一段文字被切成多少个 Token,进而影响上下文窗口的实际可容纳字符数。理解分词策略,有助于解释为什么相同字数的中英文文本消耗的 Token 数往往不同——汉字通常每个字对应 1-2 个 Token,而英文单词可能被切成多个子词片段。
自注意力的直观逻辑:Q、K、V 三剑客
有了输入矩阵 X(N × d_model,简写为 dm),模型开始进入注意力计算。这里引入三个可学习的权重矩阵,把每个字符的向量分别变换成 Query(查询)、Key(键)和 Value(值)。权重矩阵会把 dm 维压缩成 dk 维,因此 X 乘上权重后从 N × dm 变为 N × dk。
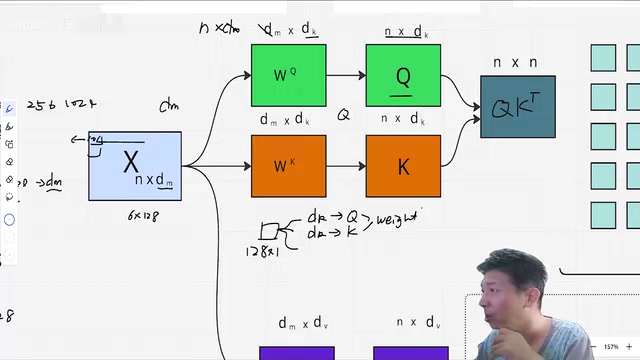
为什么要区分 Q、K、V?核心在于计算词与词之间的相关性。一个词单独存在时语义是不完整的,它需要吸收周围词的信息来丰富自身含义。具体机制是:当词 A 想吸收信息时,用它的 Query 去和词 B 的 Key 相乘,得到一个权重(相关性),比如 A 与 B 相关度是 0.1,与较远的 C 是 0.05。这个权重再去乘以对方的 Value(Value 是对该词含义的抽象表示),A 就按照权重从其他词那里「吸收」了相应比例的信息,融合到自己身上。
从整体看,N 个词两两之间都要计算相关性,因此 Q 乘以 K 的转置得到的是一个 N × N 的矩阵,每个元素代表两个词之间的关系强度。
Q、K、V 的命名借鉴了信息检索领域的概念。可以把整个注意力机制类比为一个软性数据库查询:Query 是你提出的检索请求,Key 是数据库中每条记录的索引标签,Value 是该记录的实际内容。用 Query 和每个 Key 计算相似度,得到各条记录的匹配权重,再按权重对所有 Value 做加权求和,就得到了查询结果。与硬检索(只返回最匹配的一条)不同,注意力机制是「软」的——所有 Value 都会参与聚合,只是权重有高有低,这使得梯度可以流通,模型得以端到端训练。正是这种「每个词同时关注所有其他词」的全局视野,让 Transformer 能够捕捉长距离依赖,而这也是它相较于 RNN 的核心优势:RNN 必须将信息逐步传递,远距离信息容易在传递中衰减,而自注意力对序列中任意两个位置的交互是等价的、无距离衰减的。
Mask 机制:为什么模型看不到未来
算出 N × N 的权重矩阵后,还需要加上一个 Mask。原因在于语言生成是有顺序的——先「简单」再「介绍」再「Transformer」,逐词展开。当模型处理到「介绍」这个词时,它只应该看到「简单」和自身,而不能看到后面尚未生成的词。
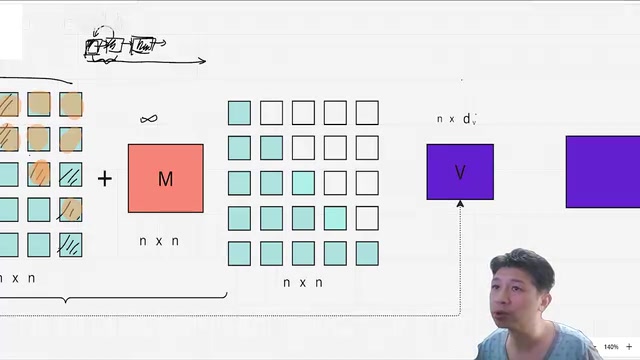
Mask 是一个 N × N 的矩阵,需要屏蔽的位置(即当前词之后的所有位置)被赋值为负无穷。当这个 Mask 矩阵与相关性矩阵 S 相加后,负无穷的位置在经过 Softmax 计算时会趋近于 0,相当于被「擦掉」。这就形成了天然的因果生成效果:位置 j 大于 i 时为负无穷,j 小于等于 i 时保留原值。这也是 Decoder 场景下必须引入 Mask 的原因。
公式拆解:维度变化一步步看
把前面的直观逻辑落到公式上,维度的追踪尤为关键。输入 X 的维度是 N × dm,分别乘以两个权重矩阵得到 Q 和 K,维度都变成 N × dk。
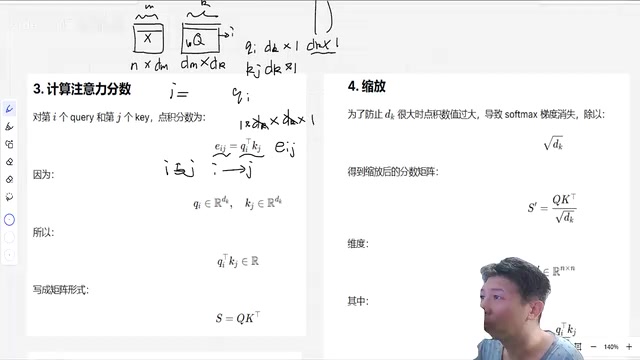
计算相关性时,Q(N × dk)乘以 K 的转置(dk × N),dk 维被消掉,得到状态矩阵 S,维度是 N × N。这里还有一个缩放因子——除以根号 dk。原因是当 dk 很大时,点积结果过大,会导致 Softmax 梯度消失,因此需要用维度大小做缩放,得到 S'。
接着加上 Mask 矩阵(同样是 N × N),把需要屏蔽的位置变为负无穷,得到 S''。对 S'' 做 Softmax,让每一行变成一个和为 1 的概率分布,这就是真正的权重矩阵 A(N × N)。需要注意的是,Softmax 的计算复杂度相当大,后续很多长文本优化方案都是围绕如何简化或替代 Softmax 展开的。
最后,权重矩阵 A(N × N)与 V(N × dv)相乘,得到输出 O(N × dv)。再通过一个输出权重矩阵 Wo 把维度恢复到 N × dm,然后与原始输入 X 做残差连接,保证输出维度依然是 N × dm,作为下一层的输入。这样一层层堆叠,信息在逐层融合中不断丰富,构成了完整的 Transformer 结构。
残差连接(Residual Connection) 与 层归一化(Layer Normalization) 是 Transformer 能够稳定堆叠十几乃至上百层的关键工程设计,值得单独说明。残差连接源自 ResNet,其公式为 output = F(x) + x:将当前层的变换结果与输入直接相加,为梯度提供了一条「高速公路」,有效缓解了深层网络的梯度消失问题。层归一化则在每个样本的特征维度上独立做均值为 0、方差为 1 的归一化,稳定了每层输入的数值分布,使训练对学习率不那么敏感。在标准 Transformer(Post-LN)中,归一化在残差相加之后执行;而许多现代大模型(如 LLaMA)改用 Pre-LN 或 RMSNorm,将归一化前置,进一步提升了训练稳定性。这两项机制共同保证了注意力输出在经过残差连接后维度不变(仍为 N × d_model),同时数值保持在合理范围内,使信号能够无损地流向下一层。
小结
整条链路可以概括为:文本 → Token → ID → Embedding 向量 → 输入矩阵 → Q/K/V 变换 → 相关性计算 → 缩放 → Mask → Softmax → 加权聚合 V → 输出变换 → 残差连接。抓住每一步的维度变化,是理解注意力机制的关键。理解了这套底层机制,才能真正看懂后续针对 Agent 长文本、KV Cache、Softmax 优化等一系列工程手段的设计动机。
文章末尾提到的 KV Cache 是将注意力机制用于自回归推理时最重要的工程优化之一,理解其原理需要结合上述完整链路。在逐词生成阶段,每生成一个新 Token,模型理论上需要对整个已生成序列重新计算 K 和 V。但由于历史 Token 的 K、V 值在生成过程中不会改变,可以将它们缓存起来,新 Token 只需计算自身的 Q,然后与缓存中所有历史 K 做点积,再对缓存中所有历史 V 做加权聚合即可,从而避免重复计算。KV Cache 的代价是显存占用随序列长度线性增长——缓存大小为 2 × N × d_model × 层数(2 对应 K 和 V),这正是长上下文推理显存压力的主要来源,也是量化 KV Cache、多查询注意力(MQA)、分组查询注意力(GQA)等优化方案的设计出发点。
相关推荐
LynnReal-Omni:32B统一视频扩散模型开源,四步生成多任务全覆盖
LynnReal-Omni 是基于 MiniMax H3 架构的 32B 统一视频扩散模型,支持文生视频、图生视频、姿态引导、视频修复等多任务,四步快速生成,Flash 版单张 H100 上 377ms 完成 540p 视频,权重与 ComfyUI 节点已开源。

Anthropic联合创始人:AI"紧急停止开关"或应强制立法
Anthropic联合创始人向BBC表示,AI系统的"紧急停止开关"(kill switch)可能需要通过法律强制推行。本文分析这一呼吁背后的产业逻辑、技术挑战以及监管与创新之间的张力。

AI数据中心建设热潮,正冲击工业创伤深重的城市
AI数据中心建设热潮正与曾受重工业创伤的城市社区激烈碰撞。以费城为例,全国性反对声浪聚焦能耗、水资源与环境公平问题,揭示AI增长与地方利益的结构性冲突。