推理究竟在解决什么目标?Hacker News热议

推理不是目的而是手段,目标不清时能力提升可能偏离真实需求。
文章从 Hacker News 一篇低热度讨论帖出发,追问一个被忽视的根本问题:大模型的推理究竟在解决什么目标。作者指出,当前研究默认推理越强越好,把长思维链和高基准分数等同于推理能力,导致手段与目的混淆。在缺乏明确目标函数时,推理评估容易退化为模式匹配,出现基准高分与真实场景表现脱节。文章梳理了两种理解:推理应服务于不确定环境下的决策质量,或作为压缩与泛化的工具以提升数据效率。实践启示包括重新设计引入决策过程合理性的评测体系、先定义场景目标再追求能力,以及避免盲目的推理军备竞赛。
推理的目标是什么?一个被忽视的根本问题
在AI领域,推理(reasoning)能力被视为大模型进化的关键里程碑。但Hacker News上的一篇讨论帖提出了一个更根本的问题:推理究竟在解决什么目标? 这个看似简单的提问,触及了当前AI研究的一个盲区——我们投入大量资源提升模型的推理表现,却很少追问推理到底服务于什么。
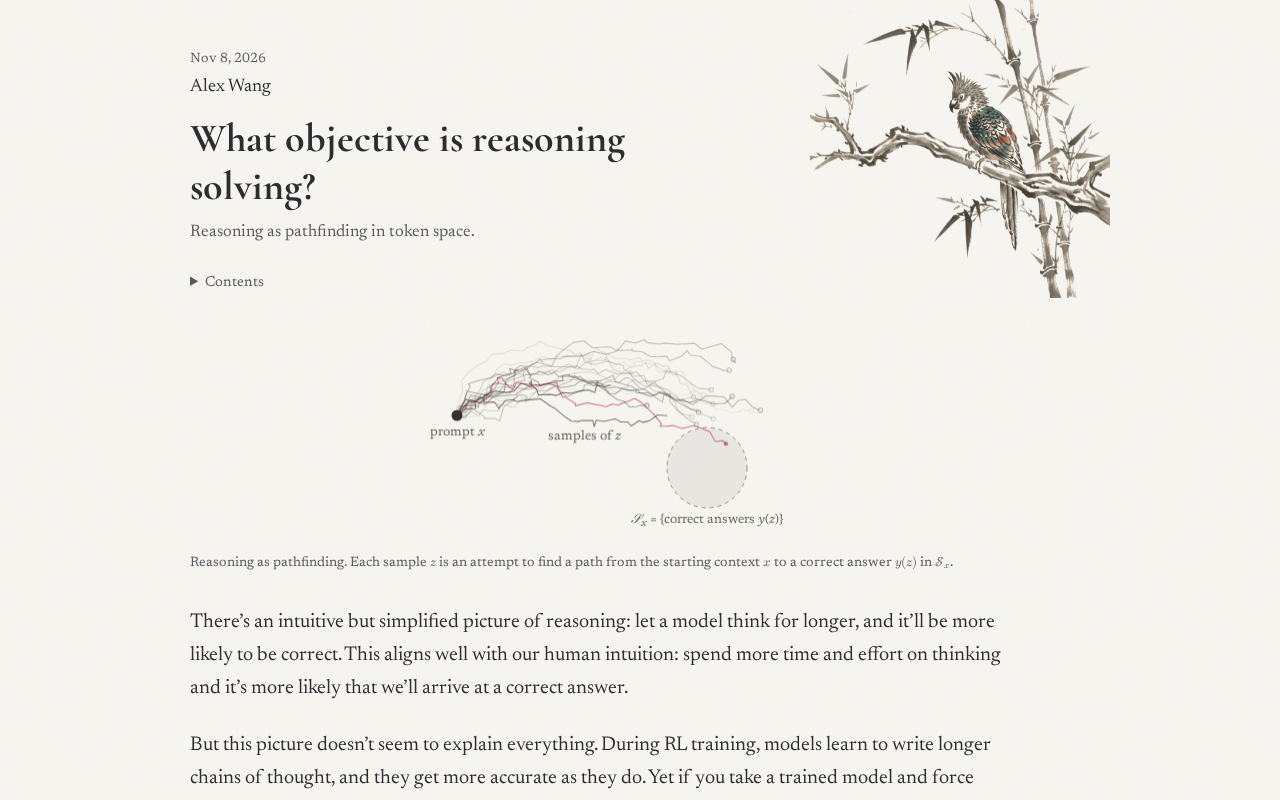
帖子本身只有13个点赞和2条评论,但议题的深度值得展开。当业界将推理等同于“更长的思维链”或“更高的基准分数”时,我们可能忽略了推理的真正价值:它应该帮助模型在不确定环境中做出更好的决策,而非仅仅生成看起来更缜密的文本。
推理与目标:手段与目的的混淆
推理被当作目的本身
当前很多推理研究默认了一个前提:推理能力越强越好。于是,训练数据中加入了大量逐步推导的示例,评测基准也偏向多步逻辑题。但推理本身不是目的——它是实现目标的手段。如果目标定义不清,推理能力的提升可能只是让模型在错误的方向上走得更远。
目标缺失导致的评价偏差
Hacker News的讨论中隐含了一个观点:缺乏明确目标函数时,推理评估容易退化为模式匹配。模型可能学会了“看起来像推理”的输出格式,却未真正解决需要推理的问题。这解释了为什么某些模型在基准测试中表现优异,却在真实场景中频繁出错。
思维链(Chain-of-Thought, CoT) 是让大模型在输出最终答案前生成一系列中间推理步骤的提示或训练方法。其代表性工作来自 Wei 等人 2022 年的论文,核心发现是:当模型被引导"逐步思考"时,在算术、常识和符号推理类任务上的准确率显著提升。此后,CoT 逐渐从提示技巧演化为训练范式,出现了在大量带步骤解答数据上微调的"推理模型"。但 CoT 的有效性也带来一个副作用:模型可能生成格式工整、逻辑外观良好却与最终答案脱节的推理链,即所谓"不忠实推理"(unfaithful reasoning)。这正是文章所批评的"把长思维链等同于推理能力"的技术根源——步骤的长度和形式,并不保证推理真正参与了答案的生成。
基准测试(benchmark)与数据污染(contamination) 是理解"基准高分、真实表现差"这一现象的关键背景。GSM8K、MATH、BBH 等推理基准的题目和参考答案大多公开在互联网上,而大模型的预训练语料正是大规模网络文本,因此测试题很可能已被模型在训练阶段"见过"。这种情况下,高分反映的是记忆与模式匹配,而非推理能力。研究者通常采用改写题目、留出私有测试集或动态生成题目等方式缓解污染,但难以完全排除。此外,基准测试通常只评估最终答案是否正确,不考察推理过程的合理性,这进一步放大了"格式像推理即可得分"的激励偏差。
多源视角:推理目标的两种理解
虽然原帖评论有限,但结合Hacker News社区过往的相关讨论,可以看到两种主流观点。
观点一:推理应服务于决策质量
据Hacker News上多位研究者的分析,推理的核心目标应是在信息不完整时做出更优决策。这意味着推理评估不应只看最终答案对错,还要看决策过程是否在有限信息下合理。这种观点将推理与强化学习中的决策问题联系起来,强调推理的实用性。
观点二:推理是压缩与泛化的工具
另一派观点(来自Hacker News评论区及AI研究者的公开讨论)认为,推理的目标是用更少的样本实现更好的泛化。推理使模型能够将训练中见过的模式组合应用到新情境,本质上是一种压缩和抽象机制。按此理解,推理的“目标”是提升数据效率,而非直接优化决策。
两种观点并非互斥,但侧重点不同:前者关注推理的产出(决策),后者关注推理的机制(泛化)。分歧的根源在于对“目标”一词的理解——是外部任务目标,还是内部学习目标。
最小描述长度(Minimum Description Length, MDL)与"压缩即智能" 为"推理是压缩工具"这一观点提供了理论支撑。MDL 原理认为,最好的模型是能用最短描述编码数据的模型,学习因此等价于寻找数据中的规律性压缩。在这一视角下,推理步骤是把大量具体样例归纳为可复用抽象规则的过程,模型的泛化能力取决于它能否用少量规则覆盖广泛情境。Solomonoff 归纳推理和 Hutter 的 AIXI 理论也沿着类似思路,把智能刻画为对观测序列的最优压缩与预测。这解释了为什么"用更少样本实现更好泛化"可以被视为推理的内部目标,它与文章提到的决策质量视角分别对应学习机制与外部效用两个层面。
对AI实践的启示
重新设计推理评测
如果承认推理服务于决策质量,那么现有评测体系需要调整。除了答案正确率,还应引入决策过程合理性指标,例如在信息缺失时模型是否主动澄清、是否给出置信度合理的备选方案。这比单纯增加推理步数更有意义。
目标定义先于能力提升
对开发者而言,在追求更强推理能力之前,应先明确应用场景的目标函数。是要求高准确率,还是要求低延迟下的可接受决策?是要求可解释的推理链,还是只关心最终结果?目标不同,对推理能力的需求也截然不同。
避免推理军备竞赛
Hacker News的讨论提醒我们,行业容易陷入推理能力的军备竞赛。但若目标不清,更强的推理可能带来更高的计算成本和更长的延迟,却未必改善实际体验。理性做法是根据场景选择推理深度,而非盲目追求“更会思考”的模型。
结语
“推理在解决什么目标”这个问题没有标准答案,但它迫使研究者从能力竞赛中抽身,回到问题本身。无论是决策质量还是泛化效率,明确目标才能让推理能力的进步真正转化为价值。对AI从业者来说,这或许比多刷几个基准分数更重要。
相关推荐

Pi Agent为何不拼功能?极简内核+可扩展设计解析
Pi Agent为何在功能更少的情况下获得高关注?本文解析其极简内核与可扩展设计哲学,探讨MCP、Skills、自定义插件如何让开发者自主控制Agent,并实现项目长期记忆。

Claude Code省钱指南:四大暗坑与三层成本优化
Claude Code 升级 Opus 5.5 后账单依然暴涨?本文拆解官方成本手册揭示的四大漏钱暗坑:缓存断崖、子代理偷跑、High 档溢价与低效输出,并给出三层账本优化方案,附实测成本数据。

Olares One评测:本地AI服务器上手,5000美元值不值?
Olares One个人AI服务器评测:RTX 5090+96GB内存,手机App引导安装,浏览器操作桌面,跑通Ollama本地大模型、ComfyUI图像生成和Hermes AI助手。5000美元定价适合重度AI用户与注重隐私的数据主权追求者。