推理网络:用阈值策略优化大模型推理成本
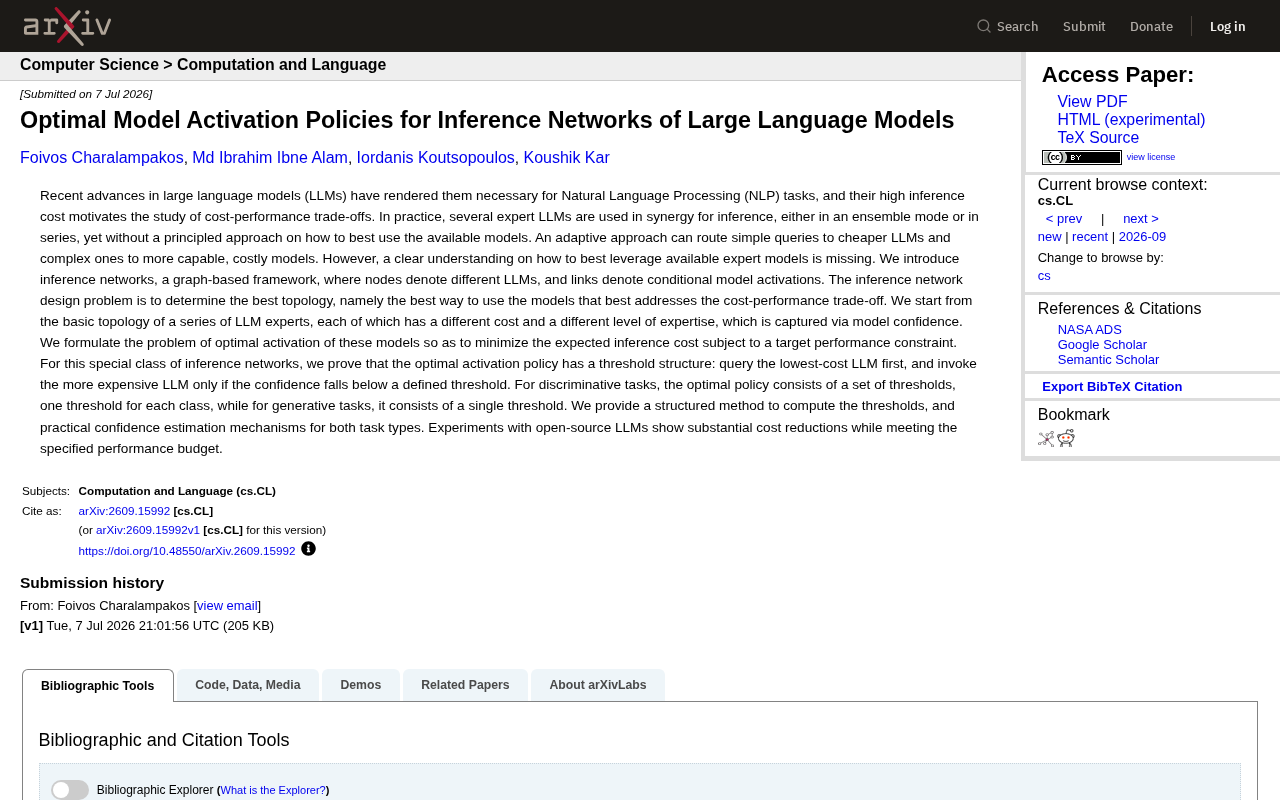
「推理网络」图框架用阈值策略实现多LLM级联的理论最优成本控制
这篇arXiv论文提出「推理网络」框架,将多个专家LLM的协同问题抽象为图结构——节点为模型,边为条件性激活规则。研究聚焦于最基础的串联拓扑,证明了最优激活策略具有「阈值结构」:先调用成本最低的模型,仅当其置信度低于某阈值时才升级到更昂贵的模型。对于判别式任务,每个类别需对应一个独立阈值;生成式任务则只需单一阈值。论文还提供了阈值的推导方法与置信度估计方案,并在开源LLM实验中验证了该策略能在满足性能预算的前提下实现显著成本削减。其核心价值在于将工程经验转化为有理论保证的可执行规则,但当前结果仅覆盖串联拓扑,更复杂的混合结构及置信度在分布漂移下的稳健性仍待进一步研究。
大语言模型(LLM)已成为自然语言处理任务的标配,但高昂的推理成本让成本与性能的权衡成为绕不开的现实问题。一篇发表于 arXiv 的最新研究提出了名为「推理网络」(Inference Networks)的图结构框架,为如何组合使用多个专家模型给出了理论上的最优解。
多模型协同的痛点:缺乏原则性方法
在实际部署中,工程师往往会让多个专家 LLM 协同工作——要么以集成(ensemble)方式并行投票,要么以串联(series)方式逐级调用。直觉上,简单的查询交给便宜的小模型处理,复杂的查询才交给能力强但昂贵的大模型,这种自适应路由(adaptive routing)显然更经济。
问题在于,业界一直缺乏一套系统性的方法来回答「究竟该如何最优地利用手头的这些模型」。什么时候该升级到更贵的模型?升级的判断标准是什么?大多数实践依赖经验和试错,而非可证明的最优策略。这篇论文正是瞄准了这一空白。
推理网络:把模型组合抽象成图
论文的核心贡献是把多模型协同问题抽象为一个图结构框架。在推理网络中,节点代表不同的 LLM,边代表条件性的模型激活(conditional model activations)——即在满足某种条件时才触发下一个模型的调用。
所谓「推理网络设计问题」,就是要确定最优的拓扑结构,也就是找到能最好地平衡成本与性能的模型使用方式。这种图的视角很有价值:它把原本零散的路由、级联、集成等策略统一到同一个数学框架下,使得「最优拓扑」成为一个可以正式定义和求解的优化问题。
图结构在机器学习中并非新概念,但将其用于描述模型调用拓扑是该论文的创新切入点。在传统的级联(cascade)系统中,模型的调用顺序是固定的线性链;而图结构允许表达更丰富的拓扑关系,例如某个节点根据不同条件分叉到多个后继模型,或多个模型的输出汇聚后再做决策。「条件性模型激活」这一概念的关键在于「条件性」三字:每条边携带一个触发规则,只有满足该规则(例如置信度低于阈值、预测类别属于某子集)时,下游模型才会被实际调用,从而避免不必要的计算开销。这种设计使得推理网络天然支持动态计算路径——同一批查询中,不同输入可能激活完全不同的模型子集,整体成本因此可以随输入难度自适应调整。
关键结论:最优策略具有阈值结构
论文从最基础的拓扑入手——一串串联的 LLM 专家,每个模型有不同的成本和不同的专业水平(通过模型置信度 confidence 来刻画)。研究者将问题形式化为:在满足目标性能约束的前提下,最小化期望推理成本。
对于这一类特殊的推理网络,论文给出了一个漂亮的理论结果——最优激活策略具有阈值结构(threshold structure):
- 先查询成本最低的 LLM;
- 只有当该模型的置信度低于某个设定的阈值时,才调用更昂贵的模型。
这个结论的意义在于,它把一个看似复杂的组合优化问题,归结为「算出几个阈值」这样简洁可执行的规则。
判别式任务 vs 生成式任务
论文进一步区分了两类任务的阈值形态:
- 判别式任务(discriminative tasks):最优策略由一组阈值构成,每个类别对应一个阈值;
- 生成式任务(generative tasks):最优策略只需要单一阈值。
这一区分很实用。分类类任务由于输出空间离散、类别间置信度分布差异明显,需要更精细的按类阈值控制;而生成类任务的置信度往往可以用统一的度量来衡量,单阈值即可覆盖。
从理论到落地:阈值计算与置信度估计
仅有理论证明还不够,论文还提供了两个工程层面的关键组件:
- 结构化的阈值计算方法:给出如何根据成本、性能约束推导出具体阈值数值的方法;
- 置信度估计机制:分别针对判别式和生成式任务给出了可操作的置信度估计方案。
这两点决定了该框架能否真正用于生产环境。毕竟阈值策略的有效性完全依赖于置信度估计的可靠性——如果模型对自己的错误答案也给出高置信度,阈值机制就会失效。
置信度校准(confidence calibration)是这里的核心挑战。一个模型的置信度分数是否真实反映其答对的概率,直接决定阈值策略能否奏效。研究表明,大型神经网络普遍存在过度自信(overconfidence)问题——即便预测错误,softmax 输出的概率值也可能接近 1。为此,实践中常用温度缩放(temperature scaling)、Platt scaling 等后处理方法对置信度进行重新校准,使其统计意义上更接近真实准确率。对于生成式任务,置信度的定义本身更为复杂,常见方案包括:对生成序列的对数概率求均值、对多次采样结果进行一致性投票(self-consistency)、或训练专门的验证器模型来评估输出质量。论文针对两类任务分别提供方案,正是对这一工程复杂性的正面回应。
实验结果:显著降本且守住性能预算
论文在开源 LLM 上进行了实验验证。结果显示,采用最优阈值策略后能够实现可观的成本削减(substantial cost reductions),同时满足预先设定的性能预算。
这意味着,与其一味调用最强最贵的模型,不如让便宜模型先「打头阵」,仅在它「拿不准」时才升级。对于需要大规模、高频调用 LLM 的企业而言,这种级联策略在不牺牲整体质量的前提下,能带来实实在在的推理开销节省。
价值与局限
这项工作的最大价值在于把「多模型级联」从工程经验提升到了有理论保证的层面——阈值结构的最优性证明让实践者可以放心地按规则执行,而不必反复调参试错。
不过也应看到,论文当前的理论结果主要针对「串联专家」这一基础拓扑。更复杂的推理网络拓扑(如带分支、并行集成的混合结构)的最优策略仍是开放问题。此外,置信度估计在真实分布漂移场景下的稳健性,也是落地时需要重点验证的环节。总体而言,推理网络为 LLM 成本优化提供了一个既优雅又实用的新视角。
「分布漂移」(distribution shift)是指模型在部署后遇到的真实数据与训练/标定数据分布不一致的现象。对推理网络而言,这意味着用于计算阈值的历史性能数据可能无法代表未来查询,导致预设阈值在新分布下不再最优——原本应升级到更强模型的查询可能因置信度虚高而被廉价模型截留。在实际运维中,需要定期重新标定阈值,或引入在线监控机制来检测性能退化信号。此外,当前框架假设各模型的成本是固定已知的,但云端 API 的计费方式(按 token、按请求、存在并发折扣等)往往更为复杂,如何将动态定价纳入优化目标,是将该框架推向生产的另一个实践挑战。
相关推荐
Ollama 入门指南:本地部署开源大模型的利器
Ollama 是一款免费开源的本地大模型管理工具,支持将 DeepSeek 等开源模型部署到本地。本文介绍 Ollama 是什么、跨平台特性、CPU/GPU 支持及本地部署的应用场景,适合零基础入门 AI 大模型开发。
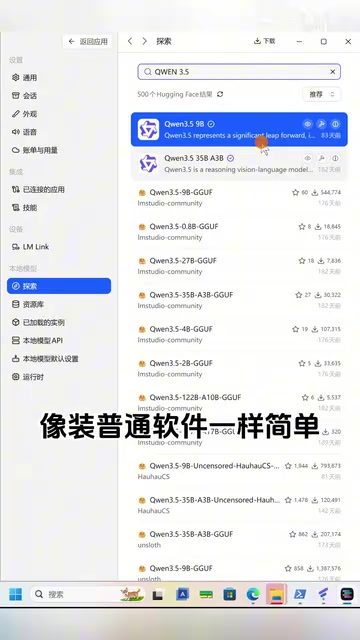
LM Studio、Ollama、vLLM深度对比:本地大模型部署工具怎么选
LM Studio、Ollama、vLLM三款本地大模型部署工具深度对比。从上手难度、适用场景到性能表现全面解析:小白选LM Studio,开发者用Ollama,企业级高并发上vLLM,帮你快速选对工具。
Ollama入门:本地部署开源大模型的核心工具解析
本文详解 Ollama 是什么及其核心价值:作为一款开源免费的大模型管理工具,它能将 DeepSeek 等开源模型部署到本地,支持 GPU/CPU 灵活调度、跨平台运行,并提供 API 与命令行接口,适合搭建私有知识库等场景。