Unity Catalog Pages:为AI智能体打造受治理的业务知识中枢
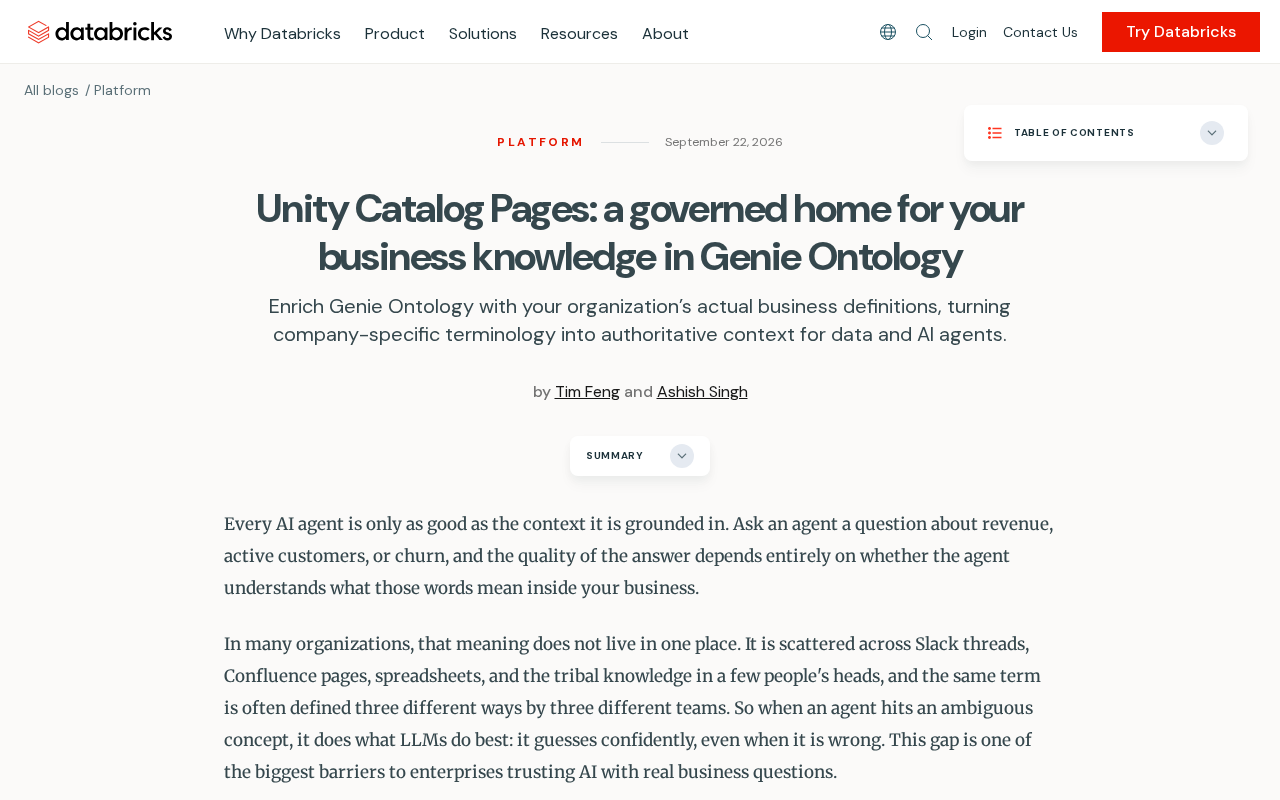
Databricks推出Unity Catalog Pages,将企业业务知识纳入治理体系,为AI智能体提供可信的上下文底座。
Databricks推出的Unity Catalog Pages,是其Genie Ontology语义层体系中的新组件,定位为"受治理的业务知识中枢"。其核心逻辑在于:AI智能体输出质量的上限,取决于它所依据的上下文质量。企业内部散落于文档和员工认知中的业务定义、指标口径、数据关系,如果无法被结构化地、可治理地提供给智能体,模型再强大也难以产出真正可信的业务洞察。Pages将业务知识纳入Unity Catalog的权限控制、血缘追踪和访问审计体系,使其与数据资产的治理框架打通,代表了企业级AI从"能力竞赛"转向"可信落地"的重要趋势。
AI智能体的表现,取决于它掌握的上下文
"每个AI智能体的能力上限,都取决于它所依据的上下文(context)。"这是Databricks在介绍Unity Catalog Pages时给出的核心判断。当你向一个AI智能体提问,如果它对企业内部的业务定义、指标口径、数据关系一无所知,那么它给出的答案往往似是而非,甚至可能误导决策。
这正是当前企业级AI落地面临的普遍困境:模型本身足够强大,但缺乏对特定业务语境的理解。一个财务指标在不同部门可能有不同定义,一张数据表背后可能隐藏着复杂的业务规则,这些"隐性知识"如果无法被结构化地喂给智能体,AI的输出就难以真正可信可用。
Unity Catalog Pages 想解决什么问题
Unity Catalog Pages 被定位为 Genie Ontology 体系中"受治理的业务知识家园"(a governed home for your business knowledge)。从命名可以看出,它试图把散落在文档、Wiki、员工脑海中的业务知识,统一收拢到一个由 Unity Catalog 治理框架管辖的中心位置。
这里有两个关键词值得拆解。一是 governed(受治理)——意味着这些业务知识不再是无人管理的自由文本,而是纳入了权限控制、血缘追踪和访问审计的治理体系。二是 business knowledge(业务知识)——区别于纯粹的数据本身,它指向的是数据背后的业务含义、指标定义和语义层信息。
在 Genie Ontology 的框架下,这套机制的目标是让 AI 智能体在回答业务问题时,能够直接引用经过治理和验证的知识,而不是依赖临时拼凑或凭空推断的上下文。
Genie Ontology 是 Databricks 推出的语义层体系,旨在将企业的业务概念、指标定义和数据关系以结构化方式表达,使 AI 智能体能够"理解"数据的业务含义,而非仅仅操作原始字段。Ontology(本体论)一词来自知识工程领域,在企业数据场景中特指一套描述"事物是什么、事物之间关系如何"的形式化知识模型。例如,"月活用户"这一指标在 Ontology 中不只是一个数字,还会记录其计算口径、统计周期、适用部门和负责团队。Unity Catalog Pages 作为 Genie Ontology 的组成部分,承担的是将这类业务知识以文档化形式沉淀、并纳入统一治理的职责,相当于给每个数据资产配备一份"经审核的业务说明书",供 AI 智能体在推理时直接引用。
为什么"治理"是企业级AI的关键一环
企业在部署 AI 智能体时,最大的顾虑往往不是模型能力,而是数据与知识的可控性。谁能访问哪些知识?某个指标定义是否是最新的、经过审核的版本?智能体调用的信息来源是否可追溯?这些问题如果得不到解答,企业就很难放心地把 AI 用于关键业务场景。
Unity Catalog 作为 Databricks 的统一治理层,其价值在于把数据资产的权限、血缘和目录管理统一起来。而 Pages 的引入,则把这套治理能力延伸到了"业务知识"这一层——不再只治理数据表和列,还治理对这些数据的业务解释。
对于希望构建可信 AI 应用的团队来说,这种"知识即治理对象"的思路,正在成为企业级 AI 架构的重要趋势。让智能体扎根于受治理的知识底座,是提升输出可靠性、满足合规要求的现实路径。
数据血缘(Data Lineage) 是数据治理中的核心能力之一,指追踪数据从产生、流转到消费全链路的能力——即某张报表的数字究竟来自哪张源表、经过了哪些转换步骤。在 AI 智能体场景中,血缘追踪的意义进一步延伸:当智能体给出一个分析结论时,企业需要能够反向追溯它所依据的知识条目是否经过审核、版本是否最新,从而判断输出结果的可信程度。Unity Catalog 将血缘管理从数据资产延伸至业务知识层,意味着知识条目的修改历史、审核状态和引用关系同样可被追踪,这是满足金融、医疗等强合规行业 AI 应用落地要求的重要前提。
对企业AI落地的启示
从这一产品动向可以看出,业界对企业级 AI 的关注点正在从"模型能不能答"转向"模型答得对不对、可不可信"。上下文工程(context engineering)和知识治理,正在成为决定 AI 智能体实用价值的分水岭。
对于正在评估或搭建内部 AI 平台的团队,几点思考或许有参考意义:其一,业务知识的沉淀和结构化不能滞后于模型部署,二者应当同步推进;其二,知识的治理与数据的治理需要打通,避免形成两套割裂的体系;其三,语义层(ontology)的建设是让 AI 理解业务的基础工程,值得提前投入。
需要说明的是,本文基于 Databricks 官方发布的有限信息整理,Unity Catalog Pages 的具体功能细节、使用方式和实际效果,仍有待更完整的产品文档和实践案例进一步验证。
上下文工程(Context Engineering) 是近期在 AI 工程实践中兴起的概念,指系统性地设计、筛选和组织输入给 AI 模型的信息,以最大化其输出的准确性与相关性。与提示词工程(Prompt Engineering)侧重于单次交互的措辞优化不同,上下文工程关注的是在架构层面持续为模型提供高质量、有结构的背景知识。在企业场景中,这意味着需要建立知识管理流程、维护语义层、并将业务定义与 AI 调用管道打通。Unity Catalog Pages 所代表的方向,正是将上下文工程从临时性、个人化的实践,提升为可治理、可复用的企业级基础设施。
相关推荐
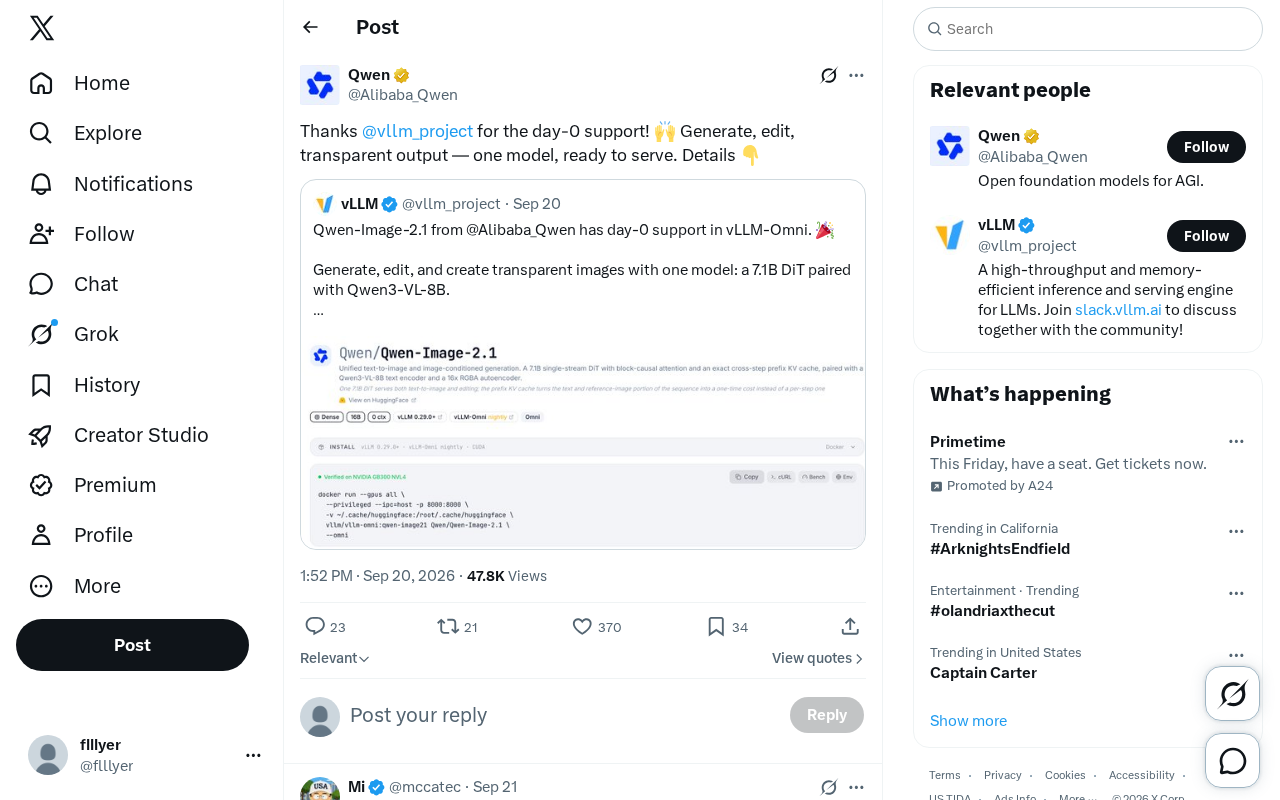
vLLM Day-0支持:单模型实现生成、编辑与透明输出
模型团队宣布获得 vLLM day-0 支持,单一模型即可实现生成、编辑与透明输出,开箱即用。本文解读 day-0 支持的意义、多能力融合趋势与透明输出的价值。
Qwen携手Cerebras:实用AI如何加速解决现实问题
一条社区推文展示了基于开源模型 Qwen 与 Cerebras 硬件加速构建的实用 AI 应用,速度前所未有地快。本文解析开源模型与专用推理硬件结合如何推动 AI 真正落地解决现实问题。
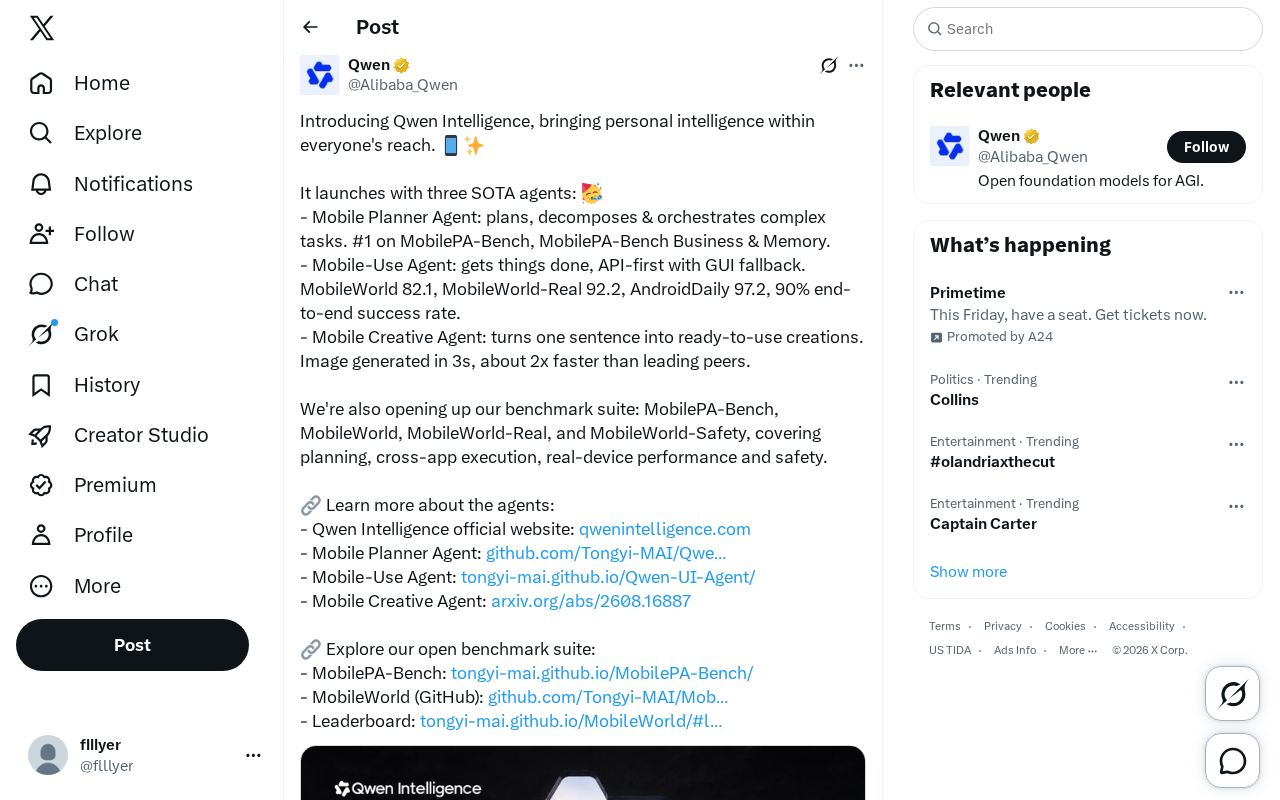
Qwen Intelligence发布:三大SOTA移动智能体登场
阿里通义千问推出Qwen Intelligence,一次带来Mobile Planner、Mobile-Use、Mobile Creative三款SOTA移动智能体,并开源MobilePA-Bench等基准测试套件,覆盖规划、执行、创作与安全评测。