Unsloth v0.1.906 发布:Browser Use 与 Qwen-Image-2.1-Turbo 来了

Unsloth 新版让本地模型能操作浏览器,并带来 8 步出图、文本扩散训练与多项推理加速。
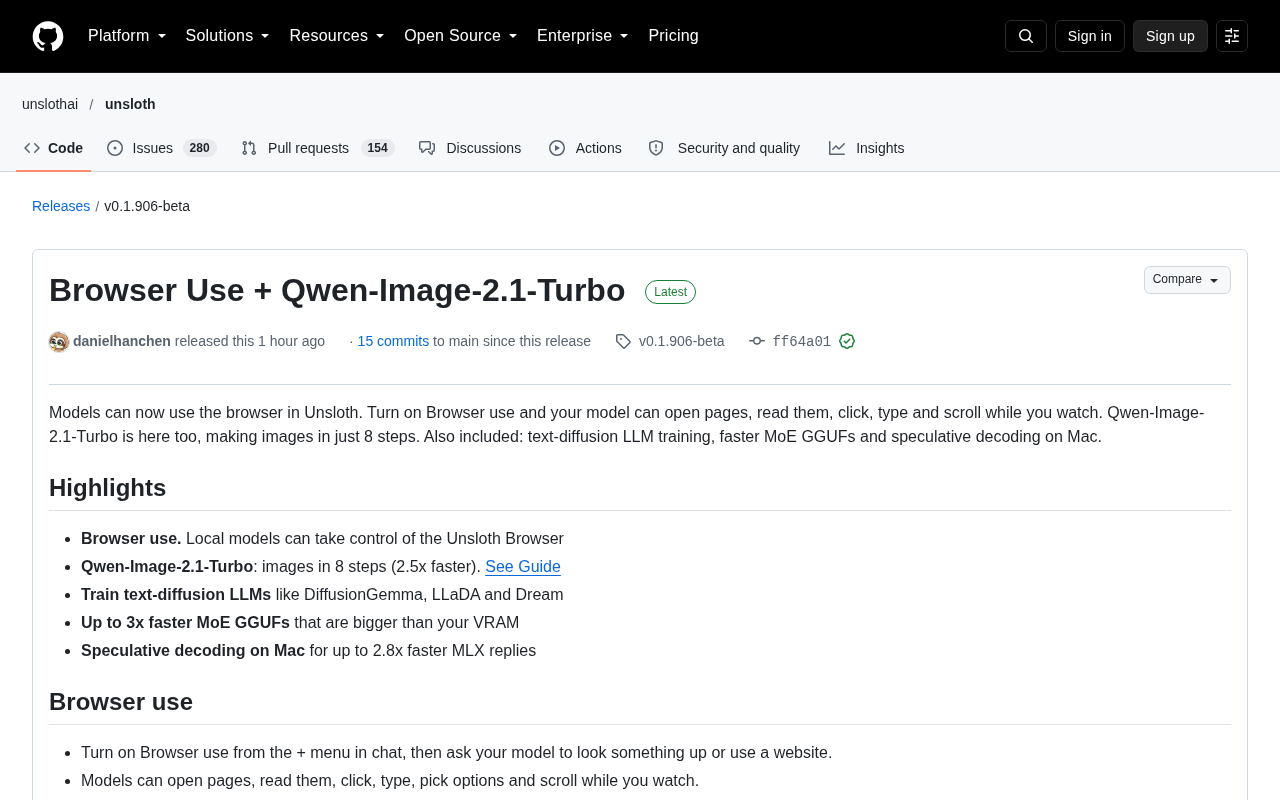
Unsloth 发布 v0.1.906-beta,一次性加入多个方向的能力。最受关注的是 Browser Use:本地模型可在独立标签页中打开网页、读取内容、点击、输入和滚动,并在登录、提交表单或触发购买删除类操作前征求用户确认,密码、卡号和验证码永不代填。图像侧集成官方 8 步版本 Qwen-Image-2.1-Turbo,4.2GB Q4 GGUF,出图速度提升约 2.5 倍,并可复用 ComfyUI 文本编码器。新增 DiffusionTrainer 支持文本扩散 LLM 训练,覆盖 DiffusionGemma、LLaDA、Dream 等模型,同时加入 LoRA+ 和 GPTQ 微调。性能优化包括 MoE GGUF 超显存运行最高 3 倍加速、Mac MLX 投机解码最高 2.8 倍提升。
本地模型终于能自己上网了
Unsloth 发布了 v0.1.906-beta 版本,一次更新塞进了几个方向完全不同的能力:本地模型操控浏览器、8 步图像生成、文本扩散语言模型训练,以及一堆推理加速优化。
danielhanchen 在发布说明中把 Browser use 放在了最显眼的位置。这不是简单的"联网搜索"插件,而是让本地模型直接操作一个真实浏览器标签页——打开页面、读取内容、点击按钮、输入文字、滚动页面,整个过程你都能在旁边看着它操作。模型运行在独立标签页中,无法访问你的其他标签。
据发布说明,Browser use 兼容本地模型和 API 提供商,小型纯文本模型也能用。安全层面有几个硬约束:模型在登录、提交表单或触发购买/发送/删除类按钮前会先征求确认;密码、卡号和一次性验证码永远不会由模型填写。用户可以在 Settings > Browser 中限制模型能打开的站点,以及它对浏览历史和下载内容的访问权限。
Qwen-Image-2.1-Turbo:8 步出图
图像生成方面,Unsloth 集成了 Qwen-Image-2.1 的官方 8 步版本 Qwen-Image-2.1-Turbo,在 Images 页面可直接运行,模型体积为 4.2 GB 的 Q4 GGUF。相比常规版本,8 步采样让出图速度提升了约 2.5 倍。
对 ComfyUI 用户来说有个实用改动:现在直接复用 ComfyUI 文件夹里已有的文本编码器,不再重复下载一份。在 Unsloth 里训练的 image LoRA 可以导出为可复用或分享的文件,也支持从本地文件夹加载图像 LoRA。
文本扩散模型训练支持
这个版本另一个值得关注的方向是文本扩散语言模型(text-diffusion LLM)的训练支持。新增的 DiffusionTrainer 可以训练 DiffusionGemma、LLaDA、LLaDA2、Dream、Nemotron 和 SDAR 等模型。
这属于比较前沿的探索方向——传统 LLM 按 token 顺序生成,而扩散模型通过逐步去噪生成文本。Unsloth 把这套训练流程做进了一键式 UI,降低了尝试门槛。同时加入的还有 LoRA+ 训练(通过 loraplus_lr_ratio 设置)以及对 GPTQ 模型的 LoRA 微调支持。
据发布说明,细调工具调用数据集时,训练现在会自动包含每行数据的工具定义,并支持多轮 agent 轨迹。
文本扩散模型是与主流自回归 LLM 截然不同的一条技术路线。传统 GPT 类模型按从左到右的顺序逐个生成 token,每个位置的输出依赖于之前所有已生成的内容;而扩散模型借鉴图像生成中的去噪思路,从一个充满噪声的完整序列出发,经过多轮迭代逐步还原出干净的文本。这意味着模型在每一步都能"看到"整段序列的全局信息,天然支持任意位置的并行生成和迭代修正。代表工作包括 LLaDA、Dream 等,它们在某些推理任务上展现出与同规模自回归模型相当甚至更好的表现,且理论上可以通过减少去噪步数来加速生成。Unsloth 把这类模型的训练流程做成开箱即用的 DiffusionTrainer,对想尝鲜这一前沿方向的开发者来说,最大的价值在于省去了自己拼装训练循环、处理掩码和噪声调度的工作量。
性能优化:MoE、MLX 与投机解码
性能侧的改动相当密集。MoE GGUF 模型即使体积超过显存,在 NVIDIA 和 AMD GPU 上也能跑到最高 3 倍的加速;未安装 flash-attn 和 xformers 时,sample packing 训练提速最高 8 倍(NVIDIA,PyTorch 2.12+)。
Mac 用户这次拿到的提升更明显。MLX 推理后端加入投机解码后,回复速度最高提升 2.8 倍,输出结果保持一致。MLX 投机解码会自动设置 draft depth,并支持 MTP、DFlash、DSpark 和 EAGLE-3 等多种 draft 模型。
macOS 上的决策模型训练也有进展:Laya 和 Clef 决策模型现在可以在 Apple Silicon 上训练,Clef 还支持图像训练。
MoE(混合专家)模型由多个"专家"子网络组成,每次前向推理只激活其中少数几个专家,因此总参数量可以做得很大,实际计算量却只相当于一个小模型。但这种稀疏激活带来了显存访问的不规则性:权重仍然需要全部驻留或按需换入,部分专家可能需要从系统内存甚至磁盘流式加载,导致带宽成为瓶颈。Unsloth 这次的优化让 MoE GGUF 模型即使总权重超过显存,也能借助分层卸载和预取策略在 NVIDIA 与 AMD GPU 上获得最高 3 倍加速。对于在消费级显卡上跑大 MoE 模型的用户,这类优化往往比单纯压缩量化位数收效更明显。
投机解码是一种"用便宜模型猜、用大模型验"的加速技术。它先用一个小型 draft 模型快速生成若干候选 token,再让目标大模型一次性并行验证这些候选,接受其中与自身预测一致的部分。由于大模型验证一批 token 的耗时接近生成单个 token,整体吞吐往往能提升数倍,而输出质量理论上与纯大模型解码完全一致。MLX 是苹果为 Apple Silicon 打造的机器学习框架,能充分利用统一内存和 Metal 加速。本次 Unsloth 在 MLX 后端加入投机解码后,Mac 上回复速度最高提升 2.8 倍,同时自动调整 draft depth,并兼容 MTP、DFlash、DSpark、EAGLE-3 等多种 draft 模型,让 Mac 本地推理的性价比明显提高。
Chat 与桌面端体验
Chat 界面的 React 代码块(JSX 和 TSX)现在可以直接在浏览器中作为实时预览运行。Deep Research 功能支持将 MCP 工具作为引用源,失败重试时会从已完成的步骤继续,而不是从头重来。
Unsloth 现在会读取 Unsloth home 和项目文件夹中的 AGENTS.md 文件,将其内容注入聊天指令。桌面端项目可以直接在你电脑上已有的文件夹中运行工具。语音方面,开启 Settings > Voice 中的"Read replies automatically"后,每条回复完成后会自动朗读。
模型支持与引擎扩展
AMD GPU 用户(Linux 和 Windows WSL)现在可以使用可选的 vLLM 引擎。版本还新增了对 DeepSeek广告-OCR 和 DeepSeek-OCR-2 的支持,Hub 模型列表可按参数量、上下文长度和所属组织筛选。
多用户安装场景下,管理员可以限制每个托管账户能使用哪些模型。详细的 Live monitor 可查看 GPU 负载、温度和功耗。
从提交记录看,这次发布的改动数量很大,涉及安装器修复、ROCm 兼容性、Windows 路径处理、RAG PDF 解析性能等多个工程细节。如果对这些底层修复感兴趣,可以翻看附带的 changelog。
相关推荐

“黑色十月”:AI挖出史上3%严重漏洞?
Reddit 热帖称过去一个月发现了史上 3% 的严重软件漏洞,被称为「黑色十月」。本文拆解这一说法的统计口径问题,分析 AI 辅助代码审计如何加速漏洞发现,以及开发者和企业该如何应对补丁窗口缩短的挑战。

微软Project Gecko:用AI为非洲农民架起语言桥梁
微软Project Gecko项目推出PharmaChat应用,让非洲农民用母语提问,通过AI返回精准视频片段和农耕书籍章节。项目还发布三个交互式手册,推动包容性AI发展。

Node.js语音笔记App:语音转文字API选型指南
为Node.js语音笔记应用选择语音转文字API?对比AssemblyAI、Deepgram、Google Cloud和Whisper的免费额度、定价与Node集成体验,给出分阶段选型建议。