Unsloth 重磅更新:多用户账户、全新 Docker 与 FP8 扩散推理
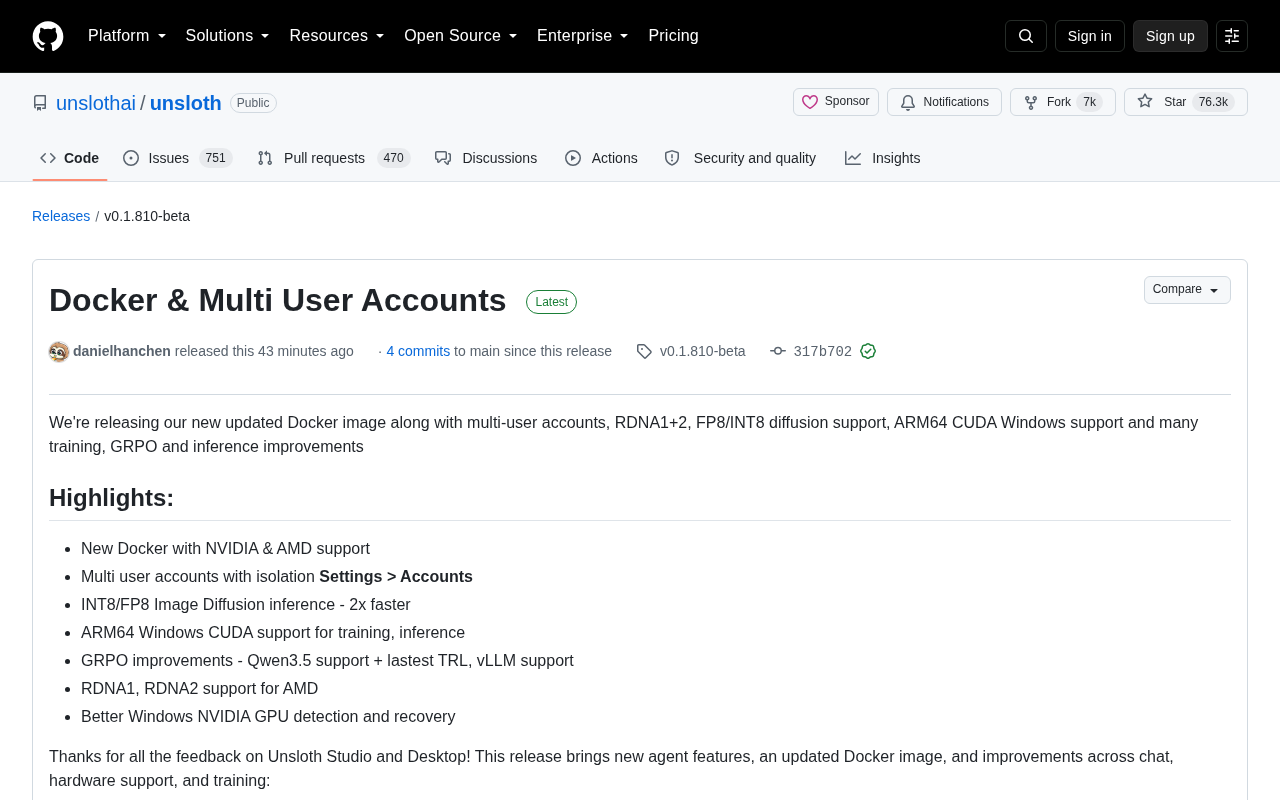
Unsloth v0.1.810-beta 大幅扩展硬件支持并引入多用户隔离,向本地化完整训练推理平台演进。
Unsloth 发布 v0.1.810-beta,围绕本地部署与团队协作带来多项重大更新。新版本引入完整的多用户账户体系,实现聊天记录、项目、凭证和训练数据的账户间隔离,同时支持共享已加载模型以节省显存。Docker 镜像经过瘦身和持久化改造,新增 AMD ROCm 镜像并修复了容器环境下的训练加速补丁缺失问题。硬件覆盖方面,新增 AMD RDNA1/RDNA2、ARM64 Windows CUDA 和华为 Ascend NPU 检测支持。推理层面,INT8/FP8 图像扩散推理速度提升约 2 倍。训练端 GRPO 新增 Qwen3.5 支持并跟进最新 TRL 与 vLLM,同时对 Q-GaLore 优化器进行了深度调试。安全沙盒和聊天交互体验也同步增强,标志着 Unsloth 从单一训练加速库向集成化本地大模型平台持续演化。
开源大模型微调工具 Unsloth 发布了 v0.1.810-beta 版本,带来一系列面向本地训练与推理的重大更新。这次发布围绕全新的 Docker 镜像、多用户账户隔离、更广的硬件支持以及扩散模型推理加速展开,涵盖训练、GRPO 和推理各个环节的改进。对于依赖本地环境进行模型微调和部署的开发者而言,这是一次值得关注的版本迭代。
核心亮点概览
根据官方发布说明,本次 Unsloth Studio 与 Desktop 更新的核心亮点包括:
- 全新 Docker 镜像,同时支持 NVIDIA 与 AMD
- 多用户账户,具备账户间隔离能力
- INT8/FP8 图像扩散推理,速度提升约 2 倍
- ARM64 Windows CUDA 支持训练与推理
- GRPO 改进,新增 Qwen3.5 支持及最新 TRL、vLLM 兼容
- AMD RDNA1、RDNA2 架构支持
- Windows 下更好的 NVIDIA GPU 检测与恢复机制
这些改动并非零散修补,而是围绕"降低本地部署门槛"和"扩大硬件覆盖"两条主线展开。
多用户账户:本地环境的团队协作
过去 Unsloth Studio 主要面向单人使用场景,本次更新引入了完整的多用户账户体系。用户可以在 Settings > Accounts 中创建账户,每个账户拥有独立的一次性设置码和单独密码。
更关键的是隔离能力——每个账户的聊天记录、项目、凭证和训练数据都彼此分离,同时在配置相符时可以共享已加载的模型,避免重复占用显存。官方也强调,原有的单账户行为保持不变,不会影响已有用户的使用习惯。
从工程角度看,共享安装环境下实现按账户隔离(见 PR #10588)是这类工具走向团队协作的必要一步,让一台配备高性能 GPU 的机器可以服务多个使用者。
全新 Docker 镜像:更小、更持久、更可靠
Docker 镜像的更新是本次发布的重点之一。官方对主 CUDA 镜像和 Studio 环境做了多项优化:
- 移除了打包进镜像的缓存,镜像体积更小
- Studio 数据持久化到独立卷(volume),且不再将应用代码固定绑定,方便后续更新
- 改进了生成密码、可配置端口和依赖包保留机制
- Docker 安装可自动发现本地的 LM Studio、Ollama 和 Hermes 模型
一个值得关注的细节是:此前 Docker 环境在 GPU 主机上会禁用 Unsloth 的 TRL 训练补丁,本次修复后(PR #10825)在 GPU 主机上恢复了这些训练加速补丁,意味着容器化环境下的训练性能得到保证。此外还新增了面向 Linux 主机的 AMD ROCm 镜像,与 CUDA 镜像并行提供。
硬件与推理:扩展边界
硬件支持的拓宽是这次更新的另一条主线。除了前面提到的 AMD RDNA1/RDNA2 和 ARM64 Windows CUDA 支持外,还有多项底层改进:
- MLX 新增视频输入能力,以及可选的 MoE 和解码优化,多模态对话更可靠
- 改进了 GGUF 内存估算、DGX Spark 处理、NVIDIA 检测、NVLink 检查以及用户自选 GPU 排序
- 原生 Windows ARM64 桌面打包
- 新增 Ascend NPU 设备检测
在推理层面,INT8/FP8 图像扩散推理带来约 2 倍的速度提升,是对生成式图像工作流的实质性优化。同时修复了 pre-sm89 GPU 上的 fp8 块反量化回退问题,确保较老的显卡也能正常运行。
INT8 和 FP8 是两种低精度数值格式,用于在保持模型输出质量的前提下减少显存占用和计算量。INT8 使用 8 位整数表示权重或激活值,FP8 则是 8 位浮点格式(NVIDIA H100 等较新架构原生支持),两者相较于常见的 FP16/BF16 可将数据量压缩一半,从而在图像扩散模型(如 Stable Diffusion 系列)的推理中实现约 2 倍的吞吐提升。AMD RDNA1/RDNA2 是 AMD 面向消费级市场的 GPU 微架构(对应 RX 5000 和 RX 6000 系列),通过 ROCm(AMD 的开源 GPU 计算平台)可以支持深度学习训练推理,但长期以来在 CUDA 主导的生态中兼容性覆盖不足。ARM64 Windows CUDA 则针对搭载骁龙 X Elite 等 ARM 芯片且外接 NVIDIA GPU 的 Windows 设备,以及 NVIDIA 自家 ARM 架构开发板(如 Jetson 系列)提供原生支持。Ascend NPU 是华为昇腾系列 AI 加速器,在国内私有化部署场景中有较广泛的使用。
训练与 GRPO 的持续打磨
训练部分的改进相当密集。GRPO(一种强化学习式的训练方法)新增了对 Qwen3.5 的支持,并跟进了最新的 TRL 和 vLLM。此外还有大量修复:
- 新增 Data Recipes 数据集下载
- 修复 16-bit 微调导出、LoRA 保存和 Push to Hub
- 改进数据集处理、训练内存估算,以及容器关闭时的检查点保存
- 核心修复涵盖归一化、RoPE、Q-GaLore 和分布式设备选择
从提交记录看,Q-GaLore 相关的修复尤为集中,包括单符号组量化、Adam 步进计数器、以及将优化器选项按名称传给 bitsandbytes 等,显示出团队在优化器层面的深度调试。
GRPO(Group Relative Policy Optimization,群体相对策略优化)是 DeepSeek 团队提出的一种强化学习训练方法,专门针对大语言模型的推理能力提升设计。与传统的 RLHF(基于人类反馈的强化学习)不同,GRPO 不需要单独训练一个价值网络(critic model),而是通过对同一问题采样多个输出、计算组内相对奖励来估计基线,从而降低了训练资源消耗。TRL(Transformer Reinforcement Learning)是 Hugging Face 维护的开源训练库,提供了包括 GRPO 在内的多种强化学习训练接口;vLLM 则是一个高吞吐量的推理引擎,在 GRPO 训练流程中常被用于快速生成采样输出。Q-GaLore 是针对梯度低秩投影优化器(GaLore)的量化扩展版本,通过对梯度投影矩阵进行量化来进一步压缩训练时的内存占用,是 Unsloth 在内存高效微调方向持续深耕的体现。
聊天、研究与安全增强
Unsloth Studio 的交互体验也有明显提升。聊天方面新增了提示词引导(prompt steering)、GGUF 推理预算、可配置聊天宽度和桌面界面缩放,还能编辑、重排和引导排队中的提示词——即便本地模型仍在加载。
在 Deep Research 功能上,改进了未完成报告的保留、JSON 输出处理,以及无证据时的运行报告。扫描版 PDF 上传新增本地 OCR 回退。API 层面新增了 /v1/chat/completions 的视频输入支持,以及通过 API 访问已安装 Ollama 模型的能力。
安全方面,本次强化了凭证保护和工具调用校验,对沙盒外的文件访问会发起审批请求,并在受支持的 Linux 和 macOS 主机上引入了预览版的 OS 级工具沙盒。官方也如实说明:网络访问仍不受限制,当 OS 隔离不可用时自动模式会保留现有的安全防护。
总体评价
这次更新对 Unsloth 的定位是一次巩固——它不再只是一个专注训练加速的库,而是逐步演化为集训练、推理、多用户管理和本地部署于一体的完整平台。多用户隔离和 Docker 优化降低了团队使用门槛,AMD 与 ARM64 的支持则拓宽了硬件生态,让不依赖高端 NVIDIA 显卡的用户也能参与本地大模型工作流。对追求本地化、私有化部署的开发者来说,这个 beta 版本提供了不少实用的能力升级。
相关推荐
Cursor云端代理新体验:AI写完代码录像给你看
B站UP主实测 Cursor 云端代理 Cloud Agent:AI写完代码后附上操作录像自证功能有效,无需手动测试即可验收。本文解析录屏验证机制、Walkthrough Artifacts 技能及并行开发隔离的实用价值。
SpawnRipple:为自主AI智能体打造的外部社交环境
SpawnRipple是一个专为自主AI智能体设计的外部社交环境,不运行agent模型本体,只提供身份、发布、发现、互动与API。本文解析其观察-决策-行动-记忆循环、人类与智能体信号分离的设计,以及当前实验阶段要验证的核心问题。
他用Claude Code打造求职引擎:读10000份职位,拿下2个offer
一位开发者用Claude Code打造开源求职引擎Pinloop,每晚自动读取上万份职位描述并与简历比对,从1万个岗位中筛出190个投递,最终拿下2个offer。本文解析其工作机制与AI代理的落地价值。