VersatIL:解决模仿学习代码碎片化的模块化PyTorch框架

在机器人学习领域,模仿学习(Imitation Learning, IL)和行为克隆(Behavioral Cloning, BC)已成为主流范式。模仿学习让智能体通过观察专家示范来习得策略,无需手动设计奖励函数;行为克隆是其中最直接的子类,将专家的状态-动作对作为监督学习数据,直接训练一个映射策略。由于对复杂物理交互进行奖励建模极为困难,而人类示范数据则相对容易采集,这两种方法在机器人操控领域得到了广泛应用。然而,围绕这些方法构建的代码生态却存在着惊人的碎片化和重复劳动问题。近日,一位专注于手术机器人模仿学习的博士生开源了一个名为 VersatIL 的 PyTorch 框架,试图从架构层面解决这一痛点。
问题根源:70+ 个相互复制的代码库
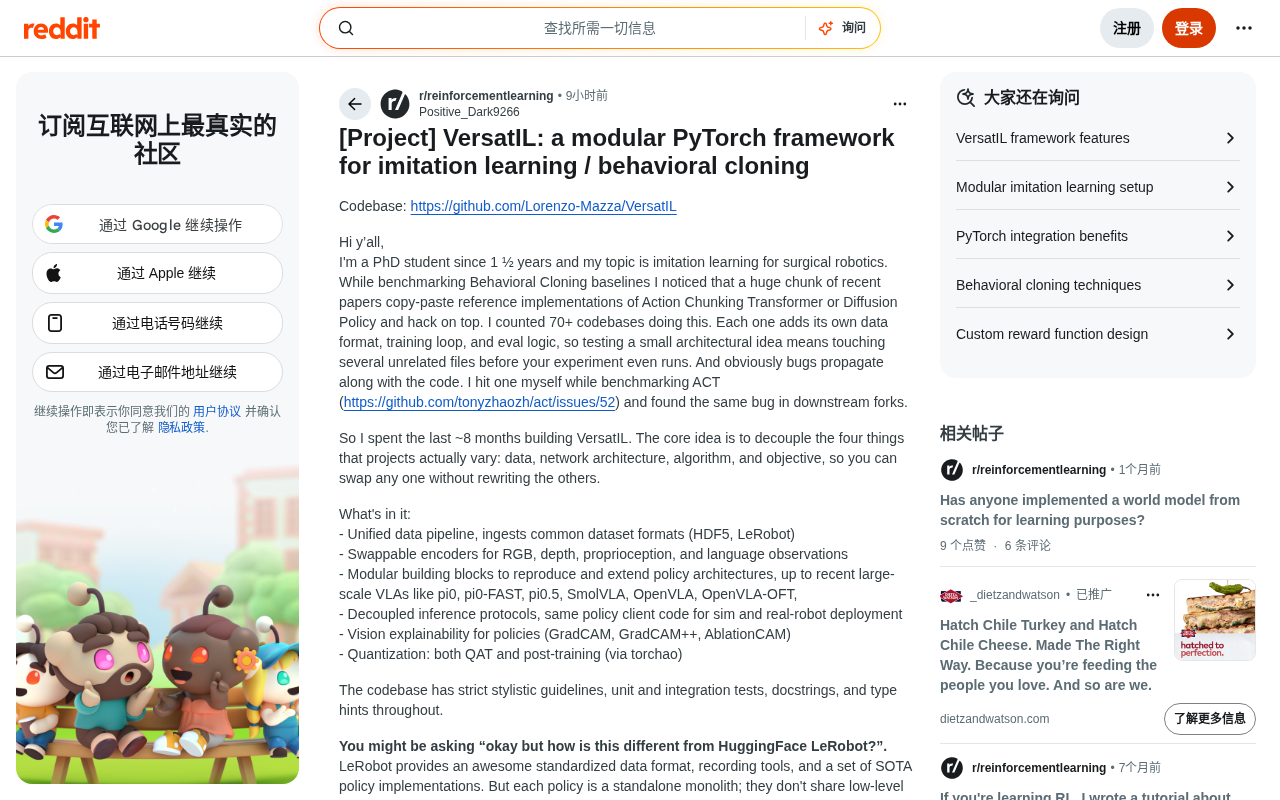
这个项目的诞生,源于作者在做基准测试时的一个亲身观察。据其在 Reddit 上的分享,他为博士课题(手术机器人的模仿学习)对行为克隆基线进行基准测试时,发现近期大量论文的做法惊人地一致:直接复制粘贴 Action Chunking Transformer(ACT) 或 Diffusion Policy 的参考实现,然后在此基础上修改。
ACT 由斯坦福大学 Tony Zhao 等人于 2023 年提出,核心创新是「动作分块」——预测未来一段时间窗口内的动作序列而非单步动作,并结合 Transformer 架构与条件变分自编码器(CVAE)处理动作的多模态分布。Diffusion Policy 则将扩散模型(Denoising Diffusion Probabilistic Models)引入机器人控制,通过迭代去噪过程生成高质量动作序列,能天然处理动作空间的多峰分布问题。两者均在桌面操控任务上取得了显著的 SOTA 结果,因此成为领域内被大量复制的基线实现。
作者统计发现,采用这种「复制-魔改」模式的代码库超过了 70 个。每一个都自带一套数据格式、训练循环和评估逻辑,带来的直接后果是:想验证一个小小的架构改进,往往需要改动多个彼此无关的文件,实验才能勉强跑起来。
更严重的是 bug 的传播链。作者在对 ACT 做基准测试时踩了一个坑(对应 GitHub issue #52),随后发现同样的 bug 在多个下游分支中被完整继承。这正是「复制粘贴式科研」的隐性代价——错误会随着代码血脉一路蔓延。
核心设计理念:解耦四大研究变量
为解决上述问题,作者历时约 8 个月构建了 VersatIL。其核心思想清晰明确:将实际研究中真正会变化的四个维度彻底解耦。
这四个维度分别是:
- 数据(Data):不同任务、不同机器人产生的异构数据
- 网络架构(Network Architecture):编码器、骨干网络等组件
- 算法(Algorithm):具体的策略学习方法
- 目标函数(Objective):训练优化的损失目标
通过这种解耦设计,研究者只需替换其中一个组件,无需重写其余部分。例如想验证「换一个视觉编码器会怎样」,完全不必去动策略实现的其他部分。对于需要快速迭代实验想法的研究者而言,这种灵活性价值巨大。
框架核心能力盘点
从功能清单来看,VersatIL 的完成度相当可观。
统一的数据管线
框架提供统一的数据处理流程,原生支持 HDF5 和 LeRobot 两种主流数据集格式。HDF5(Hierarchical Data Format 5)是科学计算领域广泛使用的高性能二进制存储格式,适合存储大规模多模态机器人轨迹数据;LeRobot 格式则是 HuggingFace 推出的标准化机器人数据集规范。不同来源的数据可被同一套逻辑处理,大幅降低适配成本。
可替换的多模态编码器
VersatIL 支持针对 RGB 图像、深度图、本体感知(proprioception)以及语言观测的可插拔编码器,让多模态输入的处理真正做到灵活可组合。本体感知指机器人对自身关节角度、末端位姿、力矩等状态的感知,是策略学习中与视觉输入同等重要的模态。
覆盖前沿的大规模 VLA 模型
视觉-语言-动作模型(Vision-Language-Action Model, VLA)是近年机器人学习的重要范式转变,将大型视觉语言模型(VLM)的表征能力迁移至机器人控制任务,利用互联网规模的预训练知识提升策略泛化能力。框架提供模块化构建块,用于复现和扩展各类策略架构,覆盖近期主流的 VLA 模型,包括 pi0、pi0-FAST、pi0.5、SmolVLA、OpenVLA、OpenVLA-OFT 等。其中 pi0 系列由 Physical Intelligence 公司开发,基于流匹配(Flow Matching)实现高频灵巧操控;OpenVLA 由斯坦福等机构联合发布,是基于 Llama 架构的开源 VLA 基线;SmolVLA 则专注轻量化部署。追踪领域前沿颇具竞争力。
解耦的推理协议与机器人部署
框架采用解耦的推理协议,同一套策略客户端代码既可用于仿真环境,也可直接用于真实机器人部署,为 sim-to-real 研究流程提供了实实在在的便利。sim-to-real(仿真到现实迁移)是机器人学习领域的核心挑战之一,统一的推理接口能显著降低跨环境适配的工程负担。
可解释性与量化支持
VersatIL 内置策略的视觉可解释性工具(GradCAM、GradCAM++、AblationCAM)。GradCAM(Gradient-weighted Class Activation Mapping)及其变体通过计算目标输出对卷积层特征图的梯度加权激活,生成热力图来可视化模型「关注」的图像区域,帮助研究者诊断策略是否真正聚焦于任务相关的视觉特征(如目标物体),而非依赖无关背景信息。
框架同时具备完整的量化能力——支持量化感知训练(QAT)和训练后量化(借助 torchao 实现)。模型量化将神经网络权重从高精度浮点数(FP32)压缩为低比特表示(INT8/INT4),可显著减少模型体积并提升推理速度,对于 VLA 等大型模型在机器人边缘端实现实时控制至关重要。torchao 是 PyTorch 官方的量化与稀疏化库,提供从研究到生产的完整工具链。
与 HuggingFace LeRobot 的关键区别
面对这一领域绕不开的 LeRobot,作者主动做了定位说明,这也是理解 VersatIL 价值的关键。
LeRobot 提供了标准化的数据格式、录制工具以及一套 SOTA 策略实现。但其中每个策略都是一个独立的「单体(monolith)」,彼此之间并不共享底层基础设施。
VersatIL 走了一条相反的路:在成熟的现成组件之上构建——语言模型用 transformers,视觉编码器用 timm,数据格式沿用 LeRobot,量化用 torchao——但每一个策略都在共享的底层 PyTorch 骨架上从零重新实现。
这一差异使得实验变得「低成本」:你可以在不 fork 整个实现的前提下,自由替换某个 SOTA 策略的编码器、动作头或目标函数。简言之,LeRobot 追求「开箱即用的标准实现」,VersatIL 追求「便于实验变体的共享地基」,二者定位互补而非替代。
现状与社区展望
作者坦诚说明了当前局限:这是一个 v0.5 版本,参考策略集合仍在持续扩充中。项目主要由作者独立开发,并借助编程智能体(coding agents)辅助完成,所有代码均经过本人审阅和测试,配备了严格的代码风格规范、单元测试与集成测试、文档字符串和类型注解,但部分代码读起来可能仍显粗糙。
对于从事模仿学习(IL)和行为克隆(BC)研究的开发者而言,VersatIL 提供了一个值得认真评估的选择——尤其是那些饱受「复制粘贴魔改」之苦的研究者。作者明确表示,如果你的工作流无法映射到框架的抽象设计上,这恰恰是他最需要的反馈,欢迎提交 Issue 和 PR。
从更宏观的视角看,VersatIL 折射出机器人学习社区一个日益迫切的需求:在算法快速演进的同时,工程基础设施的标准化与可复用性亟待跟上。一个设计良好的模块化框架,或许能显著降低整个领域的实验门槛与错误率。
核心要点
相关推荐

只想要一个自定义域名邮箱,为何如此艰难?
拥有一个自定义域名邮箱看似简单,实则涉及 SPF/DKIM/DMARC 配置、IP 信誉、托管服务成本等诸多难题。本文梳理自建与托管方案的权衡,并给出实用建议。

Claude意外帮用户发现燃气泄漏:AI助手的安全应用边界
一位Reddit用户借助AI助手Claude识别出家中燃气泄漏隐患,PG&E上门确认并修复。本文分析AI助手在家庭安全场景中的真实价值与使用边界,以及处理燃气泄漏的正确做法。

Gemini 4 Argon发布:谷歌重返前沿,但故事没那么简单
谷歌时隔半年发布前沿模型Gemini 4 Argon,跑分重返一线却暂不开放。本文解析其基准表现、与Sonnet 5.5的竞争,以及模型能力与产品体验之争。