Vibe Coding的20个真实坑:新手用AI写代码前必读

Vibe Coding 的九种翻车特质:过度生成、自信幻觉、上下文盲区与理解债。
文章以"先用 AI 开 20 个 PR"为门槛,系统梳理了 Vibe Coding(把写代码主要交给 AI、自己只负责接受或拒绝建议)中常见却易被新手忽视的特质。作者用"你说了什么/AI 做了什么/结果是什么"的对话形式,归纳出过度生成、自信幻觉与过时信息、上下文窗口局限、指令不服从与模糊"优化"、测试自我闭环、重复生成导致理解债等问题,并逐条分析其成因。结论是:Vibe Coding 并非不可用,但它把写代码的成本转移成了理解代码的成本,使用者必须约束改动范围、核查包名版本、提供完整上下文、让测试对准真实需求,并对每一行 diff 保持审查。
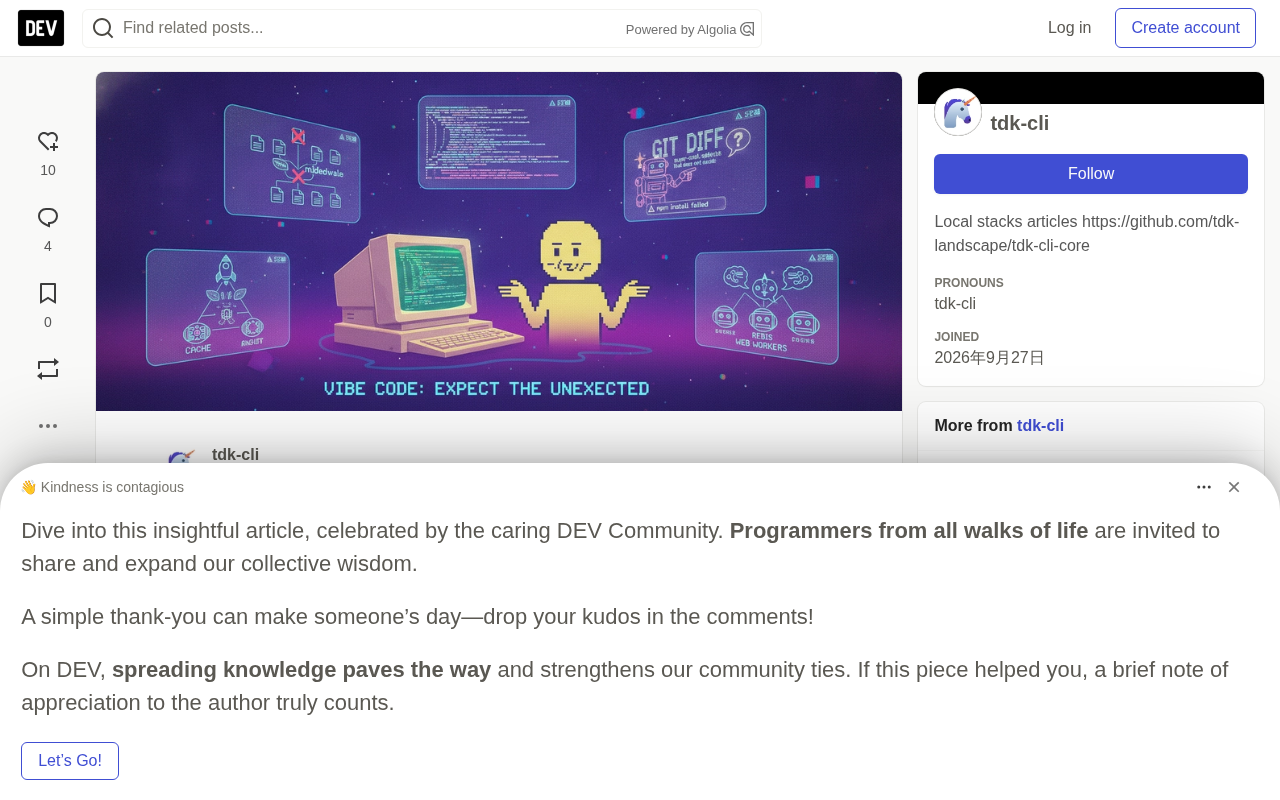
你听说过 Vibe Coding 吗?在回答之前,原作者给了一个很实在的门槛:先用 AI 开 20 个 PR,至少被坑过一次,再回来聊。这篇文章整理的,正是那些"用 AI 写代码"时经常发生、但新手往往意识不到的特质(idiosyncrasies)。作者声明,其中有些只是展示 AI 辅助编程的古怪之处,并非鼓励最佳实践。
什么是 Vibe Coding?
Vibe Coding 指的是把写代码的主要工作交给 AI——你用自然语言描述需求,AI 生成实现,你负责接受或拒绝建议。Cursor、Claude、Grok、ChatGPT 等工具的普及,让这种工作方式门槛极低。
门槛低不等于风险低。原文用一组"你说了什么 / AI 做了什么 / 结果是什么"的对话,把常见的翻车场景串了起来。下面按主题重新梳理,并加上一些分析。
PR(Pull Request) 是代码协作中的核心机制:开发者在一个独立分支上完成修改后,向主分支发起合并请求,由他人(或自动化工具)审查 diff、运行 CI 测试,确认无误后才合入。原文用"先开 20 个 PR"作为门槛,正是因为 PR 流程会强制你逐行审视 AI 生成的每一处改动——而这恰恰是 Vibe Coding 最容易跳过的一步。只接受建议、不看 diff,等于放弃了 PR 审查这层质量关卡。
diff 指两次代码版本之间的差异,以 +/- 逐行标出新增和删除。它是审查 AI 改动的唯一可靠依据:diff 越小越集中,越容易判断是否正确;一旦 AI 顺手重构了半个模块,diff 就会膨胀到无法逐行核对,审查实际上失效。
过度生成:你只要一扇门,AI 给了整栋楼
原文的第一个例子就很典型:
你说"加一个登录表单",AI 直接生成了一个带鉴权、中间件、数据库和测试的完整 Next.js 应用。
结果是:你多了 47 个没要求的文件,中间件里还有一个 bug。
类似的情况还有"改一下这个函数",AI 直接重写整个文件——git diff 变得没法读,那条解释奇怪边界情况的注释也没了。以及你只想做"一个小改动",AI 顺手"为了清晰"重构了半个模块,小改动是对的,重构引入了两个新 bug。
分析: AI 倾向于把局部请求放大成完整方案,因为它从训练数据里学到的"登录表单"往往伴随着一整套脚手架。对新手来说,多余的代码意味着多余的阅读和调试成本,而这些代码你根本没打算理解。
幻觉与过时:AI 非常自信地犯错
原文反复出现一句话:"The AI was very confident."(AI 非常自信。)
- 你让它用官方 SDK,它
import了一个根本不存在的包,npm install直接失败。 - 你让它用 X 的最新版本,它用了某个旧版本,API 去年就被移除了。
- 你让它解释报错,它说"这是 async/await 的常见问题",而真实原因是少了一个逗号——它根本没看堆栈信息。
分析: 模型不会主动说"我不确定"。包名、API 版本这类需要精确记忆的信息,恰恰是幻觉高发区。新手最容易犯的错,是把 AI 的自信语气当成正确性信号。
幻觉(hallucination) 指语言模型生成看似合理、实则与事实不符的内容。它源于模型的生成机制:模型按概率逐 token 输出最"像"的下文,而不是去查证某个包是否真实存在于 npm registry。包名、函数签名、API 版本号这类需要精确记忆的字符串,一旦模型记忆模糊,就会平滑地编造出一个语法正确、命名风格逼真的替代品,且置信度与正确答案无异。判断方法很直接:import 之前先在官方文档或包管理器里搜一下,版本号以官方 changelog 为准,不要以 AI 的表述为准。
上下文问题:它只看到了它看到的部分
原文里有两个很扎心的场景:
- 你往对话里粘了 3 个文件问"为什么失败",AI 只根据第一个文件给出了一个完美的回答——真正的 bug 在第三个文件里,它压根没看。
- 你在 playground 里跑通的代码,粘回项目就不工作了:缺 import、类型不对,还假设了不存在的全局变量。
还有一个跨模型版本:同一个问题问 Claude、Grok、ChatGPT,得到三个不同的答案,都听起来很对,但只有一个是对的。
分析: AI 的回答质量取决于你给它的上下文窗口,而不是你项目里的真实情况。跨模型对比是个好习惯,但前提是你自己有判断力——而这恰恰是新手最缺的。
上下文窗口(context window) 是模型单次请求能"看到"的 token 总量上限,包括系统提示、对话历史和粘贴的代码文件。超出窗口的内容会被截断或丢弃,模型对窗口之外的项目文件、目录结构、配置一无所知。这解释了两个典型现象:粘贴多个文件时,靠后的内容可能未被充分处理;playground 里能跑的代码搬回项目就报错,因为模型从未见过你项目里的 import 路径、类型定义和全局变量。实践上,与其一次性塞入大量文件,不如精准提供与问题直接相关的完整堆栈和关键文件,并明确告知项目结构。
指令不服从与"优化"陷阱
原文列了几条看起来好笑但很真实的场景:
- 你明确说"不要改函数签名",它改了签名,还顺手更新了调用点,其中一半是错的。
- 你说"不要用任何库",它用了三个,其中一个还没人维护。
- 你说"让它更快",它加了缓存、memoization、Web Worker 和一层 Redis——你那个 20ms 的函数变成了 40ms,还多了一个依赖。
- 你说"让它生产就绪",它加了日志、错误处理、重试和指标,原型长了 300 行,却仍然缺你真正需要的那个校验。
分析: "优化"和"生产就绪"这类模糊指令,会让 AI 按照它理解的通用最佳实践大范围改动。模糊指令 + 大范围改动 = 不可控的 diff。新手常在这里丢掉对代码的掌控。
测试与自审:通过不等于正确
这部分可能是全文最值得警惕的:
你说"写测试",AI 写了一堆能通过的测试。但这些测试测的是 AI 自己的实现,不是你的需求——功能坏了它们照样通过。
以及:你让 AI 审查自己写的代码,它找出了两个风格问题,漏掉了逻辑 bug。
分析: AI 写测试时,倾向于围绕自己的实现来构造断言,形成"自己出题自己判卷"的闭环。测试的独立性在这里被悄悄破坏,而这层破坏很难被新手察觉。
测试的独立性 是测试有效性的前提:断言应当源自需求规格,而非待测实现本身。若测试与实现出自同一来源(同一个模型、同一轮对话),二者会共享同样的误解——实现漏掉某个边界条件,围绕它构造的测试自然也不会覆盖该边界,于是"全绿"只证明实现与自己的预期自洽,不证明功能正确。破解方法是切断这层耦合:先让 AI 复述需求并写出验收标准,再由你或独立会话据此写断言;或者采用测试先行,先固定测试再让 AI 实现,使实现必须向测试低头,而非测试迁就实现。
重复生成与理解债
原文还有两条关于"选择困难"的观察:
- 同一个组件重新生成五次,你得到五个略有不同的版本,不知道哪个是对的。
- 连续两小时接受每一条建议,代码库里同一种事情有了四种写法,而你一种都解释不了。
最后一条是全文的收尾,也是最重的一击:
你终于读了 AI 写的代码。结果你比开始时更不懂了。
分析: 这就是"理解债"。Vibe Coding 把写代码的成本换成了理解代码的成本,而后者往往更贵。作者用"我本该自己写"许可证(I should have just written it myself license)收尾,态度已经很明确。
给新手的几条实操建议
结合原文的吐槽,可以提炼出几条可直接落地的习惯:
- 约束改动范围:在提示里明确"只改这个函数,不要动其他文件",并在提交前逐行看 diff。
- 对包名和版本保持怀疑:任何
import和版本号,先确认它真实存在,再安装。 - 贴全上下文:报错时把完整堆栈和相关文件一起给,别指望 AI 猜。
- 测试要对着需求写:让 AI 先复述需求,再写测试;或者自己写断言,AI 只负责填充。
- 别在周五下午发布:原文的那句"周五下午 5 点 bug 出现在生产环境",是整篇文章里最不需要解释的一句。
Vibe Coding 不是不能用,而是要知道它的脾气:它会过度生成、会自信地幻觉、会只看到你给它的那部分世界。把这些特质当成已知条件,再决定哪些活交给它、哪些活留给自己。
原文以"I should have just written it myself"许可证发布。
相关推荐
iPhone Duo评测争议:苹果首款折叠屏为何被指"应该叫iPad"
The Vergecast深度讨论iPhone Duo评测争议:7分评分是否合理?应用适配为何陷入困境?为何评论者称它"应该叫iPad"而非iPhone?本文拆解苹果首款折叠屏的产品定位错位与第一代妥协,并延伸至AI安全漏洞、代理购物等更广阔的科技图景。

Meta与出版商的AI数据之争:服务条款修改引爆互联网未来之战
Meta修改商业账户服务条款,允许用关联网站数据训练AI模型,引发出版商和创作者强烈反弹。媒体行业组织联名致信扎克伯格,Meta被迫删除"训练"措辞并推迟条款生效。这场争议揭示了AI时代数据授权与互联网未来的深层博弈。

当Outside Xbox遇上血染钟楼:Minecraft里的军团对局
Outside Xbox嘉宾Ellen和Mike做客Minecraft版《血染钟楼》,迎战军团恶魔局。三名好人如何在信息噪音中对抗多数邪恶?本文解析军团机制、信息角色博弈与终局逆转。