Vibe Coding是真火还是炒作?人类把关是关键
Vibe Coding 是真实的生产力工具,但人类必须留在流程中把关。
文章围绕“Vibe Coding”这一用自然语言驱动 AI 生成代码的编程方式展开讨论,给出务实判断:它是真实的,但前提是人类始终留在流程中。文章先解释其核心流程——用日常语言描述需求、AI 写代码、用户测试并用自然语言反馈修改,指出它大幅降低了编程门槛。接着说明其适用场景:快速原型开发、个人工具与小型项目、以及学习编程。随后警示三类高风险领域:安全敏感场景、支付相关功能与大型代码库,分别涉及隐蔽漏洞、直接金钱损失和上下文理解不足导致的冲突与 bug。文章最后提出三条守则:审查代码、发布前测试、绝不粘贴密码或密钥,并强调 Vibe Coding 并非“不用懂技术”,而是把技术判断力用在更关键的地方。
核心观点:用自然语言描述需求,AI生成代码,你测试并反馈修改——这种被称为“Vibe Coding”的编程方式正在引发热议。它究竟是真实的生产力革命,还是短暂的炒作?来自YouTube的原始视频给出了一个务实的判断:它是真实的,但前提是人类必须留在流程中。
Vibe Coding到底是什么?
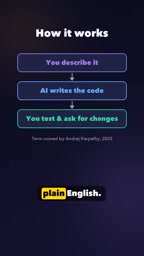
Vibe Coding的核心流程极其简单:你用日常语言描述想要的功能,AI写出代码,你运行测试,然后用自然语言提出修改意见。整个过程不需要你手动敲一行代码,全部通过对话完成。
这种模式之所以吸引人,是因为它大幅降低了编程的门槛。过去你需要学习语法、框架和调试技巧,现在只需要清楚表达意图。对于非专业开发者来说,这无疑打开了一扇新的大门。
Vibe Coding 一词由 AI 研究者 Andrej Karpathy 于 2025 年初提出,描述的是一种“完全沉浸在氛围中”的编程方式:开发者不再逐行编写代码,而是通过自然语言向大语言模型(LLM)描述意图,由模型生成代码,开发者只负责运行、观察结果并继续用自然语言迭代。它与传统的“AI 辅助编程”(如代码补全、Copilot 式建议)有本质区别:后者仍以人写代码为主、AI 为辅,而 Vibe Coding 把代码生成的主体交给了模型,人的角色转向需求表达、结果验证与方向把控。这一概念之所以引发广泛讨论,是因为它触及了“编程门槛”与“代码质量责任”这两个核心问题——当代码不再由人逐字写出时,理解、审查与担责的边界需要重新定义。
适合的场景:原型、个人工具与快速学习
视频明确指出,Vibe Coding在几个特定场景下表现出色。
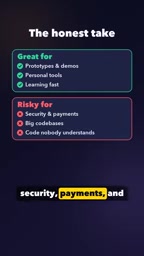
快速原型开发是其中最典型的应用。当你有一个想法需要验证时,用自然语言让AI生成一个可运行的版本,比传统开发方式快得多。你可以在几分钟内看到初步效果,然后决定是否值得继续投入。
个人工具和小型项目同样适合。比如写一个自动整理文件的脚本,或者做一个简单的数据可视化页面,Vibe Coding可以帮你跳过繁琐的配置过程,直接得到可用的结果。
学习编程也是一个被低估的用途。通过观察AI生成的代码,初学者可以快速理解常见模式,并在修改需求的过程中体会代码结构的变化。
风险警示:安全、支付与大型代码库
Vibe Coding并非万能。视频特别点出了三类高风险领域。
安全敏感的场景需要格外警惕。AI生成的代码可能包含不易察觉的漏洞,比如不充分的输入验证或错误的权限检查。如果你把这样的代码直接部署到生产环境,后果可能很严重。
支付相关的功能同样危险。涉及金钱交易的逻辑一旦出错,损失是直接的。AI可能生成看似合理但实际有缺陷的支付流程代码,而这些问题在简单测试中未必能暴露。
大型代码库是另一个难点。当项目规模变大、依赖关系复杂时,AI很难全面理解上下文,生成的代码可能与其他模块冲突,或者引入难以追踪的bug。
大型代码库之所以成为难点,与 LLM 的上下文窗口限制密切相关。模型在一次对话中能“看到”的代码量是有限的,当项目包含数十个模块、复杂的依赖关系和隐式的约定时,模型往往只能基于局部片段生成代码,难以感知全局的接口契约、命名规范和数据流。这会导致生成的代码在孤立看时合理,放入项目后却与既有模块冲突,或破坏原本的抽象层次。此外,模型可能“幻觉”出不存在的 API、过时的库版本或错误的配置项,这类问题在小型脚本中容易发现,在大型系统中却可能隐藏很深。因此在大代码库中使用 Vibe Coding,通常需要配合良好的模块划分、明确的接口文档以及小步提交、持续集成的工程习惯,把 AI 的输出限制在可控的局部范围内。
三条实用守则
面对这些风险,视频给出了明确的操作建议。
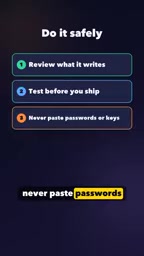
审查代码。即使你不写代码,也要让AI解释关键部分,或者请有经验的开发者帮忙过目。不要因为代码“能跑”就跳过审查。
发布前测试。自动化测试和手动验证都不可少,尤其是涉及用户输入和数据处理的功能。
绝不粘贴密码或密钥。这是最容易被忽视的一条。把敏感信息交给AI服务,等于把它们暴露在潜在的风险中。
**“绝不粘贴密码或密钥”**这条守则背后是 AI 服务的数据处理现实:你输入的内容可能被服务商用于日志记录、滥用监控,甚至在部分产品条款下用于模型训练。一旦 API Key、数据库口令或私密令牌进入对话,就等于离开了你的受控环境,可能出现在日志、缓存或第三方系统中。更稳妥的做法是使用环境变量或密钥管理工具,在交给 AI 的代码中以占位符代替真实凭据,并在本地运行时注入。此外,还应留意生成代码中是否硬编码了示例密钥、是否把敏感配置写进了前端可见的位置——这些是 AI 生成代码中常见的安全疏忽。
最终判断:真实,但依赖人类把关
视频的结论干脆利落:Vibe Coding是真实的,前提是人类始终留在流程中。
这个判断值得认真对待。Vibe Coding确实改变了编程的方式,让更多人能够把想法变成可运行的产品。但它并没有消除对技术判断力的需求,反而在某些环节放大了风险。
换句话说,Vibe Coding不是“不用懂技术”,而是“把技术判断力用在更关键的地方”。你需要知道什么该交给AI,什么必须自己把关,以及如何验证结果是否可靠。
对于个人开发者和小团队来说,这是一个值得拥抱的工具。对于涉及安全、支付和复杂系统的场景,谨慎和审查仍然是不可省略的步骤。
相关推荐
Agent项目实战:从需求到上线的真实交付与踩坑
基于一次真实Agent项目实战,拆解从最小可行循环到自主长任务交付的全流程,分析提示词过度约束的陷阱,并给出上下文管理、工具调用、长任务拆解等维度的验收标准与踩坑记录。
当AI化身庄园主人:一场谋杀悬疑背后的科技实验
从YouTube互动悬疑视频Brindley Manor出发,解析多智能体AI如何扮演八个角色、维持信息隔离并生成动态谋杀谜题,探讨AI互动叙事的潜力与当前技术短板。
从讲坛到参议院:牧师参议员谈何谓罪
一位同时担任埃比尼泽教会牧师和美国参议员的访谈片段:他坦言在华盛顿的经历让他对罪与傲慢有了新认识,布道反而因此更有力量,甚至将华盛顿与所多玛、蛾摩拉相提并论。