VisKG-LM:把知识图谱编译成视觉记忆,破解问答重复编码难题
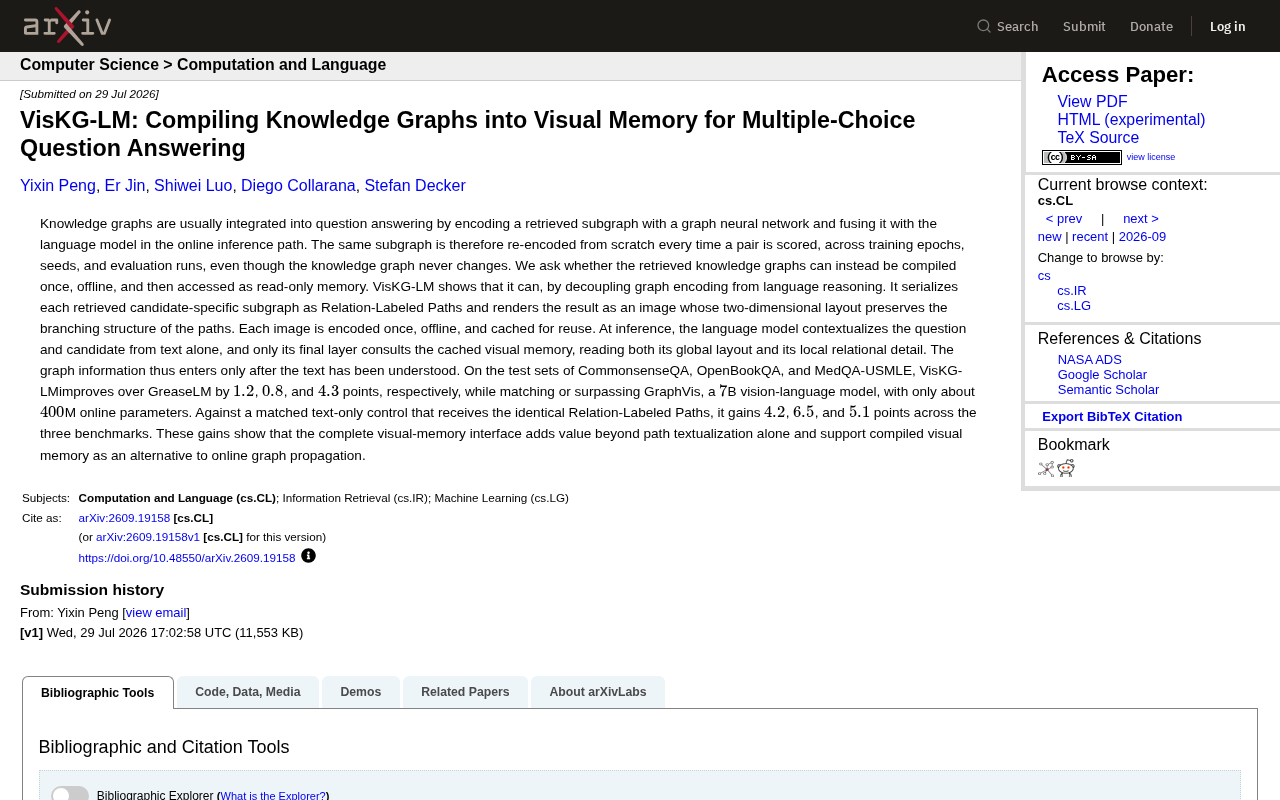
VisKG-LM将知识图谱子图离线渲染为图像缓存,以4亿参数超越70亿参数模型。
VisKG-LM提出了一种新的知识图谱问答范式,针对传统方法每次推理都要重新用GNN编码子图的效率黑洞,将知识图谱的编码环节彻底移至离线阶段。其核心做法是:先将检索到的候选子图序列化为关系标注路径,再将路径渲染成二维图像以保留分支拓扑结构,一次编码后缓存复用。推理时,语言模型先完成文本语境化理解,仅在最后一层查阅这份视觉记忆。实验表明,该方法在CommonsenseQA、OpenBookQA、MedQA-USMLE三项基准上均超越GreaseLM基线,仅用约4亿在线参数即可媲美70亿参数的GraphVis模型;与纯文本路径对照组相比提升4~6个点,证明图像化布局本身承载了额外的结构信息。
一个被长期忽视的效率黑洞
在知识图谱增强的问答系统中,有一个几乎被默认接受的低效做法:每当模型给一个「问题-候选答案」对打分时,都要从头重新编码检索到的子图。这个过程贯穿训练的每一个epoch、每一个随机种子、每一次评估运行——尽管底层的知识图谱从始至终都没有变化过。
传统做法通常用图神经网络(GNN)编码检索到的子图,再在在线推理路径中将其与语言模型融合。这意味着相同的子图被反复地、重复地重新计算,造成了巨大的算力浪费。VisKG-LM这篇arXiv新论文正是对这一惯性提出了质疑:既然知识图谱不会变,为什么不能只编译一次,之后当作只读记忆来访问?
图神经网络(GNN)是专门用于处理图结构数据的神经网络架构。与处理序列的Transformer或处理网格的CNN不同,GNN通过「消息传递」机制让每个节点聚合邻居节点的信息,从而学习到融合了局部拓扑结构的节点表示。在知识图谱问答任务中,常见做法是先根据问题从知识图谱中检索相关子图,再用GNN对子图做多轮消息传播,最终得到问题相关的图表示,并将其与语言模型的文本表示融合打分。这一过程的计算代价在训练阶段尤为突出:每个训练样本都需要对其对应的子图独立运行完整的消息传播,而在多轮训练中同一子图会被反复处理,形成巨大的冗余计算。
核心思路:把图「画」成图像
VisKG-LM的关键创新在于将图编码与语言推理解耦。它不再在推理时反复跑GNN,而是把每个候选答案对应的子图做了一次巧妙的转换。
具体分为两步:
序列化为关系标注路径
首先,系统将检索到的候选子图序列化为「关系标注路径」(Relation-Labeled Paths),也就是把图结构拆解成一条条带有关系标签的路径。这是一种把图的语义信息线性化表达的方式。
关系标注路径(Relation-Labeled Paths)是一种将图结构转化为线性序列的标准化表示方法。具体而言,知识图谱中的一条路径由「实体-关系-实体-关系-……-实体」交替排列的三元组链构成,例如「阿司匹林 → 用于治疗 → 头痛 → 属于症状 → 神经系统疾病」。将图序列化为这类路径的优势在于可以直接与语言模型的文本输入兼容,但代价是丢失了原图的分支结构信息——多条路径之间的交叉节点与并行关系在被展开为独立序列后便失去了空间上的关联性。VisKG-LM的关键洞察正在于此:单纯的路径文本化不足以完整保留图的拓扑,因此需要额外借助二维图像来显式编码这种结构。
渲染为保留结构的图像
更有意思的是第二步:VisKG-LM把这些路径渲染成一张图像,其二维布局刻意保留了路径的分支结构。也就是说,图的拓扑信息不是被压平成文本,而是被编码进图像的空间布局中——全局的版式反映整体结构,局部的细节保留具体的关系。
每一张这样的图像只需离线编码一次,然后缓存起来供后续复用。这从根本上消除了在线阶段的重复图传播计算。
推理时的分工:先理解文本,再查阅记忆
VisKG-LM在推理阶段的设计体现了一种清晰的信息进入顺序。语言模型先仅凭文本对问题和候选答案进行语境化理解,只有在它的最后一层才去查阅缓存的视觉记忆——同时读取图像的全局布局和局部关系细节。
这样的安排意味着:图谱信息只在文本被充分理解之后才进入模型。这种「文本先行、图谱后置」的机制,避免了图信息过早干扰语言推理,也让缓存的视觉记忆真正扮演了「只读参考资料」的角色,而非深度纠缠的融合对象。
实验结果:小参数量,大效果
论文在三个主流基准上验证了方法的有效性:CommonsenseQA、OpenBookQA 和 MedQA-USMLE。
相比经典的 GreaseLM 基线,VisKG-LM 分别提升了 1.2、0.8 和 4.3 个点。在医学领域的 MedQA-USMLE 上提升尤为显著,说明这种视觉记忆机制在需要复杂关系推理的场景中更有优势。
更值得关注的是效率对比:VisKG-LM 仅用约 4 亿(400M)在线参数,就达到甚至超过了 GraphVis 这个 70 亿(7B)参数的视觉-语言模型。近20倍的参数量差距,却能打平或超越,充分体现了「离线编译+缓存复用」路线的性价比。
视觉记忆到底带来了什么增量
为了证明性能提升不只是来自路径文本化,论文设置了一个关键对照实验:一个仅接收相同「关系标注路径」文本的纯文本模型。
结果显示,VisKG-LM 在三个基准上分别领先这个纯文本对照 4.2、6.5 和 5.1 个点。这组数据说明,完整的视觉记忆接口带来的价值超出了单纯把路径文本化——图像化的二维布局本身承载了额外的、有用的结构信息。
GreaseLM 是知识图谱问答领域的经典基线方法,其核心思路是在语言模型(如RoBERTa)的每一层都与GNN进行双向融合,让文本表示和图表示在整个推理过程中深度交织。CommonsenseQA、OpenBookQA 和 MedQA-USMLE 是该领域三个定位不同的标准评测集:CommonsenseQA 考验日常常识推理,OpenBookQA 侧重初级科学知识与外部记忆的结合,MedQA-USMLE 则取材自美国执照医师资格考试,要求对医学概念间的复杂关系进行多步推理。MedQA-USMLE 上4.3个点的较大提升,部分原因在于医学知识图谱的关系密度高、推理链路长,正是视觉化二维布局能够保留多路径交叉结构的场景。
对RAG与图谱应用的启示
VisKG-LM 提出的「编译式视觉记忆」为在线图传播提供了一条替代路径,其意义可能超出知识图谱问答本身。
它揭示了一个更普遍的工程思想:对于静态、不变的知识源,与其在每次推理时重复编码,不如把编码结果预计算并缓存为可复用的记忆。这与近年来 RAG(检索增强生成)领域对缓存和预计算的关注不谋而合。
把结构化数据渲染成图像、借助视觉模型的空间理解能力来读取,也是一个新颖的接口设计思路。当然,这仍是一篇arXiv预印本,其泛化能力、在更大规模知识图谱上的表现,以及图像渲染本身的成本,都还有待更多验证。但它至少证明了:知识图谱不必每次都从零重新编码,「编译一次,随处复用」是可行的。
RAG(Retrieval-Augmented Generation,检索增强生成)是一种在推理时动态从外部知识库中检索相关信息并拼接给语言模型的范式,目前被广泛用于减少大模型幻觉、扩展知识时效性。传统RAG每次查询都需实时检索并编码文档,当知识库规模庞大且内容相对稳定时,这同样产生大量重复计算。近年来学界和工程实践中出现了「预计算文档嵌入并缓存索引」的优化方向,VisKG-LM的「离线编译图像记忆」可视为这一思路在结构化知识上的延伸——区别在于其缓存的不是向量嵌入,而是保留了拓扑语义的可视化图像,从而能够被多模态模型的视觉通道直接读取,提供了一种不依赖传统向量检索的结构化知识接入方式。
相关推荐
AAAI-27第一阶段评审结果临近:投稿者需关注什么
AAAI-27第一阶段(Phase 1)评审结果预计9月24日公布,本文解读AAAI分阶段评审机制、投稿者应对策略以及学术社区在结果等待期的协作价值。
FAISS向量搜索实战入门:从Embedding到RAG的踩坑心得
一位开发者分享FAISS向量搜索的实战入门心得,讲解从Embedding到RAG的完整数据流,并深入探讨人名、日期、过滤条件和对话历史等真实场景下的检索难点与应对方案。
H3 Camera Control v3来袭:视频镜头控制与快速渲染上线
H3 Camera Control v3更新预告发布,将带来视频镜头控制与快速渲染两项核心升级,提升AI视频创作的可控性与效率。本文解读新功能方向与行业意义。