vLLM Day-0支持之后:社区如何把MiniMax M3推理提速3-4倍
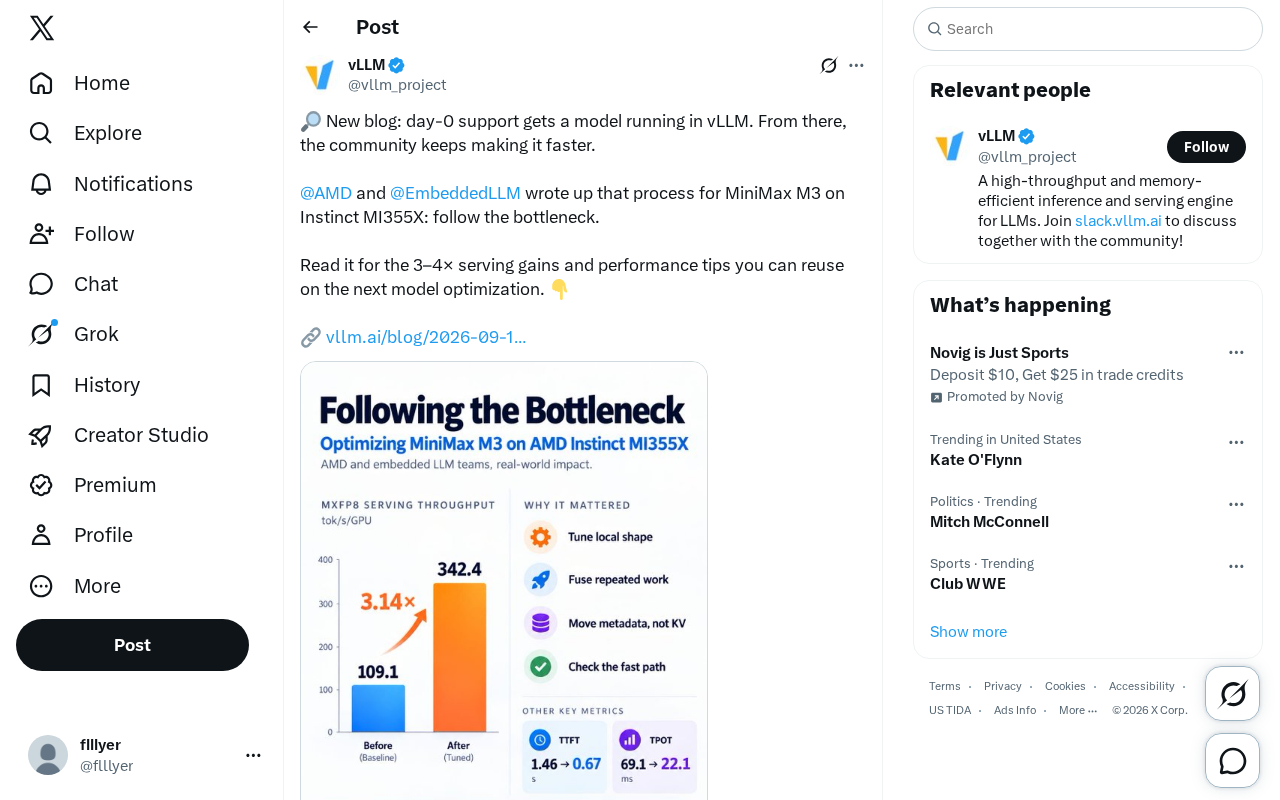
AMD联合EmbeddedLLM在MI355X上以"跟着瓶颈走"方法将MiniMax M3推理吞吐提升3-4倍。
这篇文章围绕AMD与EmbeddedLLM联合发布的一项推理优化实践展开:在AMD Instinct MI355X硬件上,以vLLM为推理框架,将MiniMax M3的服务吞吐量提升了约3-4倍。文章首先区分了"能跑"与"跑得快"两个阶段——vLLM的day-0支持解决的是功能正确性,而真正的性能优化是基线之后的持续工程工作。核心方法论被概括为"跟着瓶颈走":系统化定位计算、内存带宽、调度、通信等瓶颈并逐一消除,形成可复现、可跨模型迁移的优化流程。文章最终将这一实践提炼为开发者可借鉴的范式:开源框架、硬件厂商与社区的三方协作,是当前大模型推理优化的标准路径。
从“能跑”到“跑得快”的距离
一个新模型的推理部署往往分成两个阶段:先让它在推理框架上跑起来,再想办法让它跑得更快。vLLM 的 day-0 支持解决的是前者——模型发布当天就能在框架里加载并输出结果。但真正的性能优化,通常发生在这之后,由社区在实际负载中一点点抠出来。
AMD 与 EmbeddedLLM 联合发布的一篇博客,记录了他们在 Instinct MI355X 硬件上优化 MiniMax M3 推理服务的完整过程。核心方法论只有一句话:跟着瓶颈走(follow the bottleneck)。最终成果是 3–4 倍的服务吞吐提升,而这些调优思路据称可以复用到下一个模型的优化工作中。
Day-0 支持意味着什么
vLLM 作为当前主流的大模型推理服务框架,其 day-0 支持能力对生态非常关键。它意味着当 MiniMax M3 这类新模型发布时,用户无需等待漫长的适配周期,就能立即在 vLLM 中把它跑起来。
但需要清醒认识到:day-0 支持给出的往往是一个功能正确但性能未经打磨的基线版本。模型能返回正确结果,不代表它已经用满了硬件算力。真正决定生产环境成本与延迟的,是基线之上的持续优化——而这部分工作,恰恰是开源社区和硬件厂商协作发力的地方。
vLLM(Virtual Large Language Model)是由加州大学伯克利分校开发、目前被业界广泛采用的大模型推理与服务框架。其核心创新是 PagedAttention 技术——借鉴操作系统虚拟内存的分页思想,将 KV Cache 切分为非连续的内存块动态管理,大幅减少显存碎片,从而在同等硬件上支持更大批次并发。vLLM 还内置了 Continuous Batching(持续批处理)机制,能在请求粒度上动态调整推理批次,而非等待一批请求全部完成才开始下一批,这使吞吐量相较传统静态批处理有数倍提升。正是因为 vLLM 已成为生产部署的事实标准,新模型能否获得 day-0 支持,直接决定了它进入实际服务的门槛高低。
“跟着瓶颈走”的优化哲学
AMD 和 EmbeddedLLM 在博客中强调的方法论值得展开:与其盲目套用各种优化技巧,不如系统性地定位当前的性能瓶颈,逐个击破。
推理服务的瓶颈可能出现在多个环节:
- 计算瓶颈:GPU 算力未被充分利用,可能与算子实现、精度选择(如 FP8/BF16)有关
- 内存带宽瓶颈:KV Cache 的读写、权重加载受限于显存带宽
- 调度瓶颈:批处理(batching)策略、请求调度不够高效
- 通信瓶颈:多卡场景下的张量并行、流水线并行开销
“跟着瓶颈走”的价值在于,它把优化从碰运气变成了可复现的工程流程。定位瓶颈、消除瓶颈、再次测量、寻找新瓶颈——这个循环本身就是可迁移到下一个模型的经验资产。
MI355X 上的 MiniMax M3 实践
这次优化的硬件载体是 AMD Instinct MI355X。AMD 近年来在 AI 推理硬件上持续发力,而与 vLLM 这类主流开源框架的深度适配,是其争夺推理市场份额的关键一步。
选择 MiniMax M3 作为优化对象也颇具代表性。这类新一代模型往往结构复杂,对推理框架的算子支持、内存管理提出更高要求,正是检验硬件+框架协同能力的好试金石。博客中提到的 3–4 倍提升,如果属实,对于降低这类模型的服务成本具有直接意义。
需要说明的是,本文基于 AMD 与 EmbeddedLLM 的官方博客推介,具体的 benchmark 配置、对比基线和测试方法建议以原文为准。
AMD Instinct MI355X 是 AMD 面向 AI 数据中心推出的高端加速卡,基于 CDNA 架构演进而来,配备大容量 HBM 显存与高显存带宽,在大批次推理场景下具备较强的内存吞吐优势。与 NVIDIA GPU 生态相比,AMD 的软件栈围绕 ROCm(Radeon Open Compute)平台构建,其与 PyTorch、vLLM 等主流框架的兼容性近年来显著改善,但在算子库(如 Flash Attention、Triton kernel)的成熟度上仍处于追赶阶段。这也是为什么此次优化实践具有示范意义:它不仅是对单一模型的调参,更是验证 ROCm 生态在生产级推理服务上可行性的一次公开背书。MiniMax M3 采用了混合专家(MoE)等复杂架构,对稀疏计算和大规模 KV Cache 管理提出更高要求,恰好能充分测试硬件与框架协同的边界。
对开发者的实际启示
对于正在部署大模型推理服务的团队,这篇博客的价值不只在于 MiniMax M3 本身,更在于它展示的优化范式:
- 不要满足于 day-0 的基线性能,那只是起点
- 建立系统化的性能分析流程,用数据定位瓶颈
- 硬件厂商与开源社区的调优经验往往可跨模型复用
- 关注 vLLM 社区的持续迭代,很多性能红利来自框架本身的演进
开源框架 + 硬件厂商 + 社区调优的三方协作,正在成为大模型推理优化的标准模式。谁能在这条链路上跑得更顺畅,谁就能在推理成本这场硬仗里占据优势。
完整技术细节与可复用的性能调优建议,可参考 AMD 与 EmbeddedLLM 发布的原文博客。
相关推荐
分布式系统经典论文导读:从入门到精通的必读清单
一份在 Hacker News 走红的分布式系统经典论文清单,涵盖共识算法、逻辑时钟、CAP 定理等核心主题,为工程师提供系统化的学习路径与理论到实践的桥梁。
Valve仍在权衡Steam Deck 2的推出时机
Valve完成Steam Controller、Steam Machine和Steam Frame三款2026硬件产品线后,Steam Deck 2仍无明确时间表。Valve设计师表示仍在权衡"如何以及何时"推出,坚持不为单纯性能提升而做续作。
"Dario, Please":一封写给Anthropic CEO的公开呼吁引发热议
《Dario, Please》一文在Hacker News引发热议,累计247分与122条评论。这封写给Anthropic CEO Dario Amodei的公开呼吁,折射出AI社区对头部大模型公司决策方向的持续关切与话语生态变化。