vLLM 发布 proto-v0.3.0:高性能推理框架再迭代
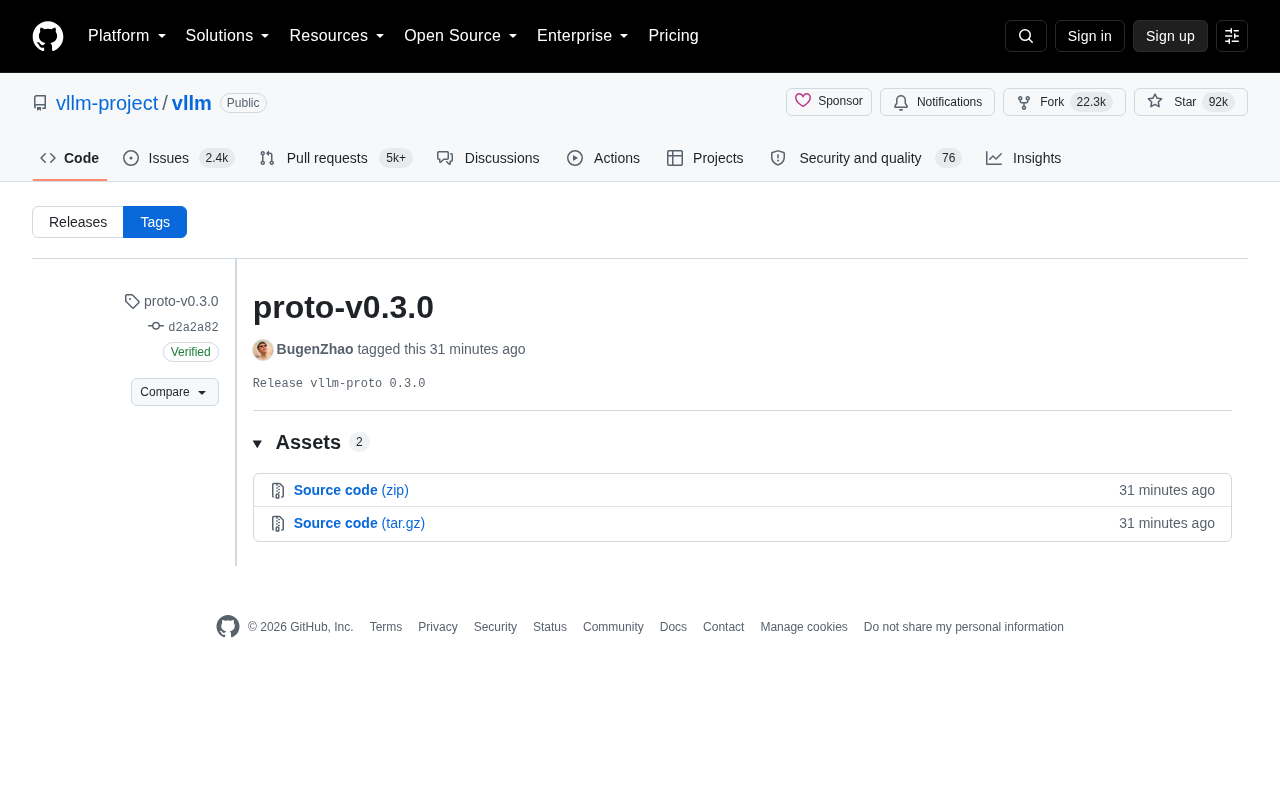
vLLM 发布 proto-v0.3.0,将协议子模块独立版本化并附带签名验证,强化分布式推理基础设施的可维护性与供应链安全。
vLLM 近日发布 `proto-v0.3.0` 标签版本,对应项目内部 `vllm-proto` 组件的 0.3.0 迭代。该版本由维护者 Bugen Zhao 以经过验证的 SSH 签名发布,是 vLLM 将协议层与主版本号解耦、独立版本化管理的体现。在 vLLM 架构中,proto 模块承担进程间通信、请求序列化及分布式调度协议的核心职责,随着多节点推理与张量并行等能力的扩展,稳定的协议版本号有助于下游团队锁定依赖、规避接口变更带来的兼容性风险。签名验证机制则回应了开源社区日益重视的供应链安全需求。整体而言,此次发布是一次面向基础设施的常规但重要的工程迭代。
vLLM proto-v0.3.0 版本发布
开源大模型推理引擎 vLLM 近日发布了一个新的标签版本 proto-v0.3.0。该版本由维护者 Bugen Zhao 使用经过验证的签名进行发布,对应内部组件 vllm-proto 的 0.3.0 发行。作为当前社区活跃度最高的推理框架之一,vLLM 在 GitHub 上已积累超过 9.2 万 Star、2.23 万次 Fork,任何一次版本更新都会牵动大量部署方与研究者的注意力。
从发布信息来看,本次 proto-v0.3.0 属于 vLLM 项目中协议(proto)子模块的独立版本迭代,采用了独立于主版本号的命名体系。这种做法在大型开源项目中较为常见——将协议定义、序列化接口等基础组件单独打包发布,可以让上层框架与底层通信协议的演进节奏解耦,便于跨版本兼容管理。
proto 组件在 vLLM 中的角色
在 vLLM 的整体架构中,proto 相关模块通常承担进程间通信、分布式调度以及请求序列化的职责。随着 vLLM 逐步支持多节点分布式推理、张量并行(Tensor Parallelism)与流水线并行(Pipeline Parallelism),一套稳定、可扩展的协议定义变得尤为关键。
将 vllm-proto 独立发布并打上 proto-v0.3.0 标签,意味着开发团队正在把协议层作为一个可被独立引用和版本化的依赖来管理。对于需要基于 vLLM 二次开发、或构建自定义推理服务的团队而言,明确的协议版本号有助于锁定依赖、避免因接口变更导致的兼容性问题。
经过签名验证的发布
值得关注的一个细节是,该标签由提交者的 SSH 密钥进行了签名验证(Verified),并附带了密钥指纹信息。在供应链安全日益受到重视的背景下,签名验证能够帮助下游用户确认发布产物的真实性与完整性,降低被篡改或伪造版本的风险。这也反映出 vLLM 项目在工程规范上的成熟度。
vLLM 所使用的 proto 通常基于 Protocol Buffers(protobuf)——Google 开源的一种语言无关、平台无关的结构化数据序列化格式,常与 gRPC 框架配合使用。在 vLLM 的分布式场景下,调度器、推理工作进程(Worker)与前端服务之间的请求投递、KV Cache 状态同步、采样参数传递等均依赖 proto 定义好的消息结构。protobuf 相较于 JSON 具有更小的序列化体积与更高的解析速度,这对于高吞吐推理场景中大量并发请求的进程间传输尤为重要。一旦消息字段发生增删或类型变更,未同步升级的组件便可能出现解析失败或静默丢字段的问题,这也正是将协议层单独版本化、强制下游明确声明依赖版本的根本动机。
软件供应链安全近年来受到广泛关注,典型事件如 2020 年的 SolarWinds 攻击与 2024 年的 XZ Utils 后门均通过污染上游发布环节来危害下游用户。对 Git 标签或提交进行 SSH/GPG 签名,是防御此类攻击的基础手段之一:签名与发布者的私钥绑定,任何对产物的篡改都会导致签名验证失败,下游用户或 CI/CD 流水线可在拉取代码后自动校验,从而在信任链的源头建立保障。GitHub 从 2022 年起开始在界面上展示"Verified"徽章,并支持 SSH 密钥签名(在此之前仅支持 GPG),降低了开发者参与供应链安全的门槛。vLLM 在一个子组件的常规迭代中坚持执行签名流程,体现了对这一安全基线的重视。
对使用者的实际意义
对于生产环境中部署 vLLM 的团队,建议在升级前查阅完整的 changelog,评估 proto 层接口变更是否影响现有的分布式部署或自定义客户端。协议版本的升级往往涉及序列化格式或 RPC 接口的调整,跨版本混用可能带来隐性问题。
从更宏观的角度看,vLLM 持续保持高频迭代,是整个大模型推理生态活跃的缩影。PagedAttention、连续批处理(Continuous Batching)等核心技术让 vLLM 成为高吞吐推理的事实标准之一,而对协议层这类基础设施的精细化管理,则是支撑其长期演进的关键工程实践。
PagedAttention 是 vLLM 的核心创新之一,由 UC Berkeley 团队提出。其核心思想借鉴操作系统中虚拟内存的分页管理机制,将 Transformer 推理时占用大量显存的 KV Cache(Key-Value Cache)以固定大小的"块"(Block)为单位进行非连续分配,从而消除传统预分配方案中因序列长度估计不准确导致的显存碎片与浪费。连续批处理(Continuous Batching)则是另一项关键技术:不同于传统静态批处理需要等待批次中所有请求同时完成,连续批处理允许在每个推理步骤后动态地将已完成的请求移出、将新请求加入批次,大幅提升 GPU 利用率与整体吞吐量。两者协同工作,使 vLLM 在服务化部署场景下相较于朴素实现可获得数倍乃至数十倍的吞吐提升。
小结
受限于官方发布页当前提供的信息,本次 proto-v0.3.0 的具体变更细节尚不完整。感兴趣的开发者可前往 vLLM 的 GitHub Releases 页面查看完整的资产文件与提交记录,以获取更准确的升级指引。整体而言,这是一次面向基础组件的常规迭代,体现了项目对协议层稳定性与安全性的持续投入。
相关推荐
冰岛Treble获1800万美元融资,押注语音仿真平台
冰岛语音仿真公司Treble完成1800万美元融资,其平台服务于语音AI模型开发者、AI可穿戴设备及机器人公司。本文解析语音仿真技术价值与融资背后的行业信号。
开源之痛:非自回归架构的先行者,为何被前沿实验室抢了风头
一位独立开发者在 Reddit 发帖称,其一年前开源的非自回归 RL 架构,被前沿实验室重新包装为突破。本文拆解 PPO 序列嵌入与 RLCD 并行采样两种路线的异同,并探讨开源生态的溯源与署名困境。
AI全程规划葡萄园:一场100株葡萄藤的真实实验
华盛顿州斯波坎一位爱好者让Muse AI全程规划葡萄园,从品种选择、行距到灌溉全部交给AI,最终种下100株品丽珠。这场AI主导、人类执行的公开实验,揭示了AI辅助农业的机会与边界。