vLLM v0.30.1rc0发布:新增AMD MI355 NVFP4与MoRI内核支持
vLLM v0.30.1rc0为AMD MI355引入NVFP4量化内核,加速AMD推理生态追平NVIDIA。
vLLM 发布 v0.30.1rc0 候选版本,核心更新聚焦于 AMD ROCm 生态:由 AMD 官方工程师主导,为 MI355 加速卡新增 dense NVFP4 4位浮点量化内核与 MoRI 内核镜像支持。NVFP4 量化能将模型权重存储压缩至极致,在降低显存占用的同时提升推理吞吐,是当前大模型高效部署的重要方向。此次更新的意义不仅在于技术本身,更在于它反映了两个趋势:低比特量化正成为推理服务的标配基础设施,而 AMD 正通过直接向主流开源框架贡献硬件内核,系统性地构建可与 NVIDIA CUDA 生态抗衡的 AI 推理路径。该版本为候选发布,生产环境用户建议等待正式版。
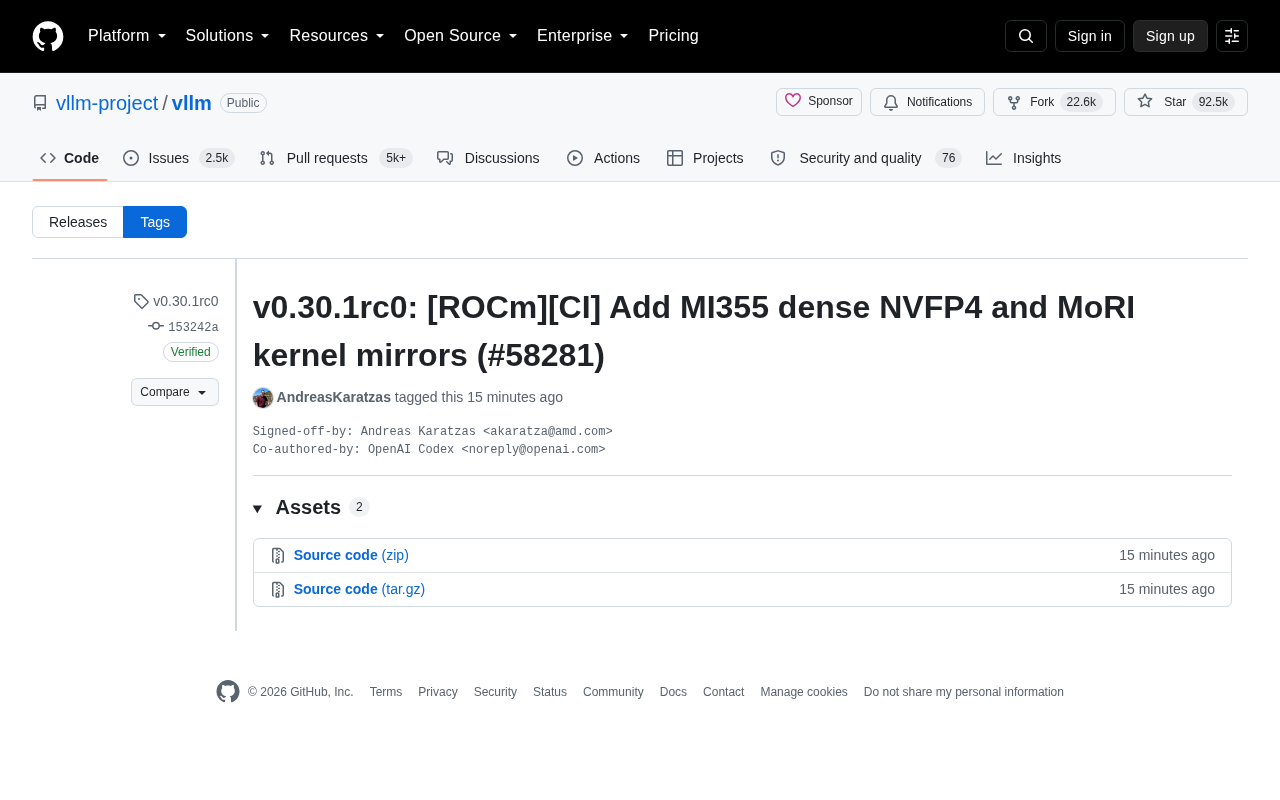
vLLM作为当前最受欢迎的大模型推理与服务框架之一,近日发布了 v0.30.1rc0 预发布版本。这一版本的更新重点聚焦于 AMD ROCm 生态,为 MI355 加速卡引入了 dense NVFP4 内核与 MoRI 内核镜像支持(PR #58281)。虽然是一个 release candidate(候选版本),但从提交内容可以看出 vLLM 在扩展硬件适配、尤其是 AMD 平台上的持续投入。
版本更新的核心内容
本次 v0.30.1rc0 的核心提交由 AMD 工程师 Andreas Karatzas 提交,标题为 [ROCm][CI] Add MI355 dense NVFP4 and MoRI kernel mirrors。从命名可以拆解出几个关键信息:
- ROCm:这是 AMD 面向 GPU 计算的开源软件栈,对标 NVIDIA 的 CUDA。此次更新属于 ROCm 路径下的 CI(持续集成)相关改动。
- MI355:AMD Instinct 系列中面向数据中心 AI 训练与推理的高端加速卡,具备较强的算力与显存带宽。
- NVFP4:一种 4 位浮点量化格式,用于在保持模型精度的同时大幅降低显存占用和提升推理吞吐。
- MoRI kernel:与专家混合(MoE)或路由相关的计算内核镜像。
换言之,这次更新为 AMD MI355 平台补齐了低比特量化推理所需的内核基础设施,让开发者能在 AMD 硬件上运行 NVFP4 量化模型。
ROCm(Radeon Open Compute) 是 AMD 推出的完整 GPU 计算开源软件栈,涵盖驱动、运行时、编译器(HIP)及数学库(rocBLAS、rocSPARSE 等)。HIP(Heterogeneous-compute Interface for Portability)是 ROCm 的核心编程接口,语法与 CUDA 高度相似,使 CUDA 代码能以较低成本移植到 AMD GPU。与 NVIDIA 的闭源 CUDA 生态不同,ROCm 完全开放源代码,这为第三方框架(如 PyTorch、vLLM)在 AMD 硬件上构建高性能内核提供了基础。然而,ROCm 生态的成熟度历史上落后于 CUDA,许多针对 NVIDIA 硬件优化的内核需要专门为 ROCm 路径重新实现或"镜像"(mirror),这正是本次更新标题中"kernel mirrors"一词的含义——为 AMD 平台补充与 NVIDIA 路径功能对等的计算内核。
为什么 NVFP4 量化值得关注
NVFP4 是近年来推理优化的重要方向。相比 FP16 或 FP8,4 位浮点格式能将模型权重的存储需求压缩到极致,这对于运行动辄数百亿甚至上千亿参数的大模型至关重要。
对于推理服务而言,量化带来的收益是双重的:一方面显存占用下降,使得单卡可承载更大模型或更长上下文;另一方面内存带宽压力减轻,通常也能换来更高的 token 生成速度。vLLM 为 MI355 引入 dense NVFP4 内核,意味着 AMD 用户可以在硬件层面获得与 NVIDIA 平台类似的量化推理能力,这对打破 CUDA 生态垄断、丰富 AI 推理的硬件选择具有实际意义。
NVFP4 是 NVIDIA 在 Blackwell 架构(GB200/B200 等)中引入的 4 位浮点格式,采用 1 位符号、2 位指数、1 位尾数的编码方式(E2M1),与 FP8(E4M3/E5M2)相比进一步将单个权重的存储压缩至半字节。与整数量化(INT4)相比,浮点格式在表示小数值时精度损失更可控,更适合保留神经网络权重的分布特性。在实际部署中,NVFP4 通常与"密集量化"(dense quantization)配合使用,即对模型全部线性层权重统一量化,区别于仅量化部分层的混合精度方案。值得注意的是,NVFP4 本是 NVIDIA 私有格式,AMD 在 MI355 上支持该格式,意味着 AMD 在硬件层面专门增加了对该数值格式的原生计算支持,以确保兼容运行针对该格式量化的模型权重,这对互操作性具有重要意义。
AMD 生态的持续发力
值得关注的一个信号是,本次提交由 AMD 官方工程师(邮箱后缀 @amd.com)主导,并且提交信息中出现了 Co-authored-by: OpenAI Codex 的协作署名。这反映出 vLLM 在 AMD 平台上的适配工作,正越来越多地由芯片厂商直接投入资源推进,而非仅依赖社区志愿者。
长期以来,AI 推理框架的优化重心集中在 NVIDIA CUDA 生态。AMD 通过在 vLLM 这样的主流开源项目中直接贡献 MI 系列加速卡的内核支持,是其扩大在 AI 推理市场份额战略的一部分。对于希望降低硬件成本或规避供应链风险的企业用户来说,一个成熟的 AMD 推理路径正在逐步成型。
AMD Instinct MI355X 属于 AMD CDNA3 架构的最新一代数据中心 AI 加速卡,配备 288GB HBM3E 显存,峰值 FP8 算力达 2.6 PFLOPS,在显存容量上超过 NVIDIA H100(80GB)和 H200(141GB),是面向超大规模模型推理和训练的旗舰产品。AMD 将 MI300 系列(含 MI355)定位为与 NVIDIA H100/H200 及 B200 的直接竞争产品。然而,硬件性能之外,软件生态的完整性往往是企业选型的关键因素——推理框架对特定量化格式的内核支持,直接决定了新硬件能否在生产环境中充分发挥算力。这也是 AMD 工程师直接向 vLLM 贡献内核代码,而非等待社区自发适配的核心动因。
关于 release candidate 的说明
需要提醒的是,v0.30.1rc0 是一个候选发布版本(rc = release candidate),并非最终稳定版。这类版本通常用于在正式发布前收集反馈、验证新功能的稳定性。生产环境用户建议等待正式版本,而希望尝鲜 MI355 NVFP4 支持的开发者则可以基于此版本进行测试与验证。
从 vLLM 高达 9.2 万 Star、2.26 万 Fork 的社区规模来看,其版本迭代节奏快、硬件覆盖广,已经成为大模型推理领域的基础设施级项目。此次面向 AMD MI355 的更新,是其硬件生态版图不断扩张的又一例证。
小结
vLLM v0.30.1rc0 虽然是一个体量不大的候选版本更新,但其为 AMD MI355 引入 dense NVFP4 与 MoRI 内核的举措,透露出两个趋势:低比特量化推理正成为标配,以及 AMD 正通过主流开源框架加速构建可与 NVIDIA 抗衡的 AI 推理生态。对关注推理性能优化和硬件多样化的团队而言,这是一个值得留意的更新节点。
相关推荐

AI温和派的崛起:在狂热与末日论之间寻找中间地带
AI舆论正陷入加速主义与末日论的两极撕裂,但一群"AI温和派"正在崛起。本文梳理福山、"AI作为常规技术"作者及好莱坞制片人卡森伯格的最新观点,呈现在狂热与恐惧之间寻找中间地带的思潮。
我让Claude构建可漫步的物理精确O'Neill圆柱:AI生成3D模拟的边界
我让Claude构建可漫步的物理精确O'Neill圆柱:AI生成3D模拟的边界
一位开发者让Claude构建物理精确、可实时漫步的O'Neill圆柱太空栖息地模拟。本文解析其中的科里奥利力、重力梯度等物理挑战,以及AI生成交互式3D模拟的现实意义与局限。

破解数据锁定:用REGISTER与UNREGISTER API实现目录可移植性
湖仓架构下,开放表格式解决了存储可移植性,但目录锁定成为新难题。本文解析REGISTER与UNREGISTER API如何实现元数据松耦合,帮助企业避免厂商绑定、支持多目录协作并安全迁移数据。