vLLM v0.34.0 版本发布:推理引擎再升级
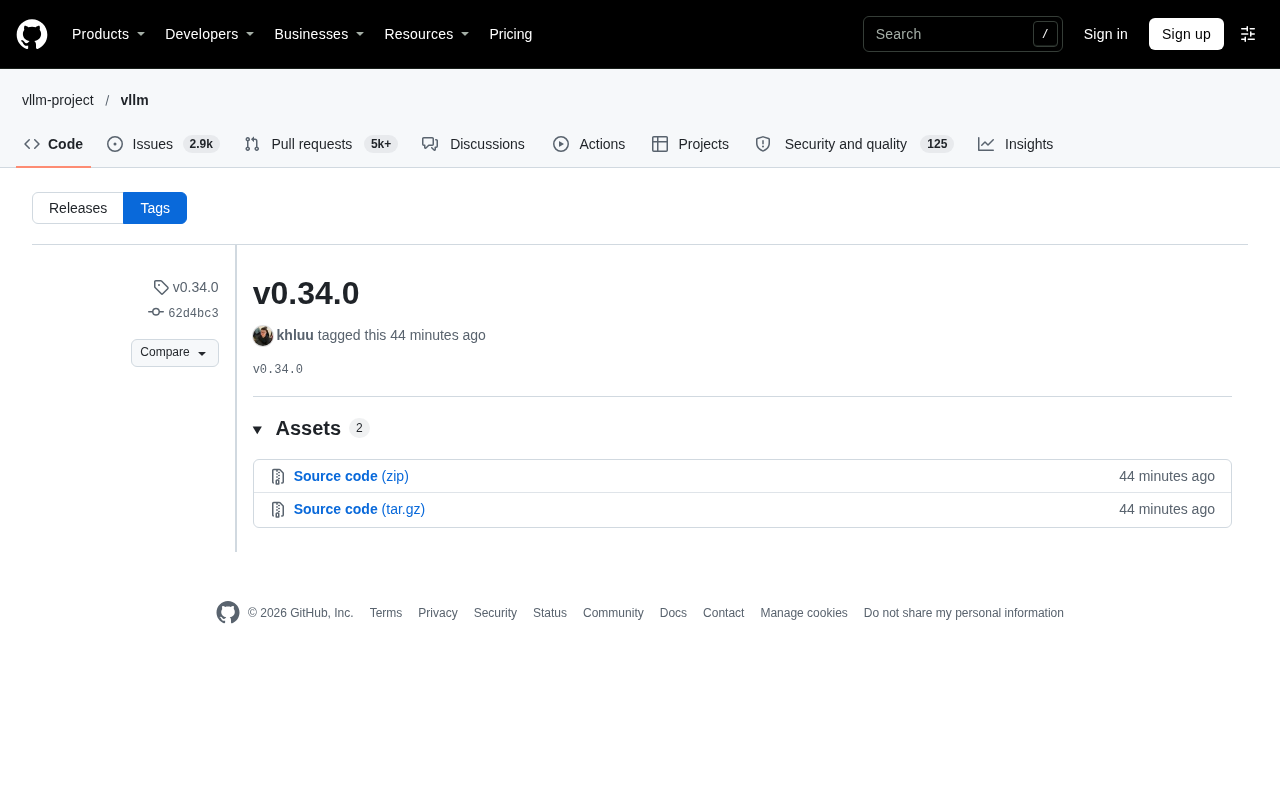
vLLM 发布 v0.34.0,但公开信息仅含标签,具体变更需查官方仓库。
vLLM 项目于近期发布 v0.34.0 版本,标签由 khluu 于 11 月 16 日创建,附带两个资源文件。然而本次获取的素材仅为 GitHub Releases 页面的标签信息与加载状态,未包含更新内容、提交记录或发布说明,因此无法确认新特性、性能提升幅度及是否存在破坏性变更。文章指出,版本号从 0.x 持续攀升,表明项目仍处于快速功能积累阶段,尚未进入以稳定性为主的 1.0 时代。高频发布既能让用户更快获得性能优化与新硬件支持,也要求生产环境更谨慎地锁定版本。作者建议开发者直接访问项目仓库的 Release 页面或对比提交历史获取变更明细,并在测试环境验证推理正确性与吞吐表现后再升级。
版本发布概览
据 GitHub 仓库标签信息,vLLM 项目于近期发布了 v0.34.0 版本(标签由 khluu 于 16 Nov 04:27 创建)。该版本附带两个资源文件,但当前发布页面的更多细节尚未完全加载。
作为大模型推理领域的重要开源项目,vLLM 的每次版本迭代都牵动着部署侧开发者的神经。v0.34.0 的发布意味着项目在持续演进,尽管本次公开信息有限,仍可从版本节奏与社区惯例中解读出一些信号。
vLLM 是加州大学伯克利分校团队主导开发的开源大语言模型推理与服务引擎,核心创新是 PagedAttention——一种借鉴操作系统虚拟内存分页思想管理 KV Cache 的注意力算法,可将显存浪费降低到接近零,从而显著提升吞吐量。vLLM 同时提供兼容 OpenAI API 的服务端接口,支持连续批处理(continuous batching)、张量并行、量化推理与多种主流模型架构,被广泛用于生产环境的模型部署。其版本号目前仍处于 0.x 阶段,意味着 API 与内部实现仍在快速演进中,尚未承诺语义化版本意义上的长期稳定性。
版本节奏与项目活力
从标签创建时间与版本号跨度来看,vLLM 保持着较为稳定的迭代频率。版本号从 0.x 序列持续攀升,说明项目仍处于快速功能积累阶段,尚未进入以稳定性为主的 1.0 时代。
这种高频发布模式对用户而言是双刃剑:一方面能更快获得性能优化与新硬件支持,另一方面也意味着需要更谨慎地管理生产环境的版本锁定。对于追求稳定的团队,建议关注版本的变更日志后再决定是否升级。
信息缺失下的审慎解读
说一下,本次抓取到的原始素材仅为 GitHub Releases 页面的标签信息与加载状态,并未包含具体的更新内容、提交记录或发布说明。因此,关于 v0.34.0 究竟包含哪些新特性、性能提升幅度、是否涉及破坏性变更等关键问题,目前无法从现有信息中得出结论。
对于关注该版本的开发者,建议直接访问项目仓库的 Release 页面或对比提交历史,以获取准确的变更明细。在缺乏官方说明的情况下,任何关于具体功能的推测都缺乏依据。
对推理部署的影响
vLLM 作为高吞吐推理引擎,其版本更新通常会影响显存管理、批处理策略与模型兼容性。虽然本次无法确认 v0.34.0 的具体改动,但按照项目以往的迭代规律,升级前应重点验证自有模型在该版本下的推理正确性与吞吐表现。
若团队正在使用容器化部署,建议在测试环境中先行拉取新版本镜像,观察与现有推理服务的兼容情况,再推进到生产环境。
在 vLLM 的实际部署中,KV Cache 的显存占用通常是大模型推理的主要瓶颈之一。PagedAttention 将每个序列的 KV Cache 切分为固定大小的块,并按需分配非连续显存,配合块级共享机制,使相同前缀的请求可以复用缓存,进而支撑更高的并发批大小。因此,版本更新常涉及显存分配策略、调度器逻辑与 CUDA 内核实现的调整,这些改动会直接影响首 token 延迟、吞吐量与最大并发数等指标。升级时还需注意 CUDA 驱动、PyTorch 版本以及推理镜像基础环境的匹配关系,版本不兼容可能表现为启动报错或性能回退。
小结
v0.34.0 的发布本身是项目活跃度的体现,但本次可获取的信息较为有限。开发者应以官方仓库的完整发布说明为准,结合自身业务场景评估升级必要性。
相关推荐
AI滥用警报:儿童性虐待材料报告两年飙升8400%
Hacker News 报道显示,AI 相关儿童性虐待材料报告两年内增长 8400%。本文分析生成式 AI 如何降低非法内容生产门槛,平台检测与法律监管面临的两难,以及技术对抗的可行方向。

4B小模型专精训练,能否替代大模型?
一位开发者通过训练 Qwen3.5-4B-3D-Coder 与 LFM2.5-350M 发现,专精小模型在 3D 场景生成等任务上表现超出预期。本文解析其关于 epoch 数量、SFT 与 RL 成本对比、以及消费级硬件全量微调的观察。
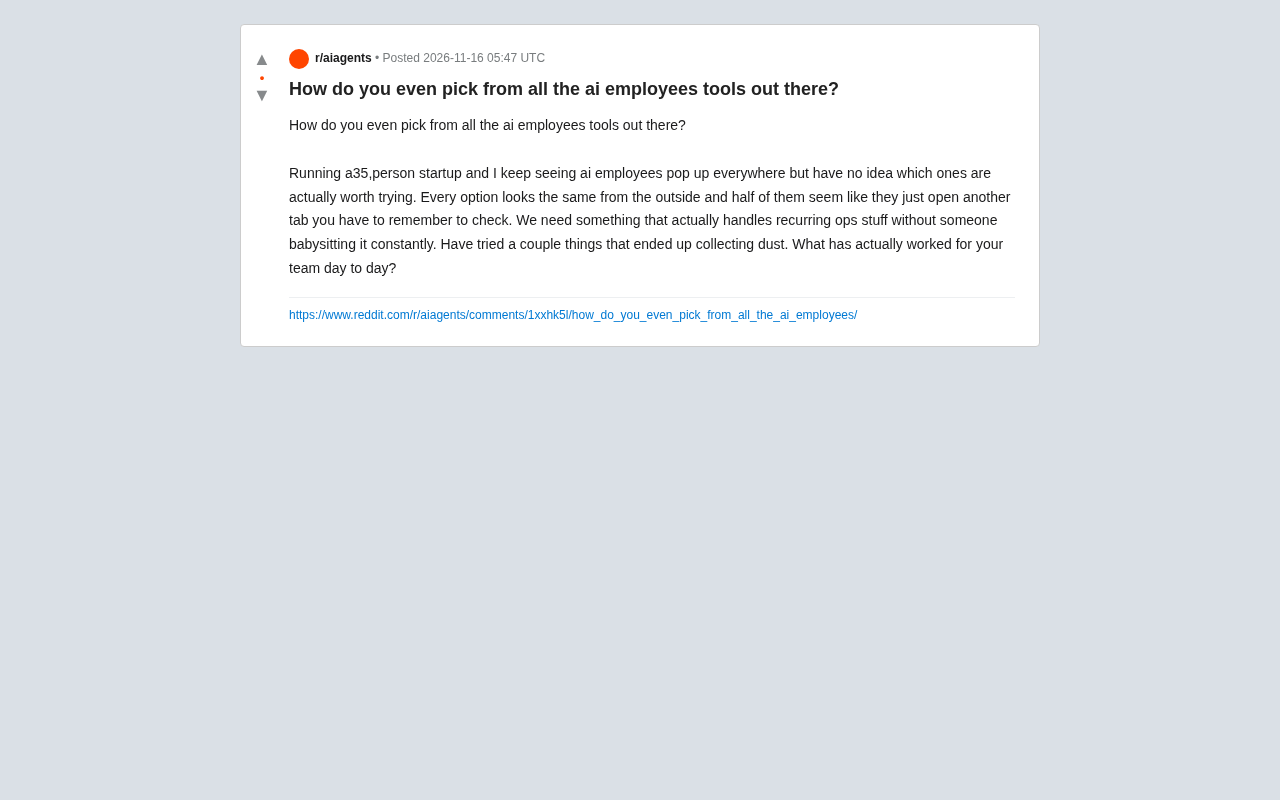
AI员工工具泛滥,35人创业公司如何选出真正能落地的?
35人创业公司面对众多AI员工工具无从下手?本文提炼社区真实经验,从无人值守能力、集成深度、结果可验证性三个硬标准出发,帮你筛选真正能落地的AI员工工具,避免吃灰。