vLLM 在 AgentX 上跑出最佳成绩:破 DeepSeek 推理纪录
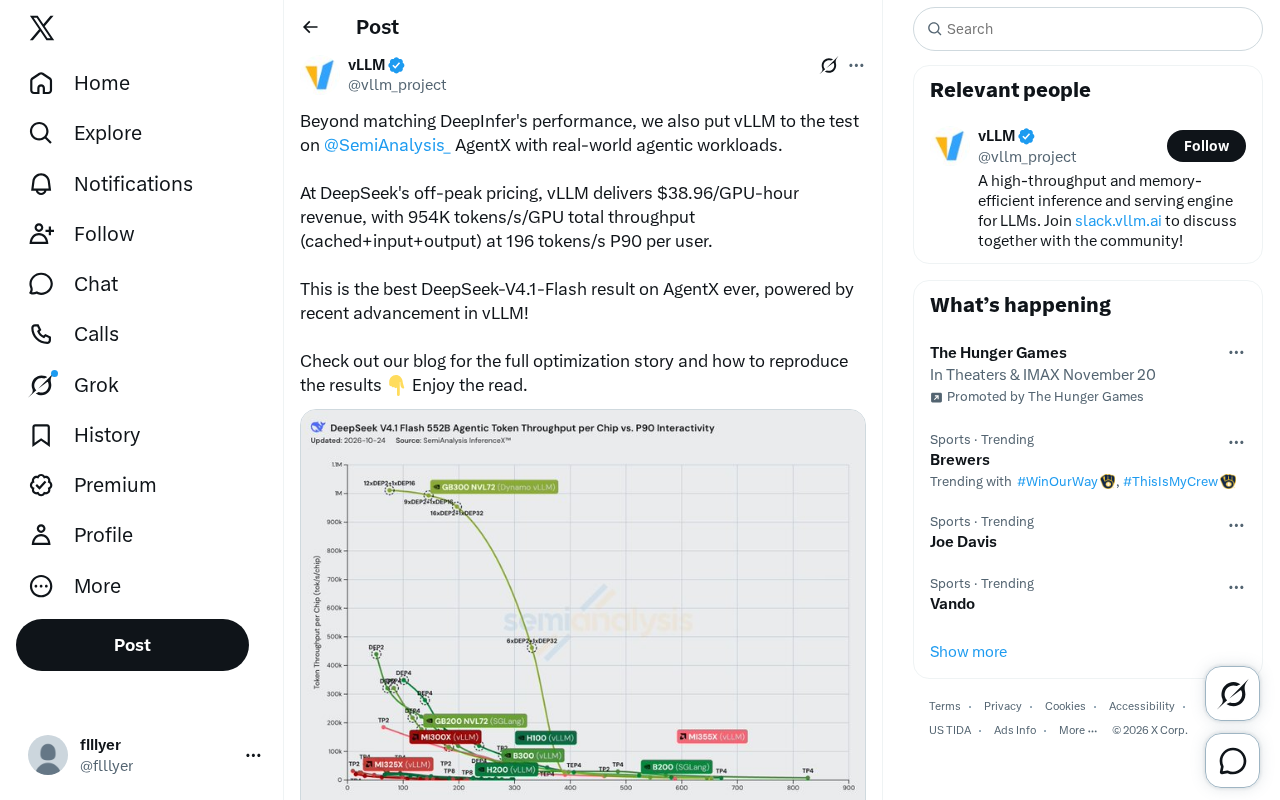
vLLM 在 AgentX 上以真实 agentic 负载刷新 DeepSeek-V4.1-Flash 最佳成绩,吞吐与收入效率双高。
本文解读 vLLM 在 SemiAnalysis AgentX 基准上使用真实 agentic 负载测试 DeepSeek-V4.1-Flash 的结果:总吞吐达 954K tokens/s/GPU(含缓存、输入与输出),P90 每用户吞吐 196 tokens/s,并基于 DeepSeek off-peak 定价实现每 GPU 小时 38.96 美元的收入效率。文章从吞吐与延迟的平衡、收入效率的突破、优化背后的调度与缓存机制、与 DeepInfer 的对比以及对开源推理引擎竞争力的行业启示等角度展开,指出 vLLM 已追平 DeepInfer,显示通用开源引擎在 agentic 场景下的持续迭代能力,并提示优化细节与复现方法见 vLLM 博客。
引言
最近,vLLM 在 @SemiAnalysis_ 的 AgentX 基准测试中,用真实 agentic 负载跑出了 DeepSeek广告-V4.1-Flash 的历史最佳成绩,不仅追平了 DeepInfer 的性能,还在收入效率上给出了亮眼数字。据 Twitter 上的消息,这次测试使用了 DeepSeek 的 off-peak 定价,vLLM 实现了每 GPU 小时 38.96 美元的收入,总吞吐量达到 954K tokens/s/GPU(包含缓存、输入和输出),P90 每用户吞吐为 196 tokens/s。
这组数据来自 vLLM 团队在 AgentX 上的实测,他们表示这是 DeepSeek-V4.1-Flash 在该基准上的最佳结果,背后是 vLLM 近期的一系列优化。本文将从性能指标、优化故事和实际影响三个角度拆解这次测试。
性能指标解读
吞吐与延迟的平衡
954K tokens/s/GPU 的总吞吐量意味着单块 GPU 每秒能处理近百万个 token,这包括了缓存命中、输入处理和输出生成。对于 agentic 工作负载来说,这种吞吐能力直接决定了能同时服务多少并发用户。同时,P90 每用户 196 tokens/s 的延迟表现说明,在高并发下仍能保持不错的响应速度。
Tokens/s/GPU 与 P90 延迟:在大模型推理中,吞吐量指标通常指单块 GPU 每秒处理的 token 总数(含输入、输出及缓存命中),而每用户延迟关注单请求体验。P90 表示 90% 的用户请求在该速率以上,即尾部延迟的参考点。对于 agentic 负载,由于多轮交互和长上下文频繁触发 KV 缓存复用,吞吐量与延迟之间的 trade-off 尤为关键——批处理规模越大,总吞吐越高,但单请求排队延迟可能上升。vLLM 通过 PagedAttention 和连续批处理(continuous batching)来缓解这一矛盾,使高并发下仍能维持可接受的 P90 指标。
收入效率的突破
38.96 美元/GPU 小时的计算基于 DeepSeek 的 off-peak 定价,这为推理服务的经济性提供了参考。在 agentic 场景中,任务通常需要多轮交互,token 消耗量大,高吞吐直接转化为更高的收入潜力。
Off-peak 定价与收入效率:DeepSeek 的 off-peak 定价是指在非高峰时段提供折扣价格的 API 计费模式,通常用于引导负载错峰。收入效率(美元/GPU 小时)并非官方指标,而是将实际处理的 token 量按该定价折算为收入,再除以 GPU 占用时间,用以衡量单位算力的变现能力。这一指标对推理服务商有参考价值:它同时反映吞吐、缓存命中率和定价策略,高吞吐结合低价时段可放大单位 GPU 的收益,但也需注意其依赖于特定定价假设,横向比较时应统一计价口径。
优化背后的故事
vLLM 团队在博客中分享了完整的优化过程,虽然这里没有细节,但可以从结果推断,优化可能涉及调度、内存管理和计算图等方面。AgentX 的 agentic 负载具有交互频繁、状态多的特点,对推理引擎的并发处理和缓存机制要求很高。vLLM 能取得这样的成绩,说明其在处理长上下文和多轮对话时有明显优势。
与 DeepInfer 的对比
推文提到“匹配 DeepInfer 的性能”,暗示此前 DeepInfer 可能是该基准的领先者。vLLM 此次不仅追平,还在某些指标上可能有所超越。不过,具体对比数据未在推文中给出,需要参考博客全文。
Agentic 负载的特征:与传统的单轮问答不同,agentic 工作负载通常包含工具调用、多步推理和状态维护,表现为大量短请求与长上下文交替、频繁的缓存读写以及不规则的到达模式。这类负载对推理引擎的调度器提出更高要求:需要快速回收和复用 KV 缓存、支持前缀共享(prefix caching)以减少重复计算,并在多轮对话中保持会话状态。vLLM 的自动前缀缓存和分页式 KV 管理正是针对此类场景的关键优化方向,也是其在 AgentX 上取得高吞吐的重要背景。
对行业的影响
这次测试结果对 AI 推理领域有几点启示。首先,开源推理引擎如 vLLM 正在快速缩小与专用方案的差距,甚至在特定场景下实现反超。其次,agentic 工作负载的优化需要针对性的设计,通用引擎通过持续迭代也能达到不错的效果。最后,收入效率的量化指标为服务提供商提供了成本收益评估的依据。
结语
vLLM 在 AgentX 上的表现展示了开源推理引擎的潜力,也为 DeepSeek-V4.1-Flash 的部署提供了新的选择。随着优化工作的推进,我们有望看到更多实际场景中的性能提升。
相关推荐
WorkBuddy AI智能体实战:从大模型到Agent的落地差异
通过批量转PDF实战对比,解析WorkBuddy AI智能体与大模型产品的本质差异,涵盖授权执行、积分消耗、场景适配与落地认知,帮你判断Agent工具是否适合当前工作流。
GrokBot之父:月合千个PR,智能体自动合并的工程心法
SpaceX背景AI工程师分享GrokBot工作流:一个月合入约千个PR,智能体自动合并20个。核心方法论围绕验证技能、EVAL测试、Dune架构与硬性CI约束,揭示如何从本地信任走向云端代理自动化。
Bright Data评测:免费额度、AI智能体MCP服务器与定价
Bright Data 提供免费 5000 额度、开源 MCP 服务器及代理/抓取 API。了解其定价模式、AI 助手集成方式和合规注意事项。