vLLM大会圆满落幕:开源推理引擎社区的爆发力
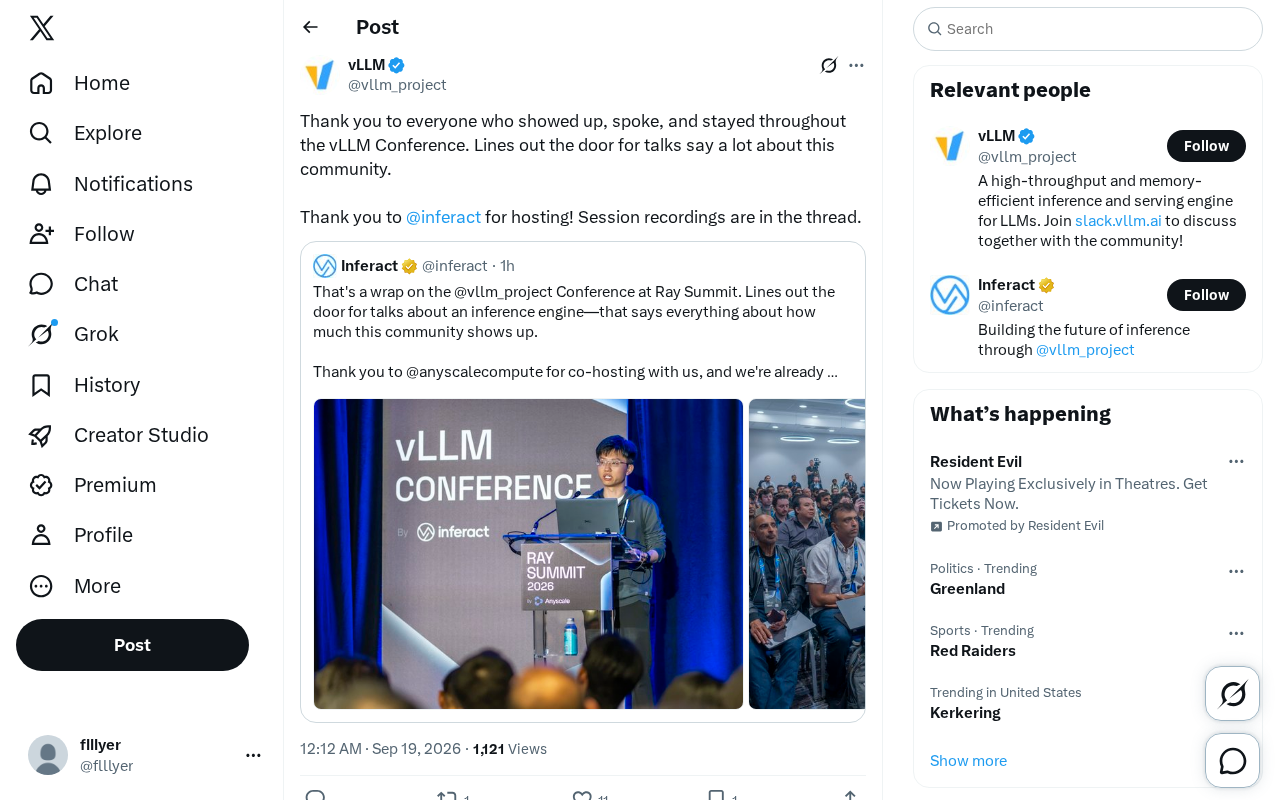
vLLM线下大会一票难求,折射出开源大模型推理框架社区的蓬勃生态与旺盛需求。
vLLM大会近日圆满落幕,多场演讲出现观众排队至门外的盛况,全部录像已向公众开放。vLLM是目前最主流的开源大语言模型推理框架,以PagedAttention技术为核心,通过精细的显存分页管理大幅提升并发吞吐量,精准切中企业大规模部署模型时的成本与延迟痛点。大会的火爆人气,既是真实工程需求在社区层面的映射,也是线下交流不可替代价值的体现——面对面的技术分享与即兴讨论,往往能催生线上协作难以形成的深度连接。对于关注推理优化的从业者而言,官方公开的演讲录像是追踪该领域最新进展的一手资料。
vLLM大会现场:一票难求的社区盛况
vLLM大会近日圆满落幕。据主办方在社交平台发布的致谢信息,本次会议现场火爆,多场演讲出现「排队排到门外」的盛况——这一细节本身,就足以说明vLLM社区当下的活跃度与影响力。
主办方特别感谢了所有到场、发言并全程参与的与会者,同时向承办方 @inferact 表达谢意。会议的各场演讲录像已在官方线程中陆续放出,供无法到场的开发者回看。
对于关注大模型推理优化的从业者来说,这样一场聚焦开源推理引擎的线下会议,能吸引到需要「排队入场」的人气,反映出高效推理已成为AI基础设施领域最受关注的方向之一。
为什么vLLM能聚拢如此高的人气
vLLM是当前最主流的开源大语言模型推理与服务框架之一。它以PagedAttention等核心技术著称,通过更精细的显存管理和批处理调度,大幅提升了LLM在生产环境中的吞吐量与资源利用率。
随着大模型从实验室走向规模化部署,推理成本、延迟和并发能力成为企业落地的核心痛点。vLLM恰好切中了这一需求,成为众多团队部署开源模型时的默认选择。一场以它为主题的技术大会能座无虚席,正是这种真实需求在社区层面的映射。
「排到门外的队伍说明了很多东西」——主办方这句略带感慨的表述,指向的其实是一个正在快速壮大的开发者生态。当越来越多的工程师围绕同一套开源工具展开交流,工具本身的生命力和技术路线的正确性也随之得到验证。
PagedAttention是vLLM的标志性创新,其设计灵感来源于操作系统的虚拟内存与分页机制。传统LLM推理框架在处理KV Cache(键值缓存)时,会为每条请求预分配连续的显存块,导致大量内存碎片和浪费——尤其在多并发、变长序列场景下问题突出。PagedAttention将KV Cache拆分为固定大小的非连续"页"进行管理,不同请求可以共享相同的前缀缓存页,显著降低了显存占用。实测数据表明,相比朴素实现,vLLM在相同硬件上可将推理吞吐量提升数倍。这一底层机制的突破,是vLLM能迅速成为生产部署首选工具的技术基础。
开源社区线下聚会的价值
线上协作是开源项目的常态,但线下大会有着不可替代的作用。面对面的技术分享、走廊里的即兴讨论、贡献者与使用者之间的直接对话,往往能催生线上难以形成的深度连接。
本次会议的录像已全部公开,这延续了开源社区一贯的知识共享精神。即便未能到场,全球的开发者依然可以通过回放获取一线的技术洞见。这种「开放」不仅体现在代码上,也体现在会议内容的传播方式上。
对于希望深入vLLM技术细节、了解其未来演进方向的读者,建议关注官方线程中放出的演讲录像,从中获取关于推理优化、部署实践以及社区规划的第一手信息。
vLLM自2023年由UC Berkeley团队开源以来,已吸引数百名外部贡献者,形成了活跃的GitHub社区与Discord讨论频道。其生态覆盖模型兼容层(支持LLaMA、Mistral、Qwen等主流架构)、多种部署接口(OpenAI兼容API、异步引擎等)以及硬件后端扩展(NVIDIA GPU、AMD ROCm、部分TPU支持)。线下大会作为这一分布式社区的"线下节点",为核心贡献者、企业用户和研究人员提供了难得的同步交流机会,有助于推动路线图讨论、对齐优先级,并加速从会议共识到代码合并的转化周期。
小结
受限于原始信息,本文更多是对这场大会热度与社区意义的观察,而非具体技术议程的解读。但从「一票难求」这一现象出发,已足以看到开源推理引擎领域的旺盛需求。想要深入了解的读者,可通过官方公布的会议录像继续追踪相关内容。
相关推荐
Vibe Coding实战:培养产品思维,用AI把日常需求变成能变现的APP
Vibe Coding系列教程第二篇,讲解独立开发者如何培养产品思维、从模仿与生活痛点中发现需求,并用AI Agent自动化调研流程,快速判断一个APP创意是否值得投入开发与变现。
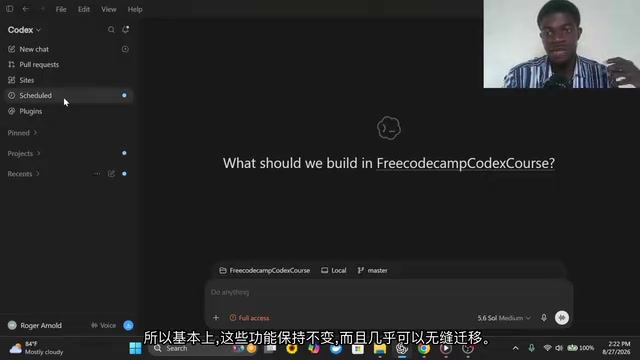
OpenAI Codex 上手指南:用AI代理构建并部署应用
OpenAI Codex 速成课中文整理:从安装、价格套餐、插件与自动化,到 Plan/Go 命令、技能系统,并实战演示用声控 Flappy Bird 游戏走通构建与部署全流程,帮你真正上手这款自主 AI 编码代理。
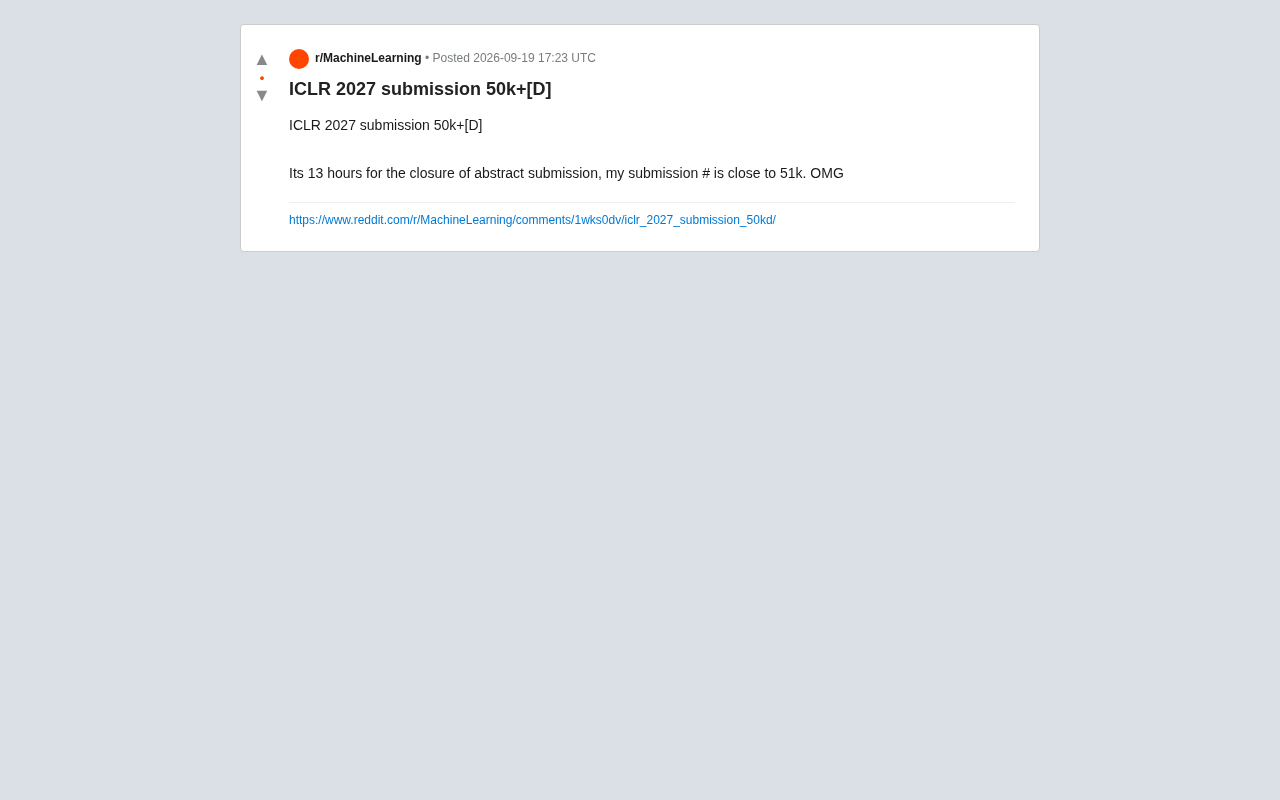
ICLR投稿量突破5万:AI顶会为何持续爆炸式增长
ICLR 投稿编号逼近 5.1 万引发 Reddit 热议。本文分析 AI 顶会投稿量爆炸式增长的原因、对评审系统的压力,以及数字背后的行业信号与反思。