vLLM追平DeepSeek自研引擎DeepInfer:解码性能背后的技术博弈
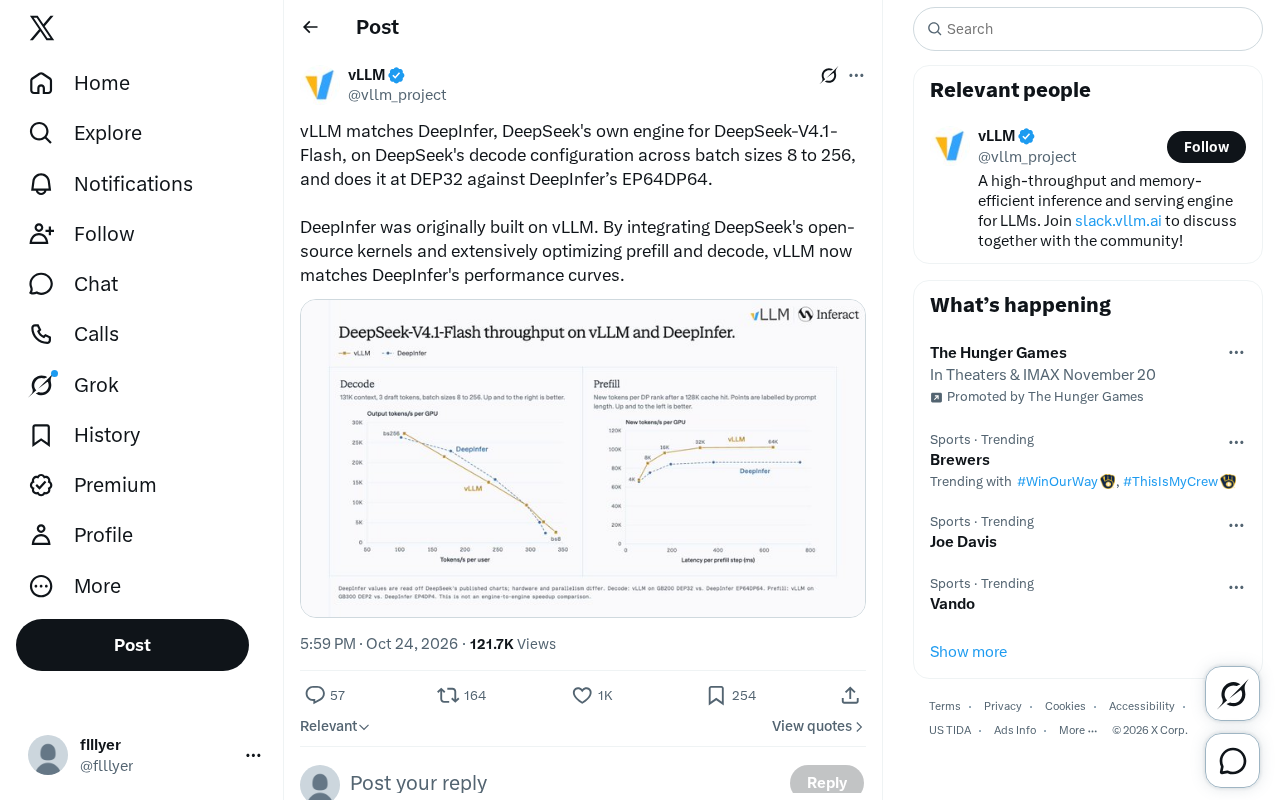
vLLM在DeepSeek-V4.1-Flash解码配置下以更少并行路数追平DeepInfer,彰显开源协作加速推理优化。
开源推理引擎vLLM在DeepSeek-V4.1-Flash的解码配置下,于batch size 8至256范围内性能追平DeepSeek自研引擎DeepInfer。关键差异在于vLLM仅用DEP32(数据并行32路),而DeepInfer采用EP64DP64(专家并行64路+数据并行64路),意味着vLLM以更低通信开销和更简部署拓扑达到相近吞吐。DeepInfer最初基于vLLM构建,集成DeepSeek开源内核并优化prefill/decode;vLLM随后将这些内核整合并深度优化,形成“模型厂商开源内核→推理引擎集成→社区受益”的良性循环。对开发者而言,单一vLLM栈可服务多模型并降低维护成本,但预填充、长上下文及不同硬件平台的表现仍需验证。
近期,一条来自社交平台的消息在AI工程圈引发讨论:开源推理引擎vLLM在DeepSeek-V4.1-Flash的解码配置下,性能已经追平DeepSeek自家的推理引擎DeepInfer。更具体地说,在batch size从8到256的范围内,vLLM的解码性能与DeepInfer不相上下,而vLLM仅使用了DEP32的并行策略,DeepInfer则采用了更复杂的EP64DP64配置。
这一消息之所以值得关注,不仅因为vLLM是开源社区最活跃的推理框架之一,更因为它揭示了一个趋势:通用推理引擎与模型厂商自研引擎之间的性能差距正在迅速缩小。
性能追平:不只是数字游戏
根据原始推文,vLLM在DeepSeek广告的解码配置下,于batch size 8至256的区间内,性能曲线与DeepInfer基本重合。关键在于并行策略的差异:vLLM使用DEP32(数据并行32路),而DeepInfer使用EP64DP64(专家并行64路、数据并行64路)。
从工程角度看,更少的并行路数意味着更低的通信开销和更简单的部署拓扑。如果vLLM确实能在DEP32下达到DeepInfer在EP64DP64下的吞吐,那么对于资源有限的团队来说,vLLM的性价比优势会非常明显。不过,推文没有披露具体的吞吐数值、延迟指标或硬件配置,因此我们无法量化这一性能对等的程度。但“曲线匹配”的描述至少表明,在DeepSeek定义的解码场景中,vLLM已经不再是追赶者。
数据并行(DP)与专家并行(EP) 是大模型推理中两种关键的并行策略。数据并行将相同的模型副本分配到多个设备上,每个设备处理不同的输入批次,梯度或参数更新时进行同步,适合提升吞吐量且实现简单。专家并行则常见于混合专家(MoE)模型,将不同的“专家”子网络分布到不同设备上,每个token根据路由结果被发送到对应的专家设备进行计算,能有效扩展模型容量但会引入更复杂的通信模式(如all-to-all)。文章中的DEP32指数据并行32路,EP64DP64指专家并行64路叠加数据并行64路,后者需要更多的设备与更复杂的通信拓扑。理解这两种并行方式的差异,是评估“vLLM以更少并行路数达到相近性能”这一结论含金量的关键。
DeepInfer的出身与vLLM的进化
推文中还有一个关键信息:DeepInfer最初就是基于vLLM构建的。DeepSeek在vLLM的基础上集成了自家开源的内核,并对prefill和decode阶段进行了大量优化,才形成了DeepInfer。
这解释了为什么vLLM能够快速追平:vLLM团队将DeepSeek开源的内核整合进vLLM,并针对prefill和decode做了深度优化。换句话说,DeepSeek把优化成果回馈给了开源社区,而vLLM则将这些成果产品化,惠及更广泛的模型和硬件生态。这种“模型厂商开源内核 → 推理引擎集成 → 社区受益”的循环,正是当前AI基础设施领域最健康的协作模式之一。
推理引擎中的prefill与decode阶段 是理解性能优化的基础。prefill阶段处理用户输入的完整提示序列,计算量大、并行度高,通常受限于算力;decode阶段则逐个生成输出token,具有自回归特性,每步只处理一个token,往往受限于内存带宽和KV缓存访问。两个阶段的瓶颈不同,优化手段也各异:prefill适合用大矩阵乘法和批处理提升吞吐,decode则更依赖KV缓存管理、连续批处理(continuous batching)和投机解码等技术。DeepSeek对这两个阶段分别做了大量优化并开源内核,vLLM将其集成后能快速追平,正是因为抓住了推理性能的核心矛盾。这也解释了为何文章强调“解码配置”下的性能对比——decode阶段通常是推理延迟和吞吐的关键战场。
对开发者的实际意义
对于使用vLLM部署DeepSeek系列模型的团队来说,这一进展意味着不必再为了极致性能而切换到DeepInfer。vLLM的通用性、社区支持和文档生态,加上 now 与自研引擎持平的性能,使其成为更稳妥的选择。特别是当团队同时服务多个模型时,维护一套vLLM栈显然比维护多套专用引擎更高效。
当然,也需要理性看待:DeepInfer可能针对DeepSeek-V4.1-Flash做了更极致的端到端优化,而vLLM的匹配仅限于解码配置和特定batch区间。预填充阶段、长上下文场景、不同硬件平台上的表现,仍需更多数据验证。
DeepSeek-V4.1-Flash 从命名看是DeepSeek系列中面向低延迟、高吞吐场景的模型版本,“Flash”通常暗示其在推理效率上做了特别优化,可能采用了更稀疏的MoE结构或更激进的量化/蒸馏策略。这类模型对推理引擎的解码性能尤为敏感,因为其设计目标就是快速响应。vLLM能在该模型的解码配置下追平专用引擎,说明通用引擎对新兴模型架构的适配速度在加快。但开发者需注意,不同模型版本(如标准版与Flash版)的并行策略和内核优化可能不通用,部署时应针对具体模型验证batch区间和硬件配置下的实际表现。
开源协作的胜利
这则消息最值得玩味的地方在于,它展示了开源如何加速推理优化。DeepSeek选择将内核开源,vLLM选择集成并优化,最终让整个社区在更少的并行资源下获得与专用引擎相当的吞吐。对于正在构建AI应用的开发者而言,这无疑是一个积极的信号:最好的推理引擎,可能不再是某个闭源黑盒,而是那个持续吸收各方优化、快速迭代的开源项目。
随着vLLM继续合并来自模型厂商的优化,通用引擎与专用引擎之间的界限会越来越模糊。而这场性能追平,或许只是开始。
相关推荐
WorkBuddy AI智能体实战:从大模型到Agent的落地差异
通过批量转PDF实战对比,解析WorkBuddy AI智能体与大模型产品的本质差异,涵盖授权执行、积分消耗、场景适配与落地认知,帮你判断Agent工具是否适合当前工作流。
GrokBot之父:月合千个PR,智能体自动合并的工程心法
SpaceX背景AI工程师分享GrokBot工作流:一个月合入约千个PR,智能体自动合并20个。核心方法论围绕验证技能、EVAL测试、Dune架构与硬性CI约束,揭示如何从本地信任走向云端代理自动化。
Bright Data评测:免费额度、AI智能体MCP服务器与定价
Bright Data 提供免费 5000 额度、开源 MCP 服务器及代理/抓取 API。了解其定价模式、AI 助手集成方式和合规注意事项。