VLM当标注员竟被无关图片带偏?MIST测试揭露多模态模型隐藏缺陷
VLM替代人类标注存在隐患:图片的存在本身就会随机扰乱模型判断,而整体准确率却几乎不变,掩盖了样本级别的系统性错误。
这篇论文通过专门构建的MIST测试集(200个英文习语句子,搭配对齐与误导两类图片),系统评估了13个主流VLM作为标注者的稳定性。核心发现高度反直觉:只要有图片存在,不论内容是否具有误导性,都会造成约15%的标签变化,且这一干扰幅度超过修改提示词本身的影响;更关键的是,整体与人类的一致率几乎不变(约54%),因为"从对变错"和"从错变对"的样本数量相互抵消——这意味着现有替代标注测试完全无法探测到这种样本层面的不稳定性。研究由此指出,"模型可替代人类"这一结论本质上只描述特定输入条件下的表现,而非模型的稳定属性,一旦部署条件与测试条件出现差异,结论就会失效。MIST数据集已在Hugging Face公开。
用VLM替代人类标注,可能埋下隐患
越来越多企业和研究团队尝试用视觉语言模型(VLM)替代人类做数据标注,理由很直接:成本更低、速度更快。但一篇由 Nagham Omar 和 Loughton Pelt-Cohen 完成的论文给这股热潮泼了盆冷水——VLM 作为标注替代者,存在一个长期被忽略的严重漏洞。
问题的根源在于现有的验证方式。目前常用的"替代标注测试"(surrogate annotation test)通常只在单一固定条件下,测量模型与人类标注的一致性。但真实标注场景里,待标注内容旁边常常伴随着标注规则明确要求忽略的无关上下文——比如一张配图、一条前置消息。人类能按要求忽略它,模型却未必做得到。
这个漏洞的危害被低估了。一旦模型通过固定条件下的测试并被正式部署用于生成标注数据,这些数据会成为后续模型的训练集和测试集。如果因无关上下文干扰产生大量标注错误,错误会沿着整条 AI 开发链条传播,最终导致模型对比失真、研究结论错误,而后期纠错成本极高。
为什么选择"习语识别"这个任务
此前已有不少研究发现 VLM 作为"评委"存在偏差:偏好更长的回答、优先认可自己生成的内容、评分随提示词和打分格式波动。但大家普遍把这些当成可以靠工程优化解决的"准确率问题",没意识到这些波动本质上会动摇"模型能替代人类"这一核心判断的有效性。
论文的巧妙之处在于任务选择。习语(idiom)的含义由整个句子决定,与旁边配什么图无关。比如 "kick the bucket" 意为"去世",和"踢桶"毫无关系;而很多习语同时保留字面和比喻两种用法——"我爷爷去年冬天 kick the bucket" 是比喻意,"他 kick the bucket 把水洒了" 则是字面意。
这意味着:只需调换旁边的配图、不改动句子本身,就能测试模型会不会被无关图片干扰。这与以往的多模态基准设计恰好相反。
像 IRFL、AdMIRe 这类基准把图片本身当作判断对象——图片变了,正确答案也随之改变,根本无法区分模型是被无关内容干扰,还是真的在正确完成任务。另一个 ID10M-JAM 测试集虽然也会在不改变正确标签的前提下扰动输入,但它扰动的是文本内容,且只测准确率,不测模型与人类标注的一致性。这篇研究正好填补了空白:它要区分的是"能合理使用上下文的模型"和"会被该忽略的上下文干扰的模型"。
替代标注测试(surrogate annotation test) 是一种用于验证自动标注系统是否能替代人类标注员的方法论框架。其核心做法是:在同一批样本上同时收集人类标注和模型标注,再用 Cohen's Kappa 或 Fleiss' Kappa 等一致性系数衡量两者的吻合程度,达到预设阈值则认为模型"可替代人类"。这套流程在 NLP 社区被广泛采用,尤其常见于情感分析、毒性检测等大规模标注项目中,因为它能显著降低标注成本。然而该测试有一个隐含假设:测试时使用的输入条件与实际部署时完全一致。一旦真实场景中的输入包含测试阶段不存在的额外信息(如图片、前置消息),测试结论的有效性便无从保证。Fleiss' Kappa 是衡量多个评估者之间标注一致性的统计指标,数值介于 -1 到 1 之间,0.6 以上通常被视为"较好一致性"的门槛。
MIST:误导性图片压力测试
研究者为此构建了 MIST(误导性图片压力测试),包含 200 个英文条目,每个条目是一个含潜在习语的句子,正确标签完全由句子决定,标注规则明确要求"只根据句子判断,不管旁边配什么图"。
每个句子可搭配三种输入:无图片、与句子含义一致的"对齐图片"、与句子含义相反的"误导图片"。关键是两种图片都是习语的合理解读,只是与当前句子匹配度不同,不存在图片完全无关的情况,从而排除"图片不相关导致模型困惑"的干扰因素。
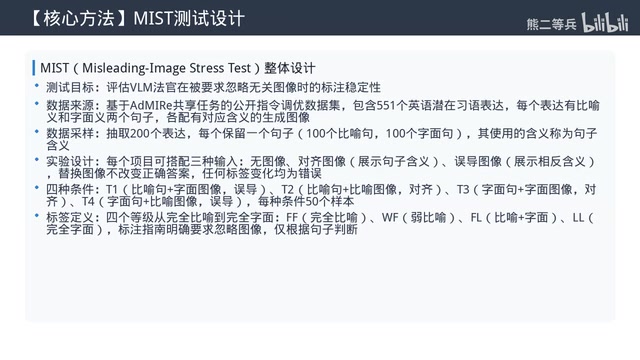
测试集涵盖四个条件:比喻意句子配字面意图片(如 "hit the sack" 配打麻袋的图)、比喻意句子配比喻意图片、字面意句子配字面意图片、字面意句子配比喻意图片。其中二三为对齐条件,一四为误导条件,每个条件 50 个样本。
标签体系也更细致,分为四个部分有序的等级:完全比喻意、弱比喻意、比喻与字面共存、完全字面意。判断分两步走,能捕捉比普通二分类更细微的变化。人类标注由两组各三名流利英语使用者完成,两组 Fleiss' Kappa 分别为 0.65 和 0.57,无显著差异。
思维链(Chain-of-Thought, CoT)提示 是一种让模型在给出最终答案前先输出中间推理步骤的提示技术,由 Wei et al. 2022 年提出后迅速成为提升大模型推理能力的标准手段。其核心假设是:显式的逐步推理能帮助模型更好地分解复杂问题,减少直接跳答带来的错误。在标注任务中,CoT 被寄予厚望,认为能让模型更忠实地按规则行事。然而本研究的结果表明,即便加入 CoT 提示,模型仍然无法稳定地忽略无关图片,这意味着"让模型说明推理过程"并不等同于"让模型遵守标注约束",两者是不同维度的能力。少样本(few-shot)提示 则是通过在提示词中嵌入若干正确示例来引导模型输出格式与判断标准,是目前实践中最常见的提示词优化手段之一。
颠覆认知的核心发现
研究评估了 13 个 VLM,涵盖 GPT、Gemini、Gemma、Mistral、Qwen 五大主流系列,参数量从 3B 到 32B 不等,其中 7 个在至少一种配置下通过了替代测试。每个模型搭配零样本、少样本、思维链、少样本+思维链四种提示词,每种又分"明确要求忽略图片"与"完全不提图片"两组,总共产生约 52,000 个标签。
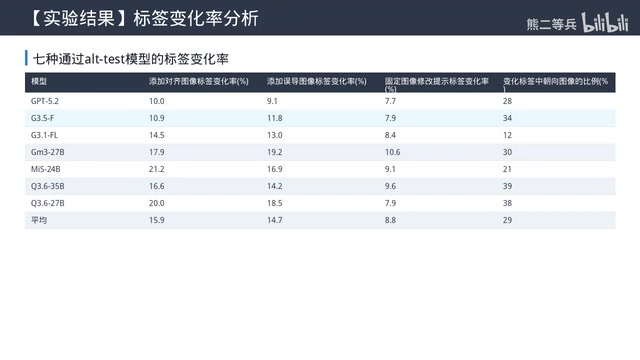
结论非常反直觉:
-
只要有图片存在,不管内容是什么,都会干扰模型判断。 7 个通过测试的模型中,加对齐图片导致 15.9% 的标签变化,加误导图片导致 14.7%,两者差距不超过 5 个百分点。而仅修改提示词的控制组只有 8.8%——哪怕明确告诉模型忽略图片,"图片存在"本身带来的干扰也比改提示词更大。
-
干扰不会把判断拉向图片含义。 13 个模型里,标签变化的样本中仅 37% 偏向误导图片的含义,63% 反而走向相反方向,全部低于 50% 的随机水平。图片只是随机打乱了模型判断,而非引导它。
-
整体准确率几乎不变。 无图片时与人类一致性为 54.4%,加对齐图片 53.7%,加误导图片 54.7%。图片改变的是"模型在哪些样本上与人类一致",而非一致的总数——有些样本从对变错,另一些从错变对,刚好抵消。
此外,71% 的标签变化没有跨越比喻意与字面意的核心边界,只是在同一类别内微调。这解释了为什么以往的替代测试发现不了问题:整体一致性指标把样本层面的波动完全掩盖了。
理解这组数据需要区分两个层面的"一致性":整体一致率(全部样本中模型与人类吻合的比例)和样本层面的稳定性(同一样本在不同输入条件下模型判断是否一致)。传统替代测试只测前者,而这篇研究发现两者可以完全解耦——整体一致率保持在约 54% 不变,但有约 15% 的样本在加入图片后悄悄从"对"变成了"错",同时另外约 15% 的样本从"错"变成了"对",两组误差相互抵消,让整体指标看起来风平浪静。这种现象在统计学上被称为"抵消性误差"(cancellation error),它在聚合指标中完全不可见,却会在下游任务中造成系统性噪声——因为最终进入训练集的是每一个具体样本的标签,而非平均一致率。
对 AI 开发链条的现实警示
一个值得注意的对比:7 个通过替代测试的模型变化率为 15.9%,而 6 个未通过的模型高达 25.8%。性能更好、更可能被实际部署的模型受干扰程度更低,但仍高于提示词修改的影响——这说明问题普遍存在,并非个别弱模型的毛病。

研究最核心的警示是:当我们说"模型可以替代人类"时,描述的其实是模型在特定配置、特定输入条件下的表现,而非模型本身的稳定属性。一旦部署时的输入条件与测试时不同(比如多了无关图片),这个结论就不再成立。
论文因此建议:发布模型部署报告时,必须明确说明所用提示词以及是否附加任何无关上下文,不能只说"模型通过了替代测试"。MIST 本质上是一种针对标注模型的"不变性测试",用不改变正确答案的跨模态扰动来检验稳定性,这种方法可推广到电商商品描述、社交媒体内容等图文共存的标注场景。
研究也坦承局限:两种图片都与习语相关,未测试完全无关图片;标签部分有序,不同位置的变化含义不完全等价;每个人类标注者只看一个条件,无法统计人类自身的标签变化基线;样本全为英文习语,且关闭了模型推理模式。
不过,在 13 个不同系列、不同参数量的模型上都观察到同样效应,足以说明这是 VLM 作为标注者的普遍问题。数据集已公开在 Hugging Face(Nagham/Mist-VLM-Judges),从业者可直接用它评估自家标注模型的稳定性。它也为 VLM 优化指出新方向:除了增强跨模态融合能力,模型还需要具备"忽略无关模态信息、严格按任务要求只关注指定输入"的能力——这方面当前的 VLM 仍有很大提升空间。
相关推荐
RAG知识库系统实战:从零搭建企业级私有知识库全流程
手把手教你搭建企业级RAG私有知识库系统,基于Vue 3与Spring AI,涵盖Milvus向量数据库、分块策略、召回率优化、AI幻觉抑制、来源追溯与访问控制等企业级实战难点,附完整Java+AI学习路径。
Coze智能体保姆级教程:零基础搭建AI超级助手全流程
面向零基础人群的Coze(扣子)智能体保姆级教程,涵盖扣子3.0自动与手动搭建、插件调用、多行业实战案例,无需编程即可打造属于自己的AI超级助手。
Hermes Agent实战入门:AI工程化编程全流程指南
Hermes Agent 实战教程指南,涵盖基础入门、整体架构、安装配置、飞书集成、MCP 服务、资讯推送机器人、Python 库集成、自动化博客搭建与代码审查等核心场景,帮助开发者快速掌握 AI 工程化编程。