我让AI语音帮我审批邮件,结果3封出了错
给AI邮件代理加一层语音输出,发现语音的流畅自信会悄悄消解人的审查意愿。
一位开发者为成熟的AI邮件代理加上语音输出层,用一整个工作日只靠听声音来审批代理的决策。结果24条正确、3条出错,而那3个错误都是用眼睛读文字时能立刻抓到的。问题的根源不在模型:日志文件在不确定时看起来就是不确定的,而语音无论内容对错始终平滑笃定,人会不自觉地把"听起来有多确定"当作"它是对的"的证据。速度的提升与审查度的下降是同一个数字的两面——更快意味着更少的怀疑时间。作者的结论是保留语音但划定边界:语音只用于输出与播报,凡涉及发送、花钱或约定日程的操作,必须以文字形式用眼睛读过再确认。
一位开发者做了一个看似简单的实验:给自己用了几个月的邮件代理(AI agent)加上一层语音输出,然后用一整个工作日只靠语音来审批它的工作。日志窗口全程关闭,直到最后才打开清点语音到底让他付出了什么代价。结果令人警醒——24条正确,3条错误,而这3个错误本来都是他只要读一眼文字就能当场抓到的。
一个运行良好的代理,加上一层语音
这个AI代理本身已经相当成熟:它读取收件箱、起草回复、标记出两三封真正需要人类处理的邮件,还能在不经询问的情况下调整日历。作者承认它"确实很好用",但也坦白自己几个月来一直是在"略读"而非"检查"它的输出——屏幕被填满、看起来像有人做了活儿,于是略读就产生了检查的错觉。
他点出一个被忽视的交互本质问题:无论模型多聪明,如果它触达你的唯一方式是在你双手忙碌时甩来一堵文字墙,那你依然是瓶颈。这不是模型的错,而是一种糟糕的联络方式。于是他只加了一层改动——文字进,音频出(text in, audio out),模型、指令、权限全部不变。他反复强调"声音不该改变它做什么,只改变我如何检查它"。而这恰恰是他后来发现自己判断错误的地方。
技术实现:一个函数搞定的语音层
语音层本身的工程量极小。作者使用了 Fish Audio 的 S2.1 Pro 模型,选它的核心理由是跨语言保持同一个声音。他的受众有一半在印度,需要一个在英语和印地语之间切换时听起来仍像"同一个人"的代理,而不是两个不同的机器人轮流说话。
整个集成就是一个函数:传入文字和一个 voice ID,返回音频。无需重新训练,无需第二个模型。他顺手把同一个函数复用到了另外两个场景——早晨煮咖啡时播报的"晨间简报",以及用同样声音讲的睡前故事。
这正是语音层的价值所在:一旦它变成一个函数,代理已经产出的每一段文字都变成了你可以"听"的东西。作者也提到该 S2.1 Pro 开发者 API 当时免费开放(截至11月底,受合理使用政策约束),可用于在自己的代理上测试。
Fish Audio S2.1 Pro 所采用的核心技术是跨语言语音克隆(cross-lingual voice cloning)。传统的文字转语音(TTS)系统针对不同语言往往需要独立训练的声学模型,切换语言时声音特征会发生明显变化。S2.1 Pro 通过在多语言语料上联合训练,将说话人的音色特征(音调、节奏、共鸣)与语言的音素体系解耦,使同一个 voice ID 在英语、印地语等不同语言下能保持一致的"嗓音身份"。对于面向多语言受众的代理来说,这避免了用户因声音切换而产生的割裂感,也降低了维护多套声音资产的工程成本。值得注意的是,这类模型的流畅度和情感一致性正是本文讨论的"双刃剑"——它被设计成永远听起来自然、笃定,而这种设计目标与"审计场景下需要传达不确定性"的需求之间存在根本冲突。
当语音接管审批:问题开始显现
真正有趣的部分不是代码,而是"与它共同生活"的体验。作者给代理起了名字,开始对它说"请",甚至在打断它时出声道歉——这些细节很好笑,直到它不再好笑。
当信息以语音形式抵达时,他发现自己的检查标准"悄悄消失了"。他特别强调:信息完全相同——同一个代理、同一份草稿、同一个决定,唯一变化的是它以声音的形式到来。
在工作会话的很长一段时间里,这是他的系统"感觉最好的时候":他不在桌前,代理把一天的安排念给他听,他双手忙碌时用语音快速回答yes或no,又快又顺。他写下一句点睛的话:"世界上最快的界面,是一个你永远不必确定的界面。"
语音是出色的叙述者,却是糟糕的审计员
转折发生在几次审批之后——代理用那种一贯平静笃定的语气,说出了一句"彻底错误"的话。作者之所以抓住它,纯粹是因为他碰巧知道正确答案。
他对失败点的剖析很精确:这不是语音模型的错,音频表现完美,那句话本身就是错的。语音模型从来没有对内容真伪发表过意见。
关键洞察在于:日志文件在不确定时看起来就是不确定的——你能看到它的措辞犹豫,看到它自我争辩。但语音从头到尾都是平滑的,无论对错。而他一整天都把"听起来有多笃定"当成了"它是对的"的证据。这不是证据,这只是一种语气。
这一现象与认知科学中的副语言线索(paralinguistic cues)研究高度吻合。人类在面对面沟通时,会依赖语速犹豫、音调抖动、停顿填充词("呃""嗯")等声学特征来判断说话者的确信程度。然而 TTS 系统的训练目标是最大化自然度和流畅度,它会系统性地消除这些"不确定性信号"——无论输入文本是否包含模糊措辞,输出音频的韵律都趋向平稳。与此同时,文字界面天然保留了视觉层面的不确定性线索:措辞的犹豫("可能""似乎")、自我修正的句式、异常的格式排布,读者的眼睛会被这些信号自动吸引。语音则将这些差异全部"熨平",导致听者在无意识层面对所有信息赋予同等的可信度权重,这正是作者所说的"把语气当成了证据"的神经机制根源。
结算:速度与审查是同一个数字
最终清点:24对3错。而这3个错误全是他读文字时能当场抓到的。作者的反思直指核心——他的速度大幅提升,而审查度下降了大致相同的幅度,直到计数器摆在屏幕上他才意识到。
"我一直把它读成两个结果,一个好的、一个坏的。但它不是两个数,它是同一个数出现了两次。"如果某样东西让你决策更快,你得到的就是更少的怀疑时间——这就是"更快"的含义。它从未欺骗他,它只是拿走了摩擦,而那个摩擦"一直在替我思考"。
可直接借鉴的两条规则
作者保留了语音层,但为它划定了明确边界,这也是对所有想自建此类代理的人最实用的建议:
- 语音只用于输出:读东西给你听、在你远离桌面时找到你——这部分确实比屏幕更好,值得保留。
- 凡是涉及发送、花钱或与他人约定日程的操作,必须在通过前以文字形式用眼睛读过。
一句话总结他的教训:给你的代理一个声音用于输出,而绝不用于审批。语音是出色的叙述者,却是糟糕的审计员。 他也反复澄清,这不是对语音模型的批评,而是关于"一段平静自信的播报对一个人检查意愿的影响"的发现。每一次提速,你都在某处付出代价——而当代价藏在一个你听不出破绽的声音里时,你根本察觉不到自己正在支付。
相关推荐
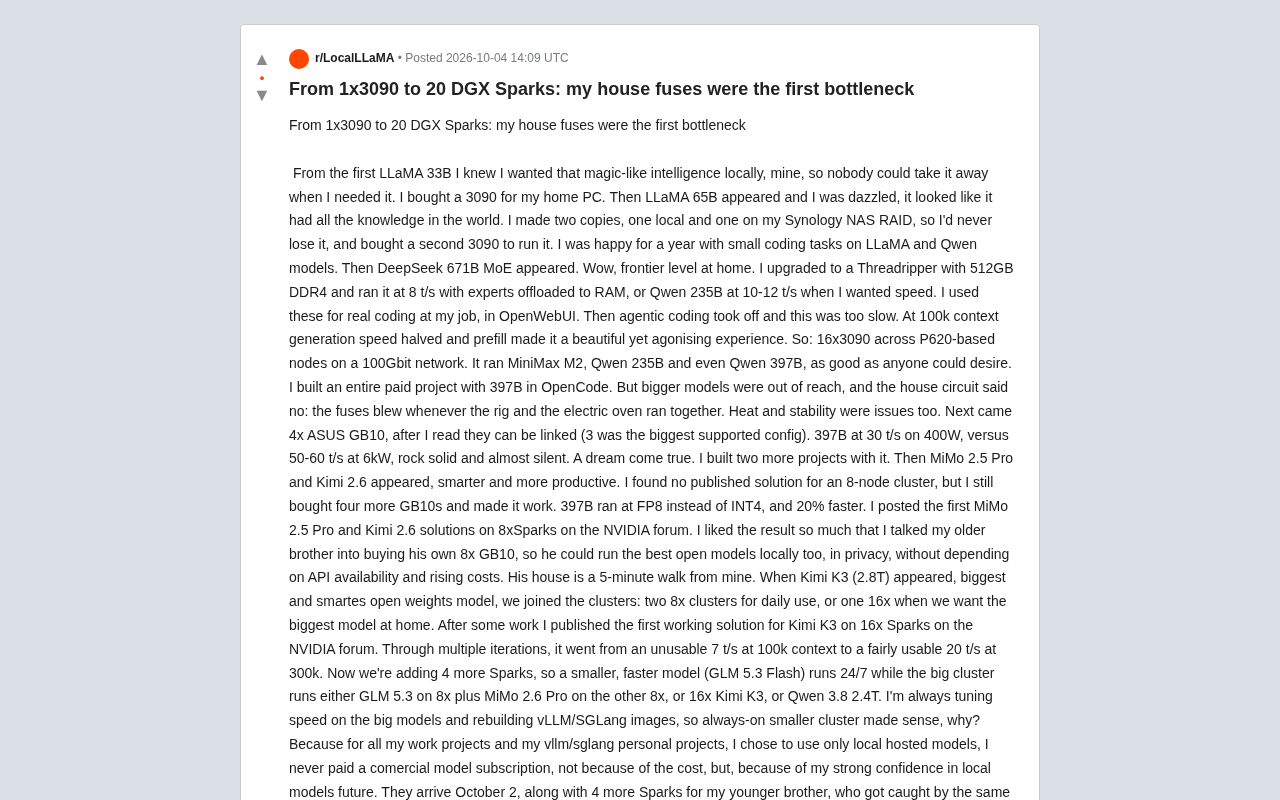
从1块3090到20台DGX Spark:本地大模型玩家的硬件进化史
一位Reddit用户记录了从单块RTX 3090到20台NVIDIA DGX Spark的本地大模型部署进化史,涵盖MoE内存卸载、多卡功耗瓶颈、保险丝跳闸,以及如何在家用集群上跑通Kimi K3等万亿参数开源模型。
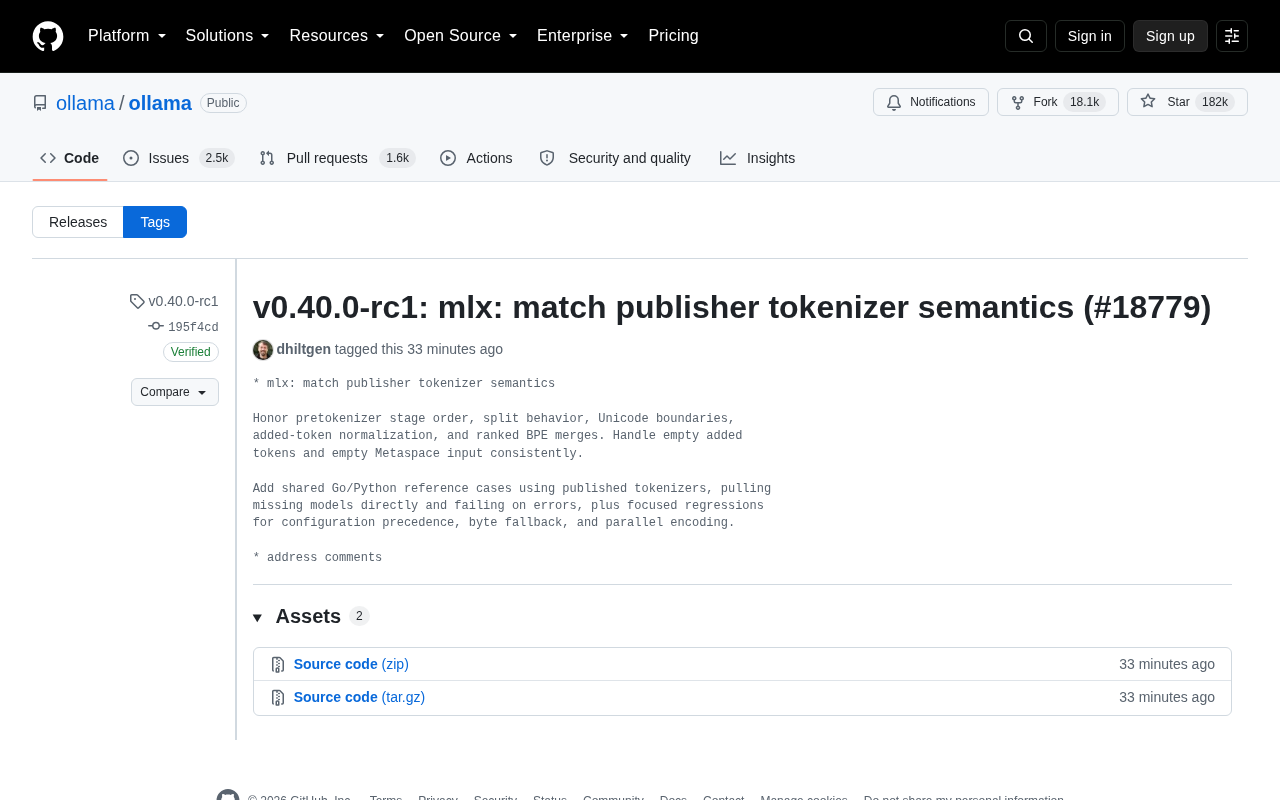
Ollama v0.40.0-rc1 发布:MLX 分词器对齐发布者语义
Ollama 发布 v0.40.0-rc1 预览版,核心更新为 MLX 后端分词器对齐发布者语义,涵盖预分词顺序、Unicode 边界、BPE 合并及跨语言测试保障,提升 Apple Silicon 本地推理一致性。
用 Langfuse 与 OTEL 在 Backstage 中实现 AI Agent 可观测性
一个开源 Backstage 插件,基于 OpenTelemetry 和 Langfuse 实现 AI Agent 可观测性,让团队在自托管开发者平台中集中管理和监控 Agent 集群。