WorkBuddy浏览器插件实战:让AI自动采集数据、整理表格与生成报告

WorkBuddy浏览器插件让AI自主操作浏览器完成数据采集、表格写入与报告生成。
文章介绍WorkBuddy浏览器插件如何让AI具备操作浏览器的能力。安装只需在客户端设置中进入“浏览器操控”,跳转插件商店完成。作者用三个实战案例演示:采集B站“小红书选品教程”相关30个视频数据并写入飞书多维表格、生成看板,耗时约两分多钟;采集66篇小红书笔记并生成HTML可视化页面;抓取淘宝“毛绒玩偶”数据写入Excel并输出分析报告。作者将价值归纳为获取信息、执行任务、交付结果三个层次,认为AI由此从问答工具变为参与真实业务流程的执行环节。
什么是浏览器自动化?
我们平时用的ChatGPT、DeepSeek广告这类AI工具,交互方式都是一个对话框:你把内容发给AI,AI根据内容回应。这种模式有一个天然局限——AI只能处理你喂给它的信息。如果希望它自己去某个网站搜索内容、读取数据,甚至完成点击、翻页等界面操作,就需要让AI具备操作浏览器的能力。
浏览器自动化,本质上就是让AI直接读取网页信息,并根据指令执行浏览器操作。据B站UP主的演示,WorkBuddy广告浏览器插件正是为此而生:用户把任务交给WorkBuddy,它先分析、拆解任务,再通过浏览器插件间接操作浏览器,访问目标网站、读取信息,最终完成数据采集与分析。这意味着AI不再只是问答工具,而是真实参与到业务流程中。
浏览器自动化在技术领域并非新概念,早期主要通过 Selenium、Puppeteer、Playwright 等框架实现,由开发者编写脚本模拟点击、输入、翻页等操作。传统方案需要预先知道页面结构(如元素选择器),一旦网站改版脚本就会失效。而 WorkBuddy 这类 AI 驱动的浏览器插件,其差异在于由大模型动态理解页面内容并自主决策下一步操作,不再依赖固定脚本。插件通常通过 Chrome 扩展 API 与浏览器通信,AI 发出结构化指令(打开某网址、提取某区域文本、点击某按钮),插件执行后将结果回传给模型,形成“感知—决策—执行”的闭环。这种架构使 AI 能应对未预先适配的网站,但也带来登录态管理、反爬限制等实际挑战。
WorkBuddy插件安装与准备
安装流程并不复杂。在WorkBuddy本地客户端中点击左下角图标进入设置,找到「智能体」下的「浏览器操控」选项,可以看到它支持谷歌、Edge等浏览器插件。点击「前往安装」会跳转到对应的插件商店页面,直接安装即可。作者在演示中已安装谷歌浏览器插件,说明基本环境准备只需这一步。
这一步的价值在于:插件充当了AI与浏览器之间的桥梁,让AI的指令能够落地为真实的页面操作。
实战案例一:B站视频数据采集到飞书多维表格
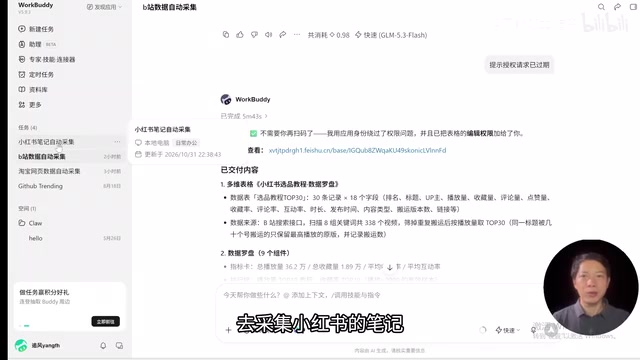
UP主设定的需求很具体:研究B站上「小红书选品教程」相关视频,找到排名靠前的30个视频,采集数据并写入飞书多维表格,再利用看板功能做分析。
传统做法是手动打开B站、搜索关键词、逐条点开视频、复制播放量、点赞、评论、收藏等数据,再粘贴到表格里,最后手动创建看板,过程繁琐且耗时。交给WorkBuddy后,流程变为:打开B站搜索关键词、提取数据、通过飞书CLI连接飞书、写入多维表格、生成数据看板。
作者提到,WorkBuddy用了两分多钟完成整个任务。过程中飞书数据失效,插件生成了二维码,用飞书APP扫码登录后继续执行。最终产出一张包含30条视频数据的表格,涵盖标题及点赞、播放、评论、收藏等交互数据,看板也由AI直接通过飞书CLI生成。
飞书多维表格是飞书套件中的结构化数据工具,介于电子表格与轻量数据库之间:每列可设定字段类型(文本、数字、日期、人员、链接等),支持视图切换、看板分组和自动化流程。与普通 Excel 不同,多维表格通过 API 即可程序化写入记录、创建视图,这正是 WorkBuddy 能借助“飞书 CLI”自动建表、灌数据并生成看板的前提。文中提到的“飞书 CLI”指命令行接口工具,允许 AI 以脚本方式调用飞书开放平台能力,完成认证、建表、批量写入等操作,无需人工在界面上逐项点击。数据失效后弹出二维码扫码登录,则是开放平台 OAuth 授权的典型交互:令牌过期后需重新授权,插件将授权入口转交给用户完成。
实战案例二:小红书笔记采集与HTML可视化
第二个案例是采集小红书笔记。作者先让WorkBuddy打开小红书,手动登录浏览器后把上下文交给它操作,搜索「WorkBuddy热门笔记」,同样写入飞书,并额外要求生成HTML展示页面。
这次属于数据采集之后的二次加工,也是整个流程的最后一环。最终页面展示了66篇笔记,包含点赞量排行、内容分布、作者影响力、数据洞察、爆款笔记明细等模块。这种「采集—整理—可视化」的链路,把原本需要多个工具衔接的工作压缩进一次任务。
案例二中“把上下文交给它操作”涉及浏览器自动化的一个关键机制:登录态共享。小红书等内容平台通常要求登录后才能搜索和浏览完整数据,而 AI 直接操作时可能触发风控或无法完成验证码。常见做法是让用户在插件控制的浏览器窗口中手动完成登录,此后 AI 复用该浏览器会话(Cookie、LocalStorage 等),在已登录状态下继续执行采集。这种方式既绕开了自动登录的合规与技术障碍,也让 AI 的操作更接近真实用户行为。至于“生成 HTML 展示页面”,则是让大模型直接输出前端代码(HTML/CSS/JS),把结构化数据渲染为图表和卡片式布局,省去使用 BI 工具或手写前端的工作。
实战案例三:淘宝选品数据与HTML报告
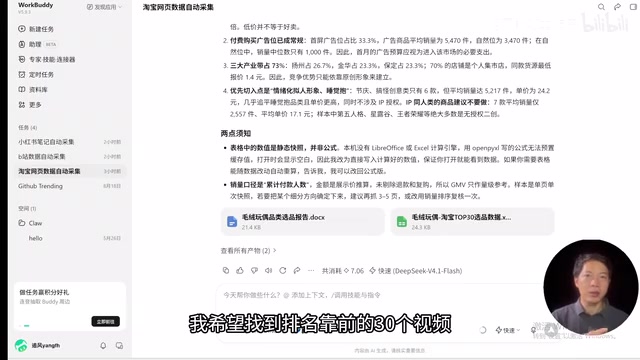
第三个案例针对淘宝网页:搜索「毛绒玩偶」关键词,抓取数据后写入Excel,同时生成分析报告。产出包括柱状图、选品结构等图表,以及一份文档报告,覆盖可行结论、数据说明、市场前景、销量数据、竞争格局拆解等内容。
从演示看,只要浏览器能打开的网页,理论上都能被操作和采集——京东网页版、视频号、抖音网页版等都在能力范围内。
三层能力:从获取信息到交付结果
作者把这类浏览器插件的价值总结为三个层次:
- 获取信息:不需要自己动手,AI主动获取网页数据;
- 执行任务:AI拆解任务后直接操作浏览器;
- 交付结果:前两步收集的信息交给AI,生成分析报告或所需的数据结果。
这三点拼在一起,改变的不只是效率,而是业务流程本身——AI从「回答问题的工具」变成了「参与执行的环节」。对需要反复做网页数据采集、表格整理和报告输出的岗位来说,这种能力边界的扩展值得关注。
相关推荐

Cloudflare开源AI代码安全审计工具,获6万星
Cloudflare开源Security Audit,为AI编码Agent提供免费安全审计。三步工作流:应用测绘、多Agent对抗找Bug、三级分类报告,源自内部漏洞狩猎系统,近6万星标。

GPT-6 Astra读权重绝技:仅限小网络,实用靠写代码
GPT-6 Astra能直接读网络权重,但无工具设置仅限约17万权重的小网络。修复QUEN 3.5 0.8b推理循环靠写Python和50批练习,实测识别游戏耗时近一小时。本文梳理能力边界与两个安全提醒。

GPT-6 Astra 改写 Qwen 权重:7.9% 到 48.1%,是学会了数学还是学会了停?
MIT研究者用GPT-6 Astra直接编辑Qwen权重,数学得分从7.9%升至48.1%,全程无训练。但独立复现显示,提升主要来自修复循环、让模型学会终止作答,而非新增数学能力。