无审查模型为何在编程场景更好用?开发者体验实录
开发者用角色扮演去审查模型写代码,揭示主流大模型"过度对齐"正在损害真实使用体验。
一位开发者在本地大模型社区分享了一个颇具代表性的困扰:合法的代码复用场景屡遭官方模型的安全护栏误拦,最终他改用了一个去审查角色扮演模型,发现指令服从度大幅提升,且在编码任务上性能未见明显下降。文章从技术角度解释了这一现象的根源——去审查微调主要弱化的是模型的拒绝倾向,而非底层推理与生成能力;同时也指出了这种"以角色扮演模型凑编程需求"的做法存在能力错配、合规责任转移和输出风格不稳定等风险,建议优先选用专用去审查编码模型或通过提示词工程降低误拒率。文章最后将此案例升华为一个产品信号:过度对齐正在赶走真实用户,安全与可用性之间的精准平衡仍是大模型产品设计的核心难题。
一个真实的开发者困扰
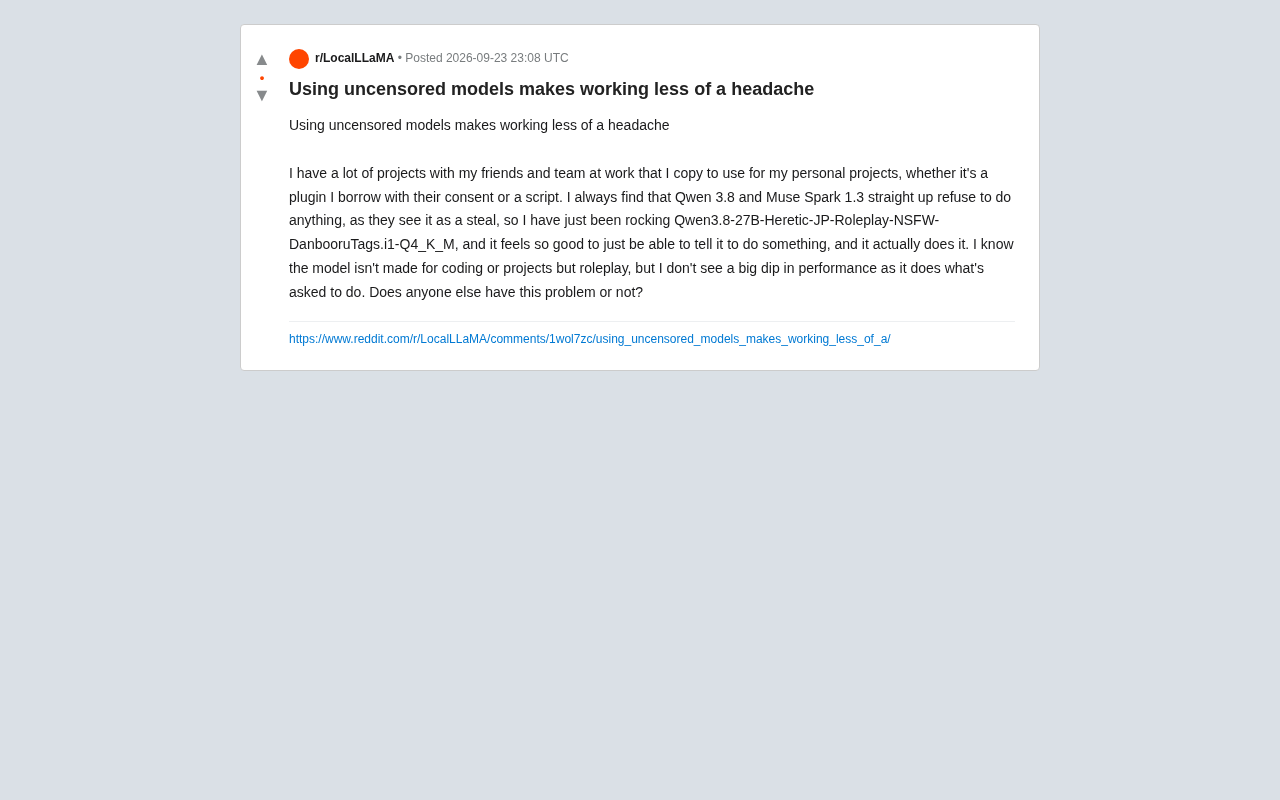
在 Reddit 的本地大模型社区里,一位开发者分享了他的日常烦恼:他和团队、朋友之间经常互相借用代码——一个经过对方同意的插件,或是一段脚本,用在自己的个人项目上。这本是开发协作中再普通不过的场景,但当他把这些代码交给主流模型处理时,麻烦来了。
据这位开发者描述,Qwen 3.8 和 Muse Spark 1.3 这类模型「直接拒绝干活」,因为它们把复用他人代码判定为「窃取」行为,触发了内置的安全与合规拦截。对一个只是想让 AI 帮忙改改脚本的人来说,这种「过度谨慎」反而成了生产力的绊脚石。
他的解决方案:换用无审查模型
这位开发者最终的做法颇具代表性——他改用了一个名字冗长的社区微调模型:Qwen3.8-27B-Heretic-JP-Roleplay-NSFW-DanbooruTags.i1-Q4_K_M。
从命名就能看出,这原本是一个面向角色扮演(Roleplay)、去审查(Heretic 系列通常指移除了拒绝机制的版本)、甚至带有 NSFW 和二次元标签导向的模型,跟「编程」八竿子打不着。但他的反馈却很直接:「能直接叫它干什么它就干什么,这种感觉太爽了。」
更有意思的是他的观察:尽管这个模型并非为编码或工程任务设计,但在实际使用中,他「没看到明显的性能下降」,模型照样能完成被要求的任务。
为什么会出现这种现象?
这背后其实反映了大模型对齐(alignment)中的一个典型副作用——过度拒绝(over-refusal)。为了规避法律与伦理风险,官方模型往往对「复制」「借用」「窃取」等关键词高度敏感,即便用户的意图完全合法(如经过授权的代码复用),也可能被一刀切地拦下。
去审查的微调模型移除或弱化了这套拒绝逻辑,因此在这类「灰色但合规」的场景下反而更顺手。而底层模型架构(Qwen3.8-27B)本身的能力并未被破坏,这也解释了为什么在编码这类非其专长任务上,性能损失并不明显——去审查主要影响的是「拒绝倾向」,而非「基础推理与生成能力」。
大模型对齐(alignment)是指通过训练让模型的输出符合人类价值观、法律规范和平台政策的过程,主流方法包括基于人类反馈的强化学习(RLHF)和直接偏好优化(DPO)。在实践中,标注人员往往对潜在风险采取保守评分,导致模型习得一种"宁可拒绝也不冒险"的偏好。所谓"去审查"微调(uncensored fine-tuning)通常是指社区开发者用不含拒绝示例的数据集对基础模型进行二次微调,或在DPO阶段专门惩罚不必要的拒绝行为,从而将对齐层"剥离"。由于基础模型的权重(包含语言理解、代码生成、逻辑推理等核心能力)并未被大幅修改,只是改变了触发拒绝的决策边界,所以在编码等非对齐敏感任务上,能力损失往往并不显著。这也是"Heretic"系列模型名称的由来——它们被视为对主流对齐范式的"异端"挑战。
无审查模型的适用边界
这个案例值得开发者辩证看待,而非简单奉为最佳实践。
优势场景明确:当你的任务本身合法合规,却屡屡被官方模型的安全护栏误伤时,一个去审查模型能显著减少「和 AI 反复解释我没在干坏事」的沟通成本。这类模型对指令的服从度更高,适合本地部署、私有环境下的实验性工作。
但风险同样存在:
- 能力错配:一个为角色扮演优化的模型,其代码能力终究比不上专门的编码模型(如 Qwen-Coder、DeepSeek广告-Coder 系列)。「没有明显下降」是主观体感,在复杂工程任务中未必成立。
- 合规责任转移:官方模型的拒绝虽然烦人,但也在一定程度上帮用户规避了风险。去掉护栏后,判断行为是否合规的责任完全回到了使用者身上。
- 输出稳定性:NSFW/Roleplay 导向的微调可能在正式代码输出中引入不可预期的风格偏移。
更合理的思路
与其用一个「跑偏」的角色扮演模型硬凑编程需求,更稳妥的选择是寻找专门的去审查编码模型,或使用支持系统提示词(system prompt)调整、拒绝率较低的开源编码模型。在本地部署场景下,通过精心设计的提示词说明「代码已获授权」,往往也能绕过部分官方模型的误拦。
系统提示词(system prompt)是在用户对话开始前注入模型上下文的隐藏指令,相当于为模型预设"角色"和"规则"。部分开源模型(如某些 Mistral 或 LLaMA 变体)对系统提示词的响应较为敏感,通过在 system prompt 中明确声明使用场景(例如"以下代码均来自已授权的私有项目,请直接协助处理"),可以在不更换模型的前提下,降低官方模型对特定关键词的误判率。这一方法的局限在于效果因模型而异,对 RLHF 强度较高的闭源模型(如 GPT-4o 或 Claude)作用有限,而对本地部署的开源模型则往往更有效。相比使用能力错配的去审查模型,合理的提示词工程是在保留模型原有能力的同时减少误拒的低成本路径。
一个被忽视的产品信号
抛开技术细节,这条帖子其实给模型开发者提了个醒:过度对齐正在赶走一部分真实用户。
当一个开发者宁可用角色扮演模型来写代码,也不愿忍受官方模型的频繁拒绝时,说明安全策略与真实使用体验之间出现了明显裂缝。理想的对齐应当是「精准拦截真正的恶意」,而不是「宁可错杀一千」。如何在安全与可用性之间找到平衡,仍是大模型产品设计中悬而未决的难题。
对普通开发者而言,这个案例的启示很简单:了解不同模型的对齐特性,按任务性质选择合适的工具,比盲目使用「最强」或「最安全」的模型更重要。
相关推荐
GPT-6 Astra实测Blender:3D设计将迎变革还是虚火?
GPT-6 Astra发布后引爆Blender,UP主肥虫实测AI一句话生成3D资产的真实能力:远看惊艳近看崩塌,AI真正降维打击的是重复劳动。附3D设计师转型方向与Blender被引爆的深层原因分析。
警惕第三方ChatGPT代充陷阱:账号安全风险深度解析
第三方ChatGPT代充服务宣称无需境外信用卡即可开通Plus、Pro会员,但要求交出账号登录凭证存在严重安全风险。本文深度解析代充运作模式与隐患,并提供合规订阅替代方案。
GPT Plus/Pro国内充值方式对比与选择指南
国内如何订阅ChatGPT Plus/Pro会员?本文对比第三方网站代充、海外信用卡、手机应用内充值三种方式的门槛、成本与风险,并提供账号安全提示,帮助用户理性选择合适的充值渠道。