无需AI也能聪明搜索:SQL模糊匹配实战指南

SQL原生模糊匹配函数Damerau-Levenshtein与Jaro-Winkler补齐AI之外的字面相似匹配能力。
微软Data Exposed节目介绍了SQL中不依赖AI的模糊字符串匹配能力。现实数据常含拼写错误、字符调换和地区差异,传统Soundex与Difference仅基于发音,无法处理字符调换。SQL正引入Damerau-Levenshtein编辑距离和Jaro-Winkler相似度:前者支持单次相邻字符换位,把form改为from只需一次操作;后者对共同前缀加权,契合用户开头输入正确的习惯。相似度分数由编辑距离与最大长度计算得出。实战中可设置最大距离参数提前终止计算,并组合姓名、邮编等多条件去重。选型上,精确匹配用等号或正则,字面相似用模糊匹配,语义相似则转向向量搜索。
在AI搜索和向量搜索大行其道的今天,微软Data Exposed节目却把目光投向了另一个常被忽视的领域:不依赖AI的模糊匹配。节目主持人Anna Hoffman与嘉宾Abhiman深入探讨了SQL中内置的模糊字符串匹配能力,以及如何利用它们构建更智能的搜索系统。
为什么需要模糊匹配?
现实世界的数据很少是完美的。拼写错误、漏字母、字符调换、不同地区的拼写差异(比如美式英语的color和英式英语的colour)比比皆是。Abhiman指出,即使开启了AI拼写检查,像把“from”误打成“form”这样的错误也未必能被纠正。
模糊匹配的核心是衡量两个词或两句话的相似程度,而非要求完全一致。它适用于多种场景:多系统间的客户数据去重、实体对齐、OCR识别纠错(比如把数字0识别成字母O)、以及AI模型读取数据时的质量校验。
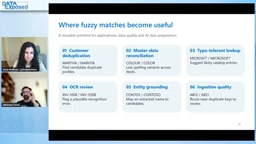
传统方案:Soundex与Difference
SQL中其实早有模糊匹配函数,比如Soundex和Difference。它们基于语音学原理工作:Soundex将单词转换为以首字母开头的编码,Difference则比较两个Soundex编码的差异,返回0到4的评分,4表示最相似。这套方案已经存在多年,适合处理发音相近的匹配需求。
但它的局限也很明显:只考虑发音,不考虑拼写结构。对于字符调换这类常见错误,Soundex无能为力。
Soundex 是最早的语音编码算法之一,由 Robert C. Russell 和 Margaret King Odell 于 1918 年发明,并随后在 20 世纪中叶被纳入美国人口普查的数据处理流程。其核心规则是保留单词首字母,将后续辅音字母按发音类别映射为数字(例如 b、f、p、v 归为同一类),并丢弃元音及 h、w、y 等字母,最终生成一个“字母+三位数字”的固定长度编码。因此 Robert 和 Rupert 会得到相同的 Soundex 编码 R163。Difference 函数则直接比较两个 Soundex 编码,返回 0 到 4 的整数评分,4 表示编码完全一致。这套机制对发音相近的姓名匹配非常有效,但完全忽略元音和拼写结构,对字符调换、漏字母等非语音错误无能为力。
新能力:Damerau-Levenshtein与Jaro-Winkler
微软正在将两种更强大的算法引入SQL,并计划在所有Microsoft SQL产品线上正式发布。
Damerau-Levenshtein编辑距离
该算法基于最优字符串对齐(OSA),计算将两个字符串变得相同所需的最少编辑次数。编辑操作包括插入、删除、替换和换位。
换位支持是关键优势。把“form”改成“from”只需一次换位操作,而普通Levenshtein距离需要两次编辑(删除再插入)。Abhiman特别强调,SQL实现的是受限版本,只支持单次相邻字符换位,因为完整算法需要消耗大量内存,在大型数据集上不切实际。
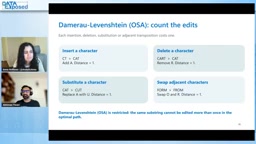
编辑距离(Levenshtein Distance)由苏联数学家 Vladimir Levenshtein 于 1965 年提出,定义为将一个字符串转换为另一个字符串所需的最少单字符编辑操作次数,操作包括插入、删除和替换。Frederick Damerau 随后在 1964 年的工作中引入了第四种操作——相邻字符换位(transposition),形成了 Damerau-Levenshtein 距离的雏形。完整的 Damerau-Levenshtein 算法允许任意次数的换位,但其动态规划实现需要维护更大的状态矩阵,在长字符串和大规模数据集上内存开销显著。SQL 产品中常采用受限版本,即最优字符串对齐(Optimal String Alignment, OSA),只允许每个字符最多参与一次换位且不相邻换位重叠,从而在保留主要实用价值的同时将内存复杂度控制在可接受范围。
Jaro-Winkler相似度
Jaro-Winkler同样衡量字符串相似度,但对共同前缀给予额外权重。当两个词的起始字符更匹配时,得分会更高。这符合直觉:用户通常开头输入正确,后面才出现错误。
Jaro 相似度由 William E. Winkler 在 1990 年代基于 Matthew Jaro 1989 年的工作扩展而来,最初用于美国人口普查局的姓名匹配。Jaro 相似度通过统计两个字符串中“匹配字符”的数量以及这些匹配字符之间的换位次数来计算得分,匹配窗口大小通常取两个字符串长度较大值的一半减一。Winkler 的改进在于引入前缀缩放因子:对两个字符串开头连续相同的字符给予额外加分,缩放因子通常设为 0.1,且前缀长度上限为 4 个字符。这使得 Jaro-Winkler 对“开头正确、尾部出错”的输入特别敏感,非常契合用户键入数据时的典型错误模式。其得分范围在 0 到 1 之间,1 表示完全一致,在姓名、地址等实体匹配任务中被广泛采用。
相似度分数怎么算?
对于Damerau-Levenshtein,相似度公式为:1 - 编辑距离 / 最大长度,再乘以100。编辑距离相同的情况下,短字符串的相对影响更大。例如,4个字符的字符串删掉1个字符,相似度为75;而6个字符的字符串删掉1个字符,相似度为83。
何时用哪种算法?
选择取决于你的需求:
- 需要知道具体编辑次数:用Damerau-Levenshtein编辑距离
- 字符对齐和前缀匹配是重要信号:用Jaro-Winkler
- 语音相似即可:用Soundex/Difference
- 语义相似但字面完全不同(如car和automobile):模糊匹配不适用,应使用向量搜索等语义搜索能力
你也可以组合使用,取长补短。
向量搜索与模糊匹配解决的是不同层次的问题。向量搜索将文本通过嵌入模型映射为高维向量,再基于余弦相似度或内积衡量语义接近程度,因此能识别 car 与 automobile、医生与医师这类字面迥异但含义相近的表达。模糊匹配则停留在字符层面,衡量的是拼写表面的接近程度,不具备语义理解能力。两者并非替代关系:在数据清洗流程中,可以先用模糊匹配处理拼写变体和 OCR 噪声,再用向量搜索完成语义层面的实体对齐与意图匹配。理解这一分工,有助于在架构设计时把合适的工具放到合适的环节,避免用模糊匹配去解决语义问题,也避免为简单的拼写纠错引入不必要的嵌入模型开销。
实战技巧:最大距离与容错查询
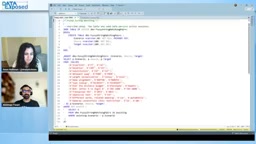
一个实用的优化是设置最大距离参数。如果只关心编辑距离在2以内的匹配,可以传入max distance=2。当实际距离超过阈值时,函数返回“max distance + 1”而非完整计算,从而节省处理开销,同时避免阈值边界上的模糊结果。
在去重场景中,可以组合多个条件。例如同时匹配姓名和邮编:先用模糊匹配筛选相似姓名,再限定邮编相同,最后要求相似度分数达到92以上才返回。这样Robert这类不匹配的记录就会被过滤掉。
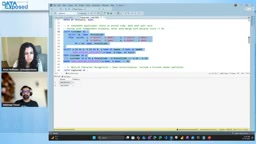
在OCR纠错场景中,把数字0和字母O的混淆考虑在内,设置编辑距离≤1的过滤条件,即可筛出可能的识别错误。在AI读取姓名并做验证时,可以设定相似度≥80才算通过。
能力选型速查
Abhiman最后给出了选型建议:
- 精确匹配:已知值,用等号;复杂模式用正则表达式
- 模糊匹配:拼写差异、字符调换、OCR错误等场景
- 语义搜索:当问题关乎“意思”而非“字面”时,转向向量搜索
模糊匹配不是要取代AI搜索,而是在AI之外补齐一块关键拼图。对于数据清洗、去重和容错查询这类高频需求,原生SQL函数往往是最直接、最高效的解法,且无需引入额外的AI基础设施。
相关推荐

Claude Mythos 5.2 与 Fable 5.2 错误率异常升高
Claude Mythos 5.2 和 Claude Fable 5.2 出现请求错误率异常升高,官方状态页已标记为调查中。本文梳理事件概况、对开发者的实际影响及应对建议。

ReAct运行时上下文裁剪:Claude Code为何70%就动手
深入解析ReAct运行时的上下文裁剪机制:为什么Claude Code在上下文使用约70%时就触发压缩,工具调用为何占用最多、为何必须成组丢弃,以及代码库为何不需要RAG。基于B站小福哥《分币不掏,学习AI Agent开发》第17节整理。

AI Agent vs LLM:Cursor和Claude Code如何真正工作
深入解析AI Agent与LLM的本质区别:LLM生成代码建议,Agent则通过工具调用修改文件、运行测试。以Spring Boot Bug修复为例,拆解Cursor和Claude Code的工作流、权限控制与验证机制。