无需代码,将现有API变成AI-Ready MCP服务器

用 OpenAPI 契约加一条命令,零代码把现有 API 变成 AI-Ready 的 MCP 服务器。
本文介绍 La Rebellion Labs 的 Roby 演示的一套方法:借助 Hoppy 命令行工具,只需一份 OpenAPI 契约和一条 serve 命令,即可将现有生产级 API 直接变成 MCP 服务器,无需重写代码或修改后端,认证与监控全部保留。dry-run 可预览工具定义与上下文开销,Headless 模式在现有后端前放置 MCP 端点。针对跨服务编排,Arazo 标准用声明式工作流替代模型即兴猜测;Capability Graph 则通过 capability、intent、planning facts 等元数据补充业务上下文,让模型在行动前先确认,并可在 CI 中审计知识缺口。
无需代码,将现有API变成AI-Ready MCP服务器
大多数团队认为,让AI Agent调用现有API需要重写一套服务器代码,或者手动为每个接口包装适配层,然后永远维护两份代码。La Rebellion Labs的Roby在演示中证明这条路径并非唯一选择——你已有的生产级API,加上一份OpenAPI契约和一条命令,就能直接变成MCP服务器。
更关键的是后续问题:当企业拥有23个服务、276个操作时,如何让模型不靠猜测来编排跨服务流程?答案藏在契约本身。
核心思路:契约即工具定义
演示从一个普通的OpenAPI 3.1契约开始——Orders API,包含查询订单、读取单条订单、追踪物流、取消订单四个操作。契约里没有任何AI相关的内容。
运行serve命令加上dry-run标志后,四个操作自动变成四个工具。只读操作被标记为read-only,取消操作被标记为destructive——这些安全提示直接来自HTTP方法本身。Roby特别提到,系统甚至能估算上下文开销:大约250个token。整个过程没有生成服务器代码,没有发起网络调用,只是把契约预览为工具列表。
这个dry-run机制的实际价值在于:它让开发者在正式启动之前,就能看到AI客户端将获得的完整工具定义,包括输入schema(来自路径参数)和安全提示(来自HTTP方法)。
MCP(Model Context Protocol) 是由 Anthropic 于 2024 年底提出并开源的协议,旨在标准化 AI 模型与外部工具、数据源之间的通信方式。在 MCP 出现之前,每接入一个新工具,开发者往往需要针对特定 AI 客户端(如 Claude、IDE 插件、自建 Agent 框架)单独编写适配代码,形成 N×M 的集成爆炸。MCP 用统一的服务端—客户端模型解决了这一问题:工具提供方只需暴露一个符合协议的端点,声明每个工具的名称、输入 schema 与调用方式,任何兼容的客户端即可自动发现并调用。本文中 Hoppy 生成的 MCP 服务器正是遵循这一协议,因此桌面助手、IDE Agent 与自建框架都能以相同方式接入,无需为每个客户端重复适配。
Headless模式:零侵入对接现有后端
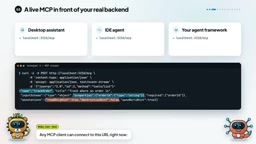
真正启动时,Headless模式在现有后端前面放置一个MCP端点。业务逻辑留在原地,工具调用被转发到已有API——认证、验证、监控全部继续生效。
从另一个终端查询该服务器,会得到标准的MCP响应。任何MCP客户端——桌面助手、IDE Agent、自建Agent框架——都可以连接到这个URL。
据YouTube频道La Rebellion Labs的演示,这一切由名为Hoppy的命令行工具驱动。
OpenAPI(原 Swagger) 是描述 RESTful API 的行业标准规范,当前广泛使用的 3.0/3.1 版本以 YAML 或 JSON 格式声明每个端点的路径、HTTP 方法、参数、请求体、响应结构与安全方案。它既是人类可读的文档,也是机器可解析的契约——代码生成器、测试工具、网关和文档站点都依赖它。本文的关键洞察在于:OpenAPI 契约中已经包含了构建 AI 工具所需的绝大部分信息——路径参数可映射为工具输入 schema,HTTP 方法(GET 只读、DELETE 破坏性)可映射为安全提示。因此无需另写一套“AI 描述”,只需将契约本身翻译为 MCP 工具定义,就实现了源信息单一、永不漂移的效果。
跨服务工作流:用契约替代模型猜测
真实企业的痛点在于API的碎片化:支付属于一个团队,物流属于另一个团队,各自独立部署、独立维护。每个API可以各自变成MCP服务器,但客户不会按服务边界思考。客户说的是“帮我扣款并发货”。
如果只暴露原始工具,模型必须自己发现三个系统之间的调用顺序,把前一个响应中的数据传递到下一个请求中,并且每次都祈祷不出错。这种不确定性正是幻觉的温床。
Arazo(OpenAPI Initiative的标准)用于描述跨API的工作流。演示中的Arazo 1.1文件直接引用三个契约,不做任何复制或修改。fulfillOrder工作流依次读取订单、用第一步响应中的总额发起支付、创建物流单。步骤间的数据流是声明式的,不是编码实现的。
同一个serve命令识别Arazo文档后,将每个工作流暴露为一个MCP工具。AI只需用订单ID调用fulfillOrder,Hoppy按序对三个独立服务执行三步操作并返回物流信息。编排逻辑存在于经过审查的契约中,而非模型的即兴发挥。
单步工作流的意义
演示中第二个工作流只有一个步骤。为什么要给单次调用套工作流?因为它让你用业务场景命名,而非用端点命名。“我的订单在哪”是客户真正会问的问题。该工作流接收这个场景所需的精确输入,调用一个操作,只返回状态和到达日期。
通过这种方式,你可以把复杂领域收窄为一个小而聚焦的MCP——不再暴露每个服务的每个端点,而是发布真正重要的少数业务能力,每个都为具体场景量身定制。
Arazo 是 OpenAPI Initiative 下正在推进的标准,用于以声明式方式描述跨多个 API 的工作流。传统做法中,若要让 AI 完成“扣款并发货”,往往需要写编排代码或依赖模型自行推断调用顺序,前者维护成本高,后者容易出错。Arazo 的思路是:在工作流文档中直接引用多个 OpenAPI 契约的操作,用声明式语法描述步骤之间的数据流(例如“用第一步响应中的 amount 作为第二步的支付金额”),而无需复制或修改被引用的契约。这样,编排逻辑就成了可审查、可版本化的一等公民,模型只需调用一个高层次的工作流工具,具体步骤由运行时按契约执行。
Capability Graph:让模型在行动前先提问
演示中最具启发的部分,是一个包含23个服务、276个操作的模拟批发后台。其中23个操作都叫“release”——释放订单、释放库存、释放账单冻结。如果全部交给模型,用户在说话之前就已消耗约16,000个token,然后模型还得猜用户说的是哪个release、调用它需要满足什么前置条件。
“模型没坏。它缺少你的业务有、但契约从未写下的上下文。”
Hoppy的Capability Graph在契约层面补上了这部分知识。在Orders API上添加几行可选扩展:
- capability:将操作放入业务分类体系
- intent:告诉模型何时使用、何时避免
- effects:声明取消是破坏性操作,需要确认
- planning facts:声明前置条件(已验证的客户、已识别的订单)和操作后的新事实
- client facts:声明身份验证由客服人员完成,而非API产生
- outcome:声明409响应意味着什么
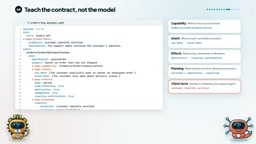
这些元数据不改变API本身,而是随契约一起被审查和版本管理。
审计与规划器
在模型接触之前,审计机制先验证词汇表的完整性:每个必需事实要么被某个操作产出,要么被声明为客户端验证;每个目标都可以实际到达。在CI中,缺口会像失败的测试一样阻断构建。
模拟取消操作时,没有已验证客户的情况下,规划器拒绝编造路径,而是声明“需要澄清”。验证客户后,得到一个确定性的两步计划:识别订单、取消订单。计划仍然停留在两道门——确认和破坏性操作检查——因为契约如此声明。规划器从不调用API,只决定下一步什么是安全的。
模型实际体验的变化
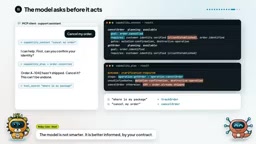
同一个服务器加上两个标志后,多了三个辅助工具。用户说“取消我的订单”时,模型调用capability context,获得相关工具、目标、前置条件、以及哪些事实需要从用户处获取。身份被标记为client-established,所以模型知道要问而不是假设。
然后模型请求计划。计划列出两个步骤、需要收集的确认、以及否则会怎样。如果订单已发货,409告诉模型取消不可能,于是模型重新规划而非重试。搜索行为同理——“我的包裹在哪”找到track order,“取消订单”找到cancel order。
“模型没变聪明。它是被你的契约更好地告知了。”
工作流也获得同样待遇。给fulfillOrder添加规划事实后,Hoppy对照它调用的三个操作进行检查。第一版草稿中,工作流忘了步骤需要已验证客户,且遗漏了两个产出的事实。严格模式让检查失败,错误无法到达生产环境。声明步骤真正的需求和产出后,检查通过。跨服务工作流现在拥有与单端点相同的保障。
规划事实(planning facts)与客户端事实(client facts) 是 Capability Graph 扩展中一对互补的元数据。规划事实描述某个操作的前置条件(例如“需要已验证的客户”)和操作后新产生的事实(例如“订单已取消”),让规划器能够判断一个目标在当前状态下是否可达。客户端事实则标记那些无法由 API 本身产生、必须由客户端或人工确认的信息(例如身份验证由客服人员完成)。二者结合,使规划器能在不调用 API 的情况下,对照契约检查缺口:若某个必需事实既无操作产出、也未被声明为客户端验证,审计就会失败。这正是让模型从“猜测”转向“提问”的机制基础。
零代码的意义
整个过程中没有创建任何适配器、处理器、提示模板。每个工具都可追溯到契约中的某一行,可以审查、版本化、diff。没有影子运行的东西——如果工具存在,契约声明了它;如果行为改变,是pull request改变了它。
这才是生产级API应得的标准,也是AI集成应该达到的标准。
Roby建议的第一步很务实:用dry-run跑一下自己的契约,看到工具列表;然后挑一个用户最容易误用的操作,给它加上intent。这是通向AI-Ready API的第一步,而API仍然属于你。
相关推荐

大厂AI工程化面试:前端监控到Agent全链路可观测性
从PerformanceObserver采集性能指标、onerror与unhandledrejection捕获异常,到RAG链路重排优化、上下文压缩控制token成本,再到对标LangSmith与Sentry的全站AI全链路可观测性体系设计,拆解大厂AI工程化面试的三层递进考点。

WorkBuddy保姆级教程:手把手搭建专属AI Agent工作助理
WorkBuddy保姆级教程:从豆包等聊天模型的局限讲起,手把手教你搭建专属AI Agent工作助理,实现本地文件批量处理与自动化操作,非程序员也能轻松上手。

Windows下用LangChain-Chatchat+DeepSeek搭建本地知识库
本文整理B站教程,详解Windows下用LangChain-Chatchat与DeepSeek搭建本地知识库的全流程,包括Anaconda环境配置、Ollama模型管理、镜像源加速及常见报错解决,助你快速实现RAG问答。