小米MiMo V2.6 Pro登顶开源第一:性价比之王的硬实力拆解
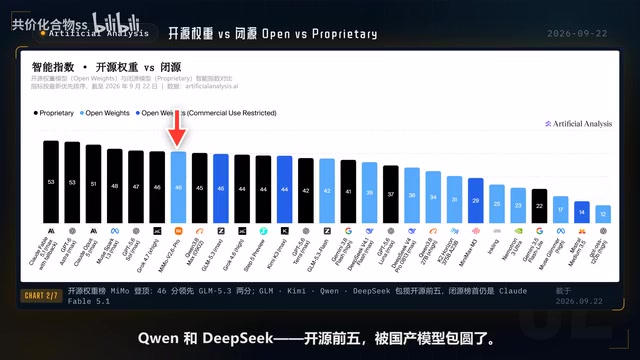
小米MiMo V2.6 Pro以MoE架构登顶开源榜,兼具旗舰级智能、极低推理成本与百万Token上下文。
小米MiMo V2.6 Pro在第三方评测平台Artificial Analysis的多项榜单上交出了亮眼成绩:综合智能榜46分排名第七,开源权重榜以2分优势高居第一,且开源榜前五均被国产模型包揽。更值得关注的是其性价比——单任务成本仅0.0026美元,约为Claude旗舰的1/38。在推理速度上,MiMo以每秒104.9 Token成为Pro旗舰中最快的选手,并提供100万Token的超长上下文窗口。这些优势的底层来源是其稀疏MoE架构:总参数4720亿,每次推理仅激活310亿,在保留大模型知识容量的同时大幅压缩计算开销。综合来看,雷军"开源第一"的说法在综合排行意义上有数据支撑,但长期稳定性和真实场景适配仍有待验证。
小米MiMo(视频中称"Memo")新模型的发布引发了不小的讨论。据B站UP主AI小童的分析,小米创始人雷军在微博宣称MiMo已成为开源模型第一名。这样的说法究竟是营销话术,还是有真实数据支撑?借助第三方评测平台Artificial Analysis的多个榜单,可以对MiMo V2.6 Pro的实际表现做一次相对客观的拆解。
综合榜单:首秀即挤进第一梯队
在Artificial Analysis的综合智能榜上,MiMo V2.6 Pro拿下46分,与Grok 4.7并列第六、第七位。这个成绩的含金量需要放在整体格局里看:排在第八、第九的GLM 5.3和Kimi K3都是44分,而榜首的Claude系列旗舰也不过55分。
换句话说,MiMo第一次冲进前十,就贴着第一梯队的尾巴,起点相当高。对于一款刚发布的模型而言,能在综合能力上直接对标各家旗舰,说明小米在模型训练层面的投入并非试水,而是奔着头部竞争去的。
开源权重榜:国产模型集体霸榜
把闭源模型剔除后,故事变得更有看点。MiMo V2.6 Pro以46分直接登顶开源权重榜,领先第二名GLM 5.3整整2分。紧随其后的是Kimi K3、通义千问广告(QN)和DeepSeek广告。
值得关注的是,开源榜前五被国产模型全部包揽。这一现象反映出国产大模型在开源生态中的整体崛起——不再是单点突破,而是形成了集团式的竞争优势。MiMo能在这样一个高手林立的赛道里拿下头名,含金量比单纯的分数更值得琢磨。
成本优势:旗舰分数,零头价格
如果说前面的排名是"面子",那么每任务成本这一项才是MiMo真正的"里子"。
据视频给出的数据,MiMo V2.6 Pro完成单个任务仅需0.0026美元。这是什么概念?Claude旗舰是它的38倍,Gemini 3.5 Ultra是4倍多,GPT-6要贵7倍多,连相对亲民的GPT-5.6也要比它贵上两三成。
把这一点放到"智能指数对成本"的散点图上会更直观:MiMo的坐标点位于横轴左侧(花钱最少的一批),纵轴却稳居前十。一边是竞品数十倍的单价,另一边是同一分数段的表现,"性价比之王"的说法并不夸张。对于需要大规模调用API的企业和开发者来说,这种成本差异会在实际部署中被成倍放大。
这里的"每任务成本"通常由评测平台依据标准化测试集中的平均输入/输出Token数与API定价折算得出,反映的是典型工作负载下的单次调用费用,而非极端场景下的峰值消耗。对企业用户而言,这一指标的意义往往超过排名本身:若日均调用量达到百万次,0.0026美元与0.1美元之间的差距会转化为数十倍的月度账单差异。需要注意的是,API定价随时可能调整,且不同服务商在限速、并发、SLA保障上的政策各异,实际部署决策还需综合考量这些隐性成本。
速度与上下文:旗舰里最快的选手
MiMo在推理速度上同样交出了亮眼答卷。
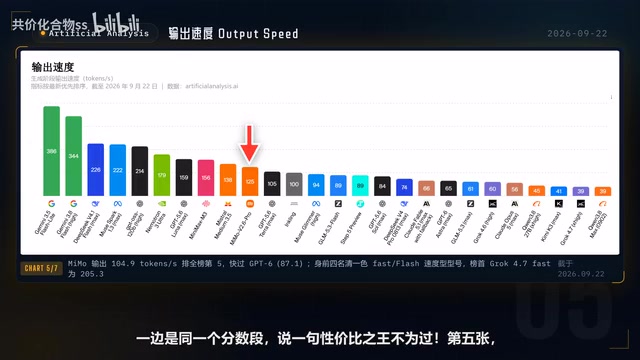
每秒输出104.9个Token,位列全榜第五,比GPT-6的87个还要快出一截。排在它前面的四名全是各家专门优化的Fast、Flash速度型选手。也就是说,在定位"Pro旗舰"的模型里,MiMo是最快的那一个——兼顾了能力与响应速度,而非以牺牲质量换取速度。
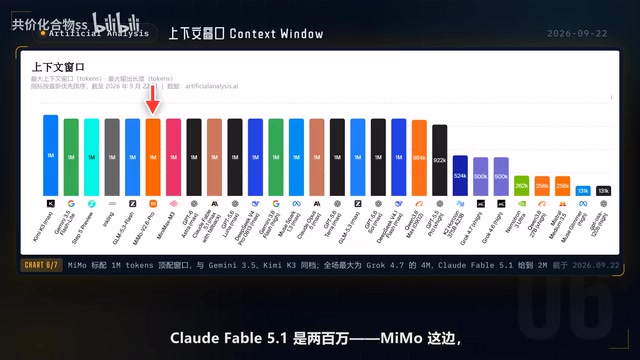
上下文窗口方面,MiMo直接给到100万Token的顶配规格,与Gemini 3.5、Kimi K3同处一个档位。全场最大的是Grok 4.7的400万,Claude系列旗舰为200万。虽然不是绝对最大,但100万Token已经足以覆盖绝大多数长文本处理场景,MiMo在这一维度上没有明显短板。
架构解读:MoE把钱花在刀刃上
从模型结构看,MiMo V2.6 Pro的总参数量为4720亿,但每次推理只激活310亿参数,是典型的稀疏MoE(混合专家)架构。
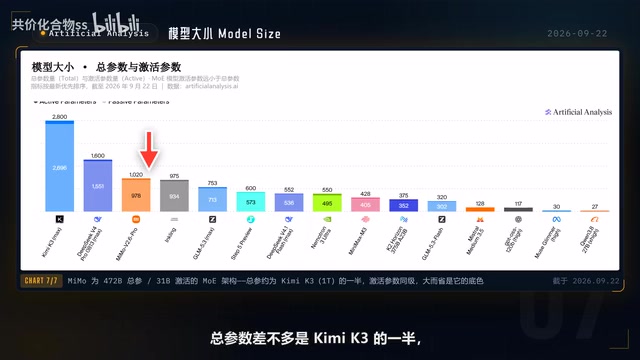
对比来看,它的总参数约为Kimi K3的一半,但激活参数却处在同一量级。这解释了前面成本与速度优势的技术来源:通过"大而稀疏"的设计,MiMo在保留大模型知识容量的同时,把每次推理的实际计算量压到很低。堆参数的同时控制激活规模,正是所谓"花钱花在刀刃上"的工程思路。
MoE(Mixture of Experts,混合专家)架构的核心思想是将模型拆分为多个"专家"子网络,每次推理时由一个轻量级的"门控网络"动态选择少数几个专家参与计算,而非激活全部参数。这与传统稠密模型(Dense Model)形成鲜明对比——后者每次前向传播都要调用所有参数。MoE的优势在于:模型可以积累远超单次推理所需的知识总量(大总参数),但实际计算开销只取决于被激活的那部分(小激活参数),从而在推理速度和成本上获得数量级的压缩。这一架构并非小米首创,OpenAI的GPT-4、Google的Gemini系列以及DeepSeek-V3均采用了类似设计。MiMo以310亿激活参数在旗舰级评测中拿下可比分数,说明其专家路由和训练策略经过了充分优化,而非单纯依靠堆砌总参数量来刷榜。
小结:雷军没有夸大其词
综合来看,MiMo V2.6 Pro在综合榜上位列第七、在开源榜上高居第一,单任务成本仅0.0026美元,速度还不拖后腿。从Artificial Analysis的多项数据交叉验证的结果看,雷军所说的"开源第一"在综合排行意义上确有依据。
当然,这些评测数据来自单一第三方平台,实际的使用体验、任务泛化能力、以及在具体业务场景中的稳定性,仍需更多用户和长期使用来验证。但至少从纸面数据出发,MiMo这次的表现足以让它进入开发者的备选清单。你会考虑上手这款模型吗?
相关推荐
Pop!_OS 全面禁用 AI 生成代码:开源项目的警觉信号
Linux 发行版 Pop!_OS 宣布在大部分代码库中禁用 AI 生成代码,引发开源社区讨论。本文解析禁令背后的许可证合规、代码质量与社区信任问题,以及对开发者和整个行业的启示。
《扩散模型原理》专著评析:兼顾数学严谨与直觉的入门佳作
Reddit 社区热议的扩散模型专著《The Principles of Diffusion Models》评析:兼顾数学严谨与直觉理解,免费开放全文,适合有基础深度学习背景的研究者与研究生学习扩散模型原理。
亚马逊回应数据中心争议:不再使用保密协议(NDA)
亚马逊AWS CEO回应数据中心建设争议,宣布不再使用保密协议(NDA)。本文解析数据中心社区反弹的深层原因及透明度承诺的意义。