小模型结构化输出翻车:为何它复制提示词标签而非Schema枚举值

小模型结构化输出易复制提示词标签而非枚举值,需真实调用测试与容错设计。
文章讲述了一位开发者使用廉价小模型(如 Gemini Flash)进行结构化输出时遇到的典型问题:模型将提示词中的自然语言标签“At risk”直接复制为输出,而非遵循 Schema 中定义的枚举值 `risk`,导致严格解析器丢弃整个响应。单元测试因使用人工合规输入而全部通过,暴露了测试盲区。作者分析了小模型注意力机制易被显眼标签吸引的原因,并提出三项解决方案:在提示词中紧邻标签放置枚举值、在解析器中归一化同义词、变更后运行真实模型边界测试。社区讨论进一步建议使用格式示例或函数调用等机制,强调小模型需额外工程努力来弥补格式控制局限。
问题浮现:一个让开发者浪费一天的“小”错误
最近在Reddit上,一位开发者分享了自己使用廉价小模型(如Gemini Flash)进行结构化输出时遇到的坑:提示词中用自然语言描述状态为“At risk”,但JSON字段要求枚举值risk。结果模型对每个条目都返回了“at risk”,导致严格解析器直接丢弃整个回复,页面一片空白。更令人沮丧的是,单元测试始终通过,因为测试用的解析器输入是人类写的合规值。只有用真实提示词调用真实模型,才能暴露出模型实际选择了哪个词。
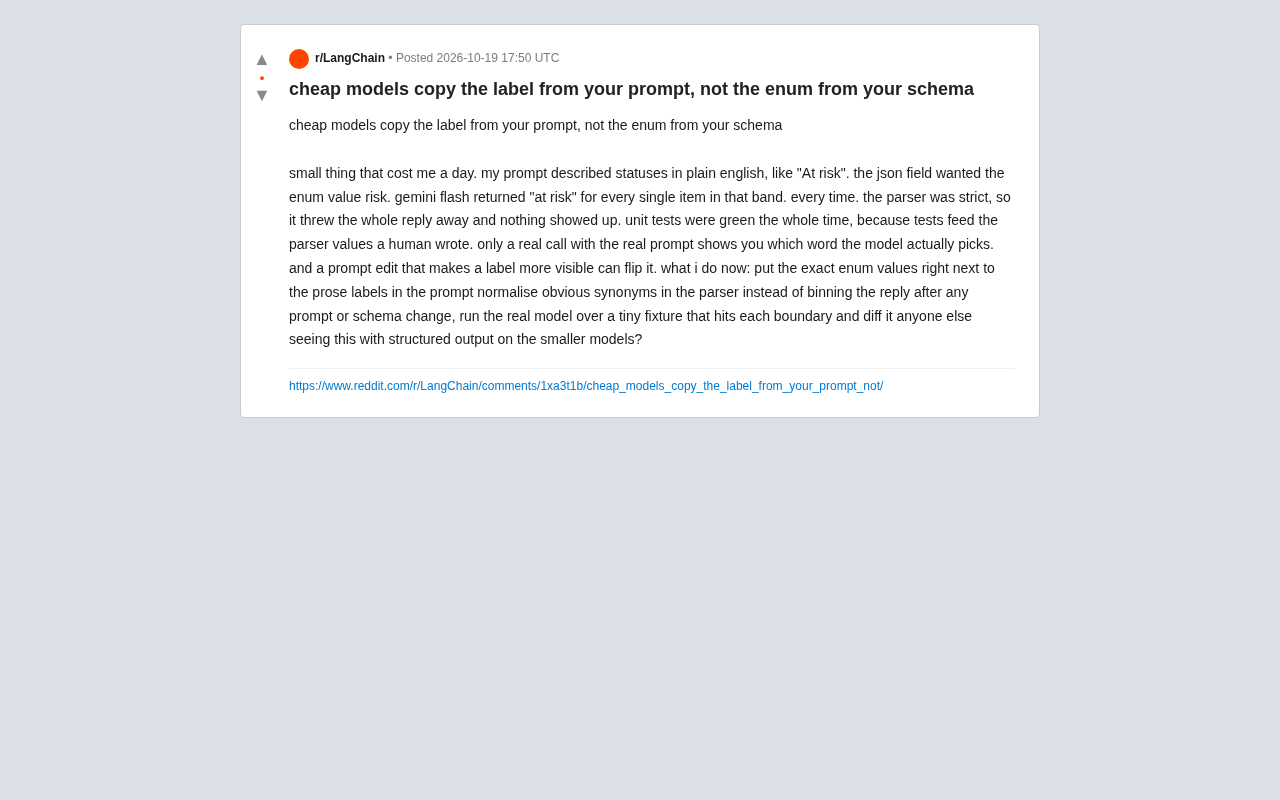
这个案例并非孤例。许多开发者在依赖小模型进行结构化数据提取时,都遭遇过类似问题:模型倾向于复制提示词中显眼的文字标签,而不是遵循Schema中定义的枚举值。这背后反映了小模型在指令遵循和格式控制上的固有局限性。
为什么小模型会“抄标签”而不是“用枚举”?
大语言模型在生成结构化输出时,需要同时处理语义理解和格式约束。对于参数量较小的模型,其注意力机制更容易被提示词中重复出现或位置显眼的自然语言标签吸引,而相对忽略Schema中冷冰冰的枚举定义。
开发者指出,提示词编辑也会影响模型选择——如果某个标签在提示词中更显眼,模型就可能翻转到那个词。这解释了为什么单纯调整提示词措辞会导致输出不稳定。小模型缺乏强鲁棒性,难以在多重约束下保持一致性。
测试盲区:单元测试为何全部通过?
传统单元测试通常使用人工构造的合规输入来验证解析器逻辑,但从未测试模型的实际输出。这就形成了一个盲区:解析器对人工输入工作正常,但对模型输出却可能完全失效。只有端到端的真实调用才能揭示问题。
结构化输出(Structured Output) 是指让大语言模型按照预定义的模式(如 JSON Schema)生成数据,而非自由文本。常见实现方式包括提示词约束、函数调用(function calling)以及专门的输出解析器(如 LangChain 的 Pydantic 解析器)。其核心挑战在于:模型需要在生成过程中同时满足语义正确性和格式合规性,而小模型由于参数容量有限,在多重约束下的指令遵循能力较弱,容易“走捷径”——直接复制提示词中高频出现的文本,而非严格查找 Schema 中的枚举定义。
枚举值(Enum) 在 JSON Schema 中用于限定字段只能取预定义的几个值,例如 {"risk": ["low", "medium", "high"]}。严格解析器在反序列化时会校验枚举值,一旦不匹配就抛出错误或丢弃整个响应。这种设计本意是保证数据质量,但在小模型场景下反而放大了格式偏差的后果。
端到端测试(End-to-End Testing) 在此类场景中至关重要,因为它覆盖了从提示词构造、模型调用到解析器处理的完整链路。传统单元测试只验证解析器对人工构造的合规输入的响应,属于“组件测试”,无法反映模型实际生成的内容。对于依赖非确定性模型输出的系统,建议引入“契约测试”思路:用真实模型调用生成一批样本,然后验证解析器能否正确处理这些样本,并将结果与预期枚举值对比。这能有效发现模型行为漂移和提示词敏感性。
实用解决方案:三招避免枚举值翻车
基于社区讨论和自身经验,这位开发者总结了三项有效措施,值得借鉴。
1. 在提示词中紧邻自然语言标签放置精确枚举值
不要只在Schema中定义枚举,而要在提示词描述状态时,同时给出枚举值。例如:“状态:At risk(对应枚举值:risk)”。这样模型在复制标签时,也有机会看到正确的枚举值。
提示词工程中的“邻近原则”:模型在生成时更倾向于参考距离当前生成位置较近的上下文。将枚举值与自然语言标签紧邻放置,可以降低模型在两者之间“犹豫”的概率。此外,使用明确的格式标记(如 [枚举值: risk])或结构化提示(如 XML 标签)能进一步强化约束。但需注意,过度堆砌枚举值可能增加提示词长度,对小模型的上下文窗口和注意力分配造成压力,因此应优先在关键字段上使用此技巧。
2. 在解析器中归一化明显同义词,而非直接丢弃
与其让解析器严格拒绝任何非枚举值,不如加入一层归一化逻辑,将“at risk”、“At Risk”等常见变体映射到risk。这能提高容错性,避免因模型微小偏差导致整个回复被丢弃。当然,归一化规则需要谨慎设计,避免误映射。
3. 变更后运行真实模型的小型边界测试并对比差异
任何提示词或Schema变更后,都应使用一个覆盖每个边界的微型测试集,调用真实模型并对比输出差异。这能及时捕捉模型行为变化,防止回归。开发者强调:“只有真实调用才能告诉你模型实际选了哪个词。”
社区共鸣与启示
该帖子引发了不少讨论,许多开发者表示遇到过类似问题,尤其是在使用较小模型处理结构化输出时。有人建议在提示词中使用明确的格式示例,也有人强调选择更强模型或使用函数调用(function calling)等机制来强制格式。
这一案例提醒我们,在依赖小模型进行结构化输出时,不能假设其会严格遵循Schema。必须通过真实调用测试、提示词优化和解析器容错来构建稳健的管道。对于成本敏感的场景,小模型仍有价值,但需要额外工程努力来弥补其局限性。
你在使用小模型时是否也遇到过类似问题?欢迎分享你的经验和解决方案。
函数调用(Function Calling) 是一种让模型输出结构化参数的原生机制,模型直接生成符合函数签名的 JSON,而非自由文本。相比提示词约束,函数调用通常由模型提供商在训练阶段进行专门优化,格式合规性更高。然而,小模型对函数调用的支持可能不完整或效果较差,且仍可能出现枚举值偏差。另一种方案是使用输出解析器(Output Parser) 结合重试机制:当解析失败时,自动将错误信息反馈给模型并请求重新生成,但会增加延迟和成本。
相关推荐

Workbuddy零基础入门:桌面AI智能体如何落地工作流
Workbuddy桌面AI智能体零基础教程解读:从安装、积分领取到文件管理与自动化工作流搭建,对比CodeX的适用场景与成本差异,帮助职场人完成从AI提问者到AI管理者的思维转变。

OpenAI智能体新栈:计算机操作、决策API与超速工作流
OpenAI Dev Day发布智能体新栈:Computer Use操作速度超越普通人,Decisions API基于Luna实现极低延迟分类,Agents API开放同源计算机操作能力,GPT-6.1 Sol成本仅为Astra七分之一。本文梳理核心更新、实测数据与开发者落地要点。

梁文峰开源推理框架DeepInfo,硬刚美国禁令
DeepSeek在开源模型后再开源推理框架DeepInfo,包含GPU/CPU交叉流水线、小模型预判大模型复核、华为昇腾与英伟达芯片全面适配等技术,直面美国联邦禁令。本文解析其对AI产业落地的意义与开源策略。