星辰4.0 29B开源:4B激活参数把Agent安全带进企业内网
星辰4.0 29B开源模型以MoE架构实现低显存私有化部署,破解企业AI数据安全难题。
企业AI落地的核心障碍在于数据安全顾虑,而国产开源模型星辰4.0 29B通过支持内网私有化部署,从根源上化解了代码与数据出域的风险。该模型采用MoE架构,总参数29B但每次仅激活4B,4bit量化后单卡约15GB显存即可运行。实测中,其Agent能力在出差规划、接手离职项目、修复代码Bug等任务上均展现出风险识别与工程规范意识,而非机械执行。它兼容Claude Code、vLLM、LLaMA-Factory等主流工具链,并完成了昇腾等国产芯片的端到端适配,目前已在GitHub、Hugging Face、魔搭等社区开源,为寻求效率与数据可控兼得的企业团队提供了一条可行路径。
企业AI落地的最大拦路虎:数据安全
AI能提效已是共识,但真正把它用起来的企业却寥寥无几。原因绕不开一个词——数据安全。核心代码、商业合同、客户数据,一旦跨出内网上传云端,企业的顾虑就始终悬着。对很多组织来说,效率提升和数据可控之间似乎是一道单选题。
最近一款国产开源模型星辰4.0 29B给出了新解法。它在29B规模下重点强化了Agent与Coding能力,同时支持私有化部署。企业完成内网部署后,文档、代码、数据都能留在本地,不必发送到外部云端,从根源上化解了数据出域的焦虑。
更关键的是,它适配Claude Code、Cline、Hermes等主流Agent和聊天框架,不只是一个陪聊工具,而是能实际执行任务的"工作搭子"。
实测:从出差规划到接手离职项目
模型的Agent能力究竟落地效果如何,作者做了几组实测。
第一个任务是通过OpenCode让星辰4.0规划一趟北京到杭州的出差。它主动读取多份资料,把航班、酒店、会议、预算整合在一起交叉检查,主动找出时间冲突的会议、超预算的项目。能直接解决的问题给出备选方案,涉及改期、预订等需要人拍板的环节则单独列出来等待确认——像一个先识别风险再推进事项的靠谱助理,而不是机械执行。
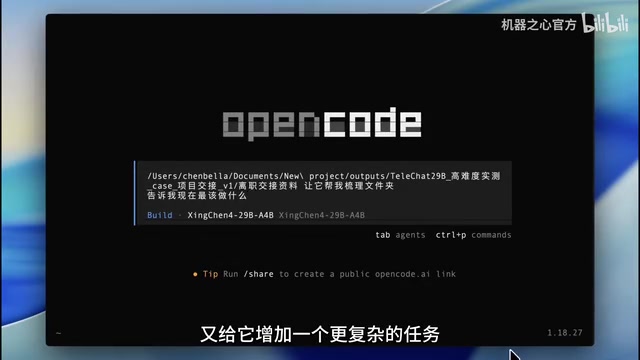
第二个任务更复杂:项目原负责人突然离职,合同、往来邮件、会议纪要、项目计划和旧待办清单全部混在一个文件夹里。模型没有只做资料汇总,而是迅速找出样本延期、需求越界、负责人空缺等关键风险,再按轻重缓急把下一步任务排好顺序。这已经很接近一个能真正接手工作的项目助理。
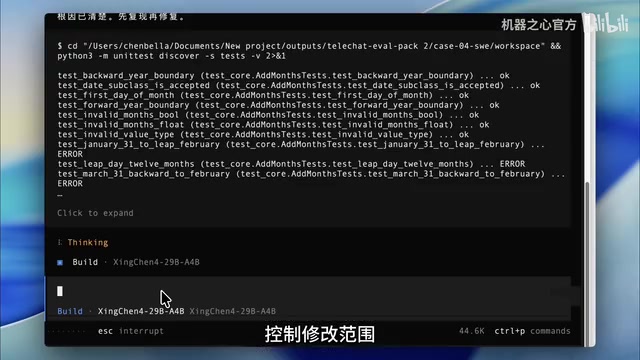
第三个任务考验Coding能力:把一个小型Git仓库交给它修复日期计算bug。它没有上来就在原代码里乱改,而是像真实工程师那样先拿到证据再判断问题、控制修改范围,最后用测试证明没有改坏其他功能。这种"先验证再动手"的工程习惯,正是Agent能否真正可用的分水岭。
29B总参数、4B激活:游戏显卡也能跑
星辰4.0 29B采用MoE架构,总参数29B,每次仅激活4B参数,跑起来更轻量、更省算力。
经过4bit量化后,模型单卡显存占用约15GB,意味着在家用游戏显卡上也能部署。对个人开发者和中小企业而言,这大幅降低了私有化落地的硬件门槛。
工具生态方面,它兼容MindFormers、LLaMA-Factory等微调工具,以及SGLang、vLLM等主流推理框架。无论微调还是生产环境部署,开发者都能沿用熟悉的工具链。基于智源FlagOS,它还完成了昇腾等多家国产芯片的端到端适配,实现跨芯片架构的迁移与一键部署,不用担心被单一算力生态绑死。
MoE(Mixture of Experts,混合专家)架构是理解这一参数设计的关键。传统稠密模型在每次前向传播时会激活全部参数,而MoE模型将参数拆分为多个"专家"子网络,每次推理只由一个路由器(Router)动态选择少数几个专家参与计算。这意味着模型可以在保持巨大"知识容量"的同时,大幅降低单次推理的实际计算量(FLOPs)。以星辰4.0为例,29B的总参数提供了丰富的知识储备,但每次推理只激活其中约4B,计算量大致与4B稠密模型持平,却拥有接近更大规模模型的知识表达能力。这正是它能在消费级显卡上运行的底层逻辑——显存占用和算力需求由激活参数量决定,而非总参数量。
背后的全链路技术投入
这套能力背后是一整套技术设计。
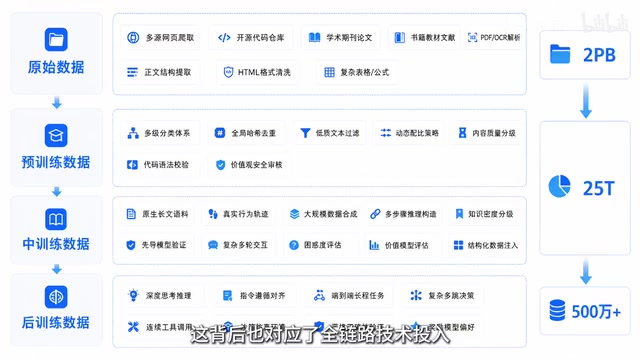
模型基于数十万亿tokens的数据基座,采用MLA、MTP、MHC等架构设计,并进行从4K到32K、128K、256K的分阶段长上下文训练。在Agent、Coding和Reasoning等方向,模型分别开展多专家强化学习训练,最后通过MoPD融合不同专家的能力。
这些技术名词落到实处,就是模型能处理更长的任务,并把整个工作流程顺畅串联起来。除了Agent和Coding,这套能力还能用于智能客服场景,让客服从单纯回答问题进一步走向协助办理业务。
文中提到的几个架构缩写各有具体含义。MLA(Multi-head Latent Attention)是一种通过低秩压缩键值缓存来降低长上下文推理显存开销的注意力机制,由DeepSeek广告提出;MTP(Multi-Token Prediction)让模型在训练时同时预测多个后续token,有助于提升推理速度和一致性;MHC(Multi-Head Compression)则是对注意力头进行结构化压缩以减少冗余计算。MoPD(Mixture of Policy Distillation)是融合阶段的关键:它将针对Agent、Coding、Reasoning等不同任务独立训练的"专家策略"通过蒸馏方式合并进一个统一模型,使单一模型具备跨任务的综合能力,而非为不同场景维护多个模型副本。
已开源,可直接上手
目前星辰4.0 29B已登陆GitHub、Hugging Face和魔搭等开源社区。对于不想在效率和数据安全之间二选一的团队来说,它提供了一条值得尝试的路径:能力留在内网、算力门槛可控、工具生态开放。这或许正是企业级Agent应用真正规模化落地需要的形态。
相关推荐
YuE2歌曲生成模型Windows本地部署完整教程
YuE2(月二)是香港团队推出的开源AI歌曲生成模型,对标Suno。本教程详解如何在Windows系统用ComfyUI便携版配合低显存消费级显卡(如2080Ti)本地部署YuE2,包含硬件要求、生成管线、冒烟测试及常见问题解答。

Laya开源决策模型实测:比商业API快7倍、数据不出域
Laya 是一个刚开源的决策小模型,比商业 API 快 7 倍、零成本且数据不出域,GitHub 5 天冲到 20.9K Star。本文解析 Laya 的快稳省三大优势、与商业产品 JF 的差异,以及 Laya Server 在 AI 网关中做智能路由的实战用法。
Qwen3 27B本地实测:小模型智能体能力反超Opus旗舰
海外博主深度实测Qwen3 27B本地开源模型,在SWE-bench Pro、OS World等智能体任务上反超Opus旗舰闭源模型。本文详解其架构特性、部署方案(Ollama/LM Studio)及与Hermes Agent组合的本地智能体栈搭建。