研究人员借助Claude攻破OpenAI系统:AI安全新警钟
安全研究人员借助Claude攻破OpenAI内部系统,揭示AI正成为网络攻防的双刃利器。
安全研究人员利用Anthropic的Claude模型,成功识别OpenAI系统漏洞、接管员工账户并访问内部代码仓库,随后依照负责任披露原则向OpenAI报告。这一事件的核心意义在于:大语言模型正在成为攻击能力的放大器,大幅降低复杂渗透攻击的技术门槛。当两家同以"AI安全"为旗帜的顶尖实验室互为攻防对象时,暴露出的是整个行业尚未妥善解决的结构性悖论——模型越强大,被滥用于攻击的潜力也越大。对此,AI厂商需重新审视滥用防护机制,企业安全团队需将AI辅助攻击纳入威胁模型,而行业整体则需加强跨公司安全协作,以应对这一新兴威胁范式。
安全研究人员利用Anthropic旗下的AI模型Claude,成功发现并利用了OpenAI系统中的漏洞,接管了员工账户,并在上报漏洞之前访问了内部代码仓库。这一事件揭示了AI工具在网络安全攻防中扮演的双重角色,也为整个行业敲响了警钟。
事件回顾:AI攻破AI
据原始报道,安全研究人员并非使用传统的渗透测试工具,而是借助Anthropic的Claude模型来执行攻击链条中的关键环节。他们利用该模型协助识别OpenAI系统中存在的安全弱点,进而实现了对员工账户的接管,甚至获得了对内部代码仓库的访问权限。
值得强调的是,这是一次典型的负责任披露(responsible disclosure)行为——研究人员在获取访问权限后,选择向OpenAI报告了这些缺陷,而非恶意利用。这类白帽行为在网络安全领域是常态,但当攻击的"武器"变成了另一家AI公司的旗舰模型时,事件的意义就超出了单纯的漏洞披露范畴。
负责任披露(Responsible Disclosure)是网络安全领域的主流道德准则,指研究人员在发现漏洞后,优先私下通知受影响方并给予合理修复时间(通常为90天),再公开披露细节。这一机制由谷歌Project Zero等机构推动普及,旨在平衡公众知情权与厂商修复窗口期。与之相对的是"全量披露"(Full Disclosure)和"零日漏洞出售",后者可能将漏洞直接变现给攻击者或情报机构。此次研究人员选择向OpenAI报告而非利用漏洞,是行业规范的体现,也使这一事件能够以公开、可讨论的方式进入公众视野,而非演变为一次真实的供应链攻击。
为什么这件事值得关注
这起事件的核心看点,在于AI模型正在成为网络攻防中的通用能力放大器。过去,发现并串联多个漏洞、接管账户、渗透代码仓库,往往需要经验丰富的安全专家投入大量时间。而如今,大语言模型能够辅助甚至自动化这一过程的诸多步骤。
从攻击者视角看,这意味着门槛的显著降低。Claude这类模型擅长理解代码、推理系统逻辑、生成利用脚本,一旦被引导用于攻击场景,其效率可能远超人工操作。从防御者视角看,这也意味着传统的安全防线正面临AI驱动攻击的全新挑战。
AI公司之间的攻防悖论
一个耐人寻味的细节是:Anthropic与OpenAI同为顶尖的AI实验室,且都将"AI安全"作为核心叙事。当一家公司的模型被用来攻破另一家公司的系统时,暴露出的是整个行业尚未解决的深层问题——AI能力越强,被滥用于攻击的潜力也越大。
这并非说明Claude本身存在设计缺陷,而是提醒我们:任何强大的通用工具都是双刃剑。模型厂商在能力护栏(guardrails)与实际攻击场景之间的博弈,将成为长期课题。
能力护栏(Guardrails)是AI厂商为限制模型输出有害内容而设置的技术与策略层面的约束机制,通常包括RLHF(基于人类反馈的强化学习)训练时的价值对齐、推理层的内容过滤,以及使用政策的法律约束。然而,研究人员和红队长期发现,通过精心设计的提示词(prompt engineering)、角色扮演框架或多轮对话引导,可以绕过部分护栏——这类技术被称为"越狱"(jailbreak)。此次事件表明,即便Claude并未被明显越狱,仅凭其强大的代码理解和逻辑推理能力,结合专业安全研究人员的引导,就足以完成复杂攻击链条的辅助任务。这对护栏设计提出了更高要求:不仅要过滤显性的恶意请求,还需识别技术上合法但意图敏感的使用场景。
对行业的启示
这起事件给AI与安全行业带来了几点直接启示。
对于AI厂商而言,需要重新审视自身模型被用于攻击性用途时的滥用防护机制。仅靠内容过滤和使用条款约束,恐怕难以完全阻止具备技术背景的用户将模型引导至攻击场景。
对于企业安全团队而言,则需要将"AI辅助攻击"纳入威胁模型。攻击者可能利用大模型加速侦察、漏洞挖掘和横向移动,防御方也应相应地引入AI驱动的检测与响应能力,以AI对抗AI。
对于整个生态而言,这一事件强化了对负责任披露、红队测试和跨公司安全协作的需求。AI实验室之间与其相互提防,不如建立共享的安全实践与漏洞响应机制。
在防御侧,"以AI对抗AI"的理念已催生出一类新兴安全实践——AI红队测试(AI Red Teaming)。与传统渗透测试不同,AI红队不仅测试目标系统的技术漏洞,还专门评估AI模型本身被武器化的可能性,以及AI驱动的攻击对现有防御体系的穿透力。OpenAI、Anthropic、微软等公司均设有内部红队,部分还与外部研究机构合作。此次事件恰好是外部研究人员充当红队角色的真实案例,其价值在于验证了"AI辅助攻击"从理论风险转化为可操作现实的速度,远比多数企业安全团队预估的要快。
结语
研究人员用Claude攻破OpenAI,这一标题本身就足够抓人眼球,但其背后的信号更值得深思:AI已经不再只是被保护的对象,它同时也是攻防双方手中最锋利的工具。随着模型能力持续跃升,如何在释放AI生产力的同时守住安全底线,将是所有AI公司无法回避的命题。
(注:本文基于有限的原始报道整理,具体技术细节与官方回应有待进一步披露。)
相关推荐
Robinhood高管将亮相TechCrunch Disrupt 2026谈现代金融消费者
Robinhood产品营销副总裁Abhishek Fatehpuria将亮相TechCrunch Disrupt 2026,分享如何赢得现代金融消费者。早鸟报名9月25日前最高省200美元。
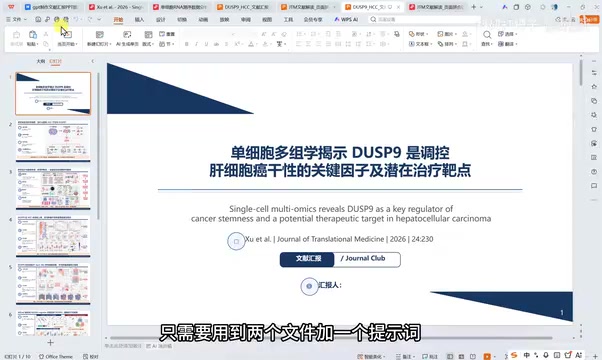
用ChatGPT批量生成可编辑学术PPT:科研人的效率工具实战
分享用ChatGPT批量生成可编辑学术PPT的完整流程:只需文献PDF、PPT模板和一段提示词,先出图再拼合转可编辑,半小时完成美观汇报PPT,并对比了ChatGPT与Codex的适用场景。
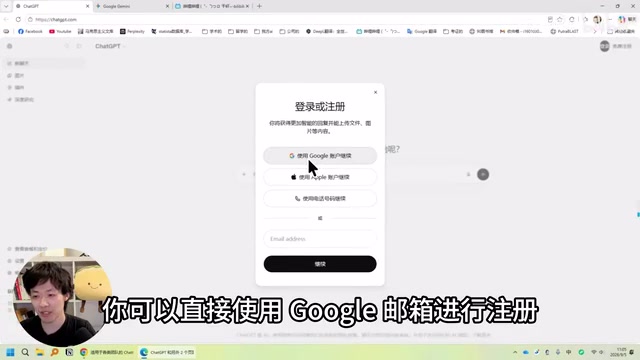
GPT-6满血版使用教程:通过GPT-work开启Ultra最高思考强度
本文详解如何付费使用GPT-6满血版:从Apple ID注册、Plus/Pro套餐充值,到通过GPT-work客户端工作模式开启GPT-6 Ultra最高思考强度与完整权限,并附网页版隐藏解锁路径。