一个提示词只干一件事:何时拆分已保存的Prompt

提示词拆分:识别超载信号,按输出单元重组,让一个提示词只干一件事。
保存的提示词越长越歪,往往是因为被不断塞入新任务,最终同时做多件事却每件都做不好。文章给出四个超载信号:输出流向不同下游系统、需要频繁删掉部分返回结果、出现"如果……"条件分支、格式要求互相冲突。判断出该拆后,可按四步操作:列出所有实际输出、为每个输出建立独立提示词、把共享上下文复制到两边、必要时用链式调用传递结果。拆分原则是共享的留下、专属的归位,能同时适用于两个提示词的指令就应出现在两边。但拆分并非越细越好,当两个输出共享大部分指令时不必拆,只有约束冲突或下游系统不同时,拆分收益才超过成本。
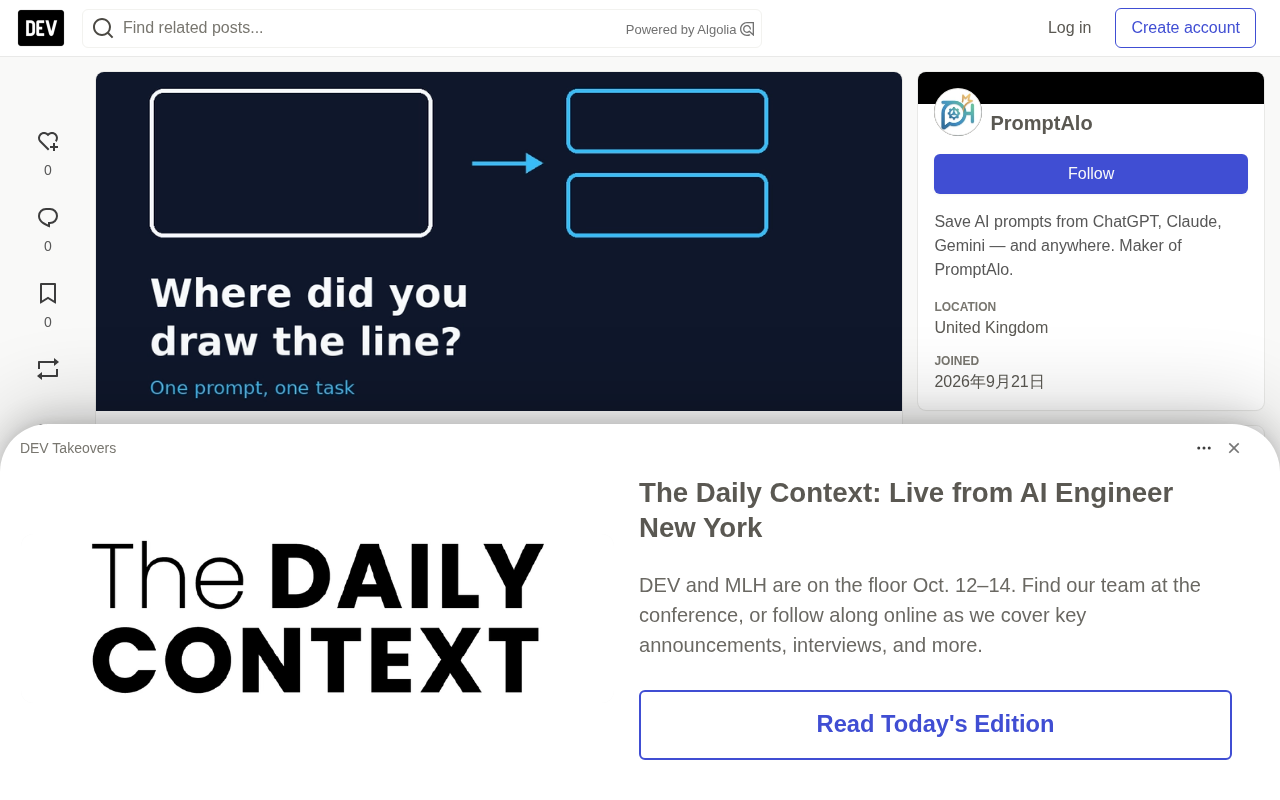
保存下来的提示词(Prompt)有个通病——越长越歪。一个专门用来起草客服回信的提示词,渐渐被塞进"判断邮件紧急程度"的要求,又加上了"推荐一篇帮助中心文章"的指令。每一次追加在当时都合情合理,但结果是:一个提示词同时做三件事,而每件事都做得不如从前好。
解决方向通常是拆分。真正的难点在于判断"什么时候该拆",以及"怎么拆才不丢上下文"。
提示词正在被过度复用的四个信号
判断一个提示词是否已经"超载",不必依赖直觉,观察输出即可。以下四个信号出现任意两个,基本可以确定它内部藏着不止一个任务:
- 输出内容流向不同的地方。 给客户的回复发到工单系统,紧急程度评分进入数据看板。两条信息的目的地不同,说明它们本就该由两个提示词分别产出。
- 你经常删掉返回结果的一部分。 如果你今天只需要回信正文,模型多给的评分和推荐文章就是纯噪音。需要手动"筛"输出,是任务耦合的直接证据。
- 提示词里出现"如果……"的指令。 "如果是退款请求,同时……"这类条件分支,往往就是藏在主提示词里的第二个提示词。
- 格式要求互相打架。 "温暖、口语化"与"返回 1 到 3 的评分"几乎不可能在一段回答里同时成立。当一个提示词同时要求自然语言和结构化评分,输出的两端通常都会打折扣。
这四个信号背后是同一个逻辑:不同的输出目标对应不同的约束条件,而约束条件之间会互相消耗。语气要求会挤压结构化输出的空间,格式规则会干扰自然表达。把冲突的约束塞进同一个提示词,模型只能折中,折中的结果就是两边都不满意。
拆分提示词的四步操作
拆分不是简单地"把长提示词切成两段",而是按输出单元重新组织。具体做法:
- 列出这个提示词实际产出的所有内容,一行一个输出。比如:回信正文、紧急度评分、推荐文章链接。
- 为每个输出建立独立提示词,只保留塑造该输出的指令。回信提示词只关心语气和信息完整性,评分提示词只关心判断标准。
- 把共享上下文复制到两边。 客户身份、产品功能、写作语气这些背景信息,在两个提示词里都要写一遍。少量重复比纠缠不清的提示词便宜得多——重复的代价是几行文字,纠缠的代价是持续的输出质量下降。
- 需要传递结果时用链式调用。 如果第二个任务依赖第一个的输出,先运行第一个,把结果粘贴进第二个,而不是硬塞进同一个提示词。
链式调用(Prompt Chaining) 指的是把一个复杂任务拆成多个提示词按顺序执行,前一个提示词的输出作为后一个提示词的输入,像流水线一样逐级传递。它与"一个提示词包打天下"的核心区别在于:每一步只面对一组约束条件,模型不必在同一次生成中同时满足语气、格式、评分标准等可能冲突的要求。常见的实现方式有两种:一是手动复制粘贴,把第一步的结果贴进第二步的提示词;二是在调用层用脚本或工作流工具自动串联,把上一步的返回值直接注入下一步的模板变量。设计链式调用时要特别注意错误传递——第一步的偏差会被后续步骤继承甚至放大,因此关键节点最好保留人工校验,或为每一步设定独立的验证标准。
拆分后,每一半保留什么、丢弃什么
拆分的原则可以概括为一句话:共享的留下,专属的归位。
每个拆分后的提示词保留三样东西:两者都需要的上下文、属于自己的格式规则、属于自己的边界限制。同时丢弃只对另一半有意义的所有指令。
这里有个实用的判断标准:如果某条指令在两个提示词里都说得通,它多半就该出现在两边。上下文信息通常属于这一类;而格式规则、输出长度限制、条件分支,往往只属于其中一个。
共享上下文(Shared Context) 是指在多个拆分后的提示词里都需要出现的背景信息,例如客户身份、产品功能说明、写作语气规范、术语表、输出语言等。它与"专属指令"的关键区别在于:上下文描述的是任务所处的环境,对多个输出都有约束力;而专属指令描述的是某一个输出的具体要求,只对它自己有效。判断一条信息是不是共享上下文,可以问:如果把它从某个提示词里删掉,那个输出会不会变得不可用或明显跑偏?会,就是共享上下文,需要在两边都写一遍。共享上下文的重复是可控成本——几行文字;但把它当成专属指令只放一边,另一边的输出就会因缺少背景而失准。
从工具视角看提示词拆分
提示词管理工具 PromptAlo 的开发者提供了一个有意思的启发式方法:如果你保存的提示词上,AI 自动生成的元数据标签没有抓住重点,那么提示词本身的措辞很可能也没抓住重点。
这个思路把"拆分判断"从纯经验问题变成了可观察的信号问题。当你给一个提示词打标签时,如果发现需要贴上三四个互不相关的标签才能描述它的功能,这本身就是该拆分的强烈提示。标签系统的价值在于让提示词的功能边界变得可见——一个功能清晰的提示词,应该能用一两个标签准确概括。
拆分的边界在哪里
拆分并非越细越好。过度拆分会带来两个新问题:上下文重复的成本累积,以及链式调用中错误逐级放大。
一条实用的分界线是:当两个输出共享大部分指令、只在末尾格式上略有差异时,不必拆分。只有当约束条件开始互相冲突、或者输出流向不同的下游系统时,拆分的收益才真正超过成本。
回到最初的问题——什么时候该把一个保存的提示词拆成两个?答案是:当你发现它正在为不同的目的服务,而这些目的对输出的要求彼此矛盾时。提示词不是越全能越好,一个任务对应一个提示词,往往比一个提示词包打天下更可靠。
相关推荐
Laya AI模型本地部署实测:35毫秒决策的智能体利器
Laya AI是一款非自回归决策模型,单次推理仅35毫秒,支持CPU/GPU本地运行。本文基于B站教程,详解Laya AI的安装步骤、客服路由代码实战与性能实测,并分析其在机器人、智能体等场景的适用性。
WorkBuddy蓝皮书:腾讯全场景AI办公工作台保姆级教程
基于B站高播放教程,系统拆解腾讯WorkBuddy全场景AI办公工作台的定位、安装流程与实战工作流,涵盖专家库、技能与连接器三层能力,附课程结构分析与适用人群判断。
WorkBuddy全功能深度解析:三大模式与企微集成实战
深度解析WorkBuddy三大任务模式、企业微信集成能力与外贸询盘、薪酬核算、定时任务等高价值场景,并客观评估其积分策略与生态绑定限制,为企业选型提供参考。