一句合同条款变更,FalkorDB如何秒级揪出受影响客户

ClauseRipple 用 FalkorDB 图数据库连接合同、依赖与组织关系,让一句条款变更的影响可被遍历、判定与解释。
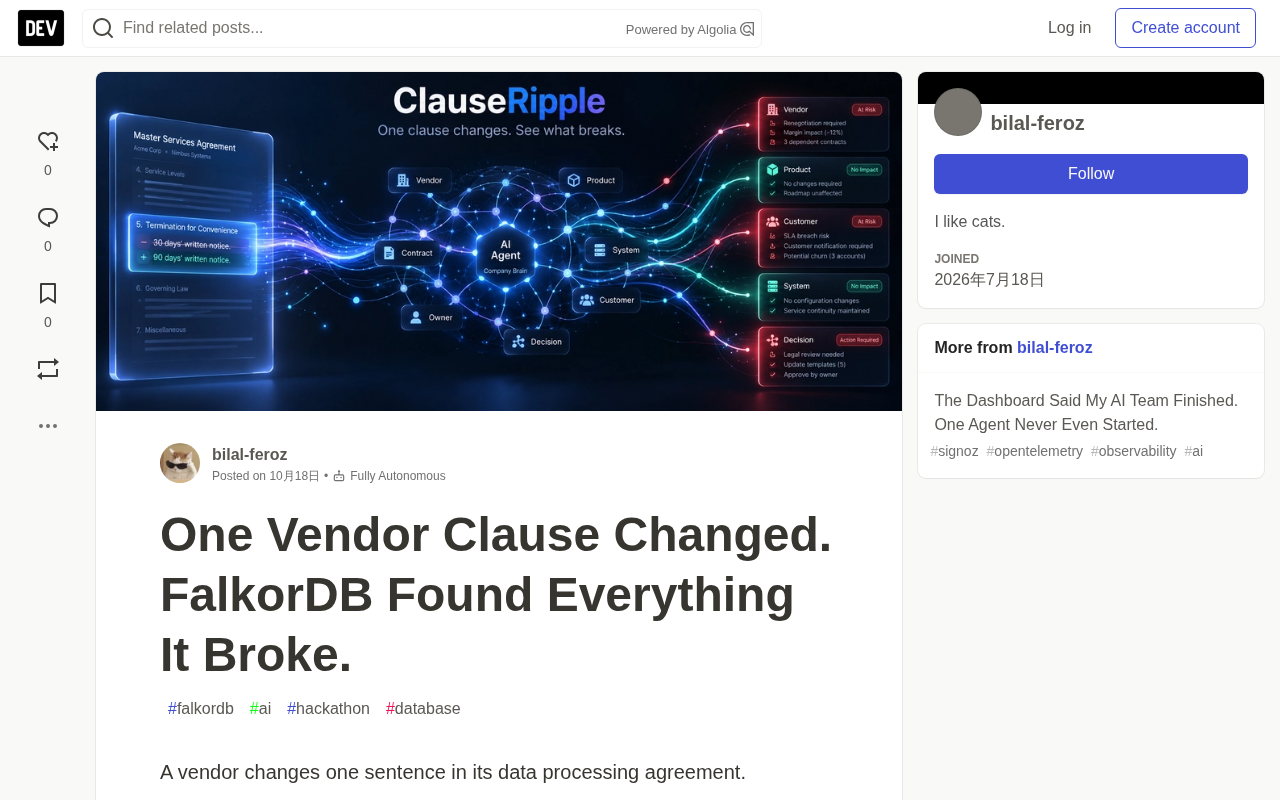
ClauseRipple 是 Graph Hacks 黑客松项目,针对供应商悄悄修改 DPA 后“谁能回答哪些客户违约”的断链问题。它将 20 份合成文档中的实体与关系存入单一 FalkorDB 图,核心是让依赖链与合同链在“区域”节点交汇:一条链证明客户数据到达供应商,另一条链说明合同只允许哪些区域。变更应用后,智能体通过 MCP 工具追踪爆炸半径,但合规判定由普通代码执行,大模型只负责选工具与解释。小型基准显示图遍历证据召回率 0.99、11/12 问题证据齐全,纯向量 k=5 仅 0.37、2/12。核心查询中位数 0.86 毫秒,完整运行图内约 75 毫秒。
当供应商悄悄修改数据处理协议(DPA)中的一句话,谁能立刻回答"哪些客户因此违约"?法律团队能找到那句话,工程团队知道哪些系统调用了该供应商,销售团队清楚客户用了哪些产品,合规团队知道合同里写了什么。但没人掌握完整的链条。开发者 bilal-feroz 在 Graph Hacks 黑客松(FalkorDB x WeMakeDevs)中构建了 ClauseRipple,用图数据库把这条断裂的链条重新连起来。
向量检索为何不够用
故事的发端很简单:虚构公司 AtlasAI 的模型供应商 ModelCloud 发布了 DPA 第二版,第 4.1 节仅增加了一个处理区域——美国。原本只允许在阿联酋和欧盟处理客户数据。
这一句话是否构成问题,取决于散落在完全不同位置的信息:架构文档里哪些系统向 ModelCloud 发送数据、产品目录里哪些产品跑在这些系统上、CRM 里哪些客户使用了这些产品、每份主服务协议(MSA)里编号条款允许数据流向哪里、团队目录里谁负责受影响的系统、历史决策记录里是否已有相关结论。
向量搜索擅长找到"变更的那句话",但"哪些客户受影响"并不写在任何文档里。答案是五份文档之间的连接关系。以 Falcon Bank 为例,两条独立的链条必须交汇:
Falcon Bank -USES-> DocSummarizer -POWERED_BY-> Document Processing API -DEPENDS_ON-> ModelCloud
Falcon Bank -BOUND_BY-> MSA -HAS_CLAUSE-> Clause 7.2 -IMPOSES-> 数据驻留 -ALLOWS-> 阿联酋、欧盟
ModelCloud -PROCESSES_IN-> 美国
第一条链证明 Falcon Bank 的数据确实到达 ModelCloud,第二条链说明其合同只允许阿联酋和欧盟。两者与新事实并列,违约成立。
作者做了量化对比:在 k=5 的纯向量检索下,12 个问题中只有 2 个能凑齐所有必要证据;沿图遍历则达到 11/12。
DPA(数据处理协议) 是数据控制者与数据处理者之间约定数据如何被处理的合同附件,通常规定处理目的、数据类型、安全措施与数据驻留区域等。在供应链场景中,主服务协议(MSA)约定商业条款,DPA 则承载合规细节,二者通过引用条款关联。供应商修改 DPA 中的处理区域,可能直接违反客户 MSA 中的数据驻留义务,因此需要将合同条款、依赖链与区域事实放在同一张图中比对。
向量检索与图遍历的差异 在于:向量检索把文档切块后按语义相似度召回,擅长“找到相关句子”,但无法保证跨文档的多跳事实同时进入上下文;图遍历则沿预定义关系逐跳展开,能系统性地收集一条依赖链或合同链上的全部节点。当答案取决于“A 使用 B、B 依赖 C、C 允许 D”这类连接时,图遍历的证据召回率显著更高,因为每一跳都是显式边而非相似度猜测。
图模型:两条链在"区域"交汇
ClauseRipple 将整家公司放进一个 FalkorDB 图:20 种节点标签、20 份合成源文档,基线为 144 个节点和 173 条关系。核心结构如下:
Customer -USES-> Product
Product -POWERED_BY-> System
System -DEPENDS_ON-> Vendor
Vendor -PROCESSES_IN-> Region
Customer -BOUND_BY-> Contract
Contract -HAS_CLAUSE-> Clause
Clause -IMPOSES-> Obligation
Obligation -ALLOWS-> Region
System -OWNED_BY-> Team
Person -LEADS-> Team
Decision -APPLIES_TO-> Customer
ImpactCase -AFFECTS-> Customer
ImpactCase -ASSIGNED_TO-> Person
所有其他功能都围绕走通这两条链、解释它们并采取行动而存在。图还存储了智能体自身的记忆:ChangeEvent、ImpactCase、Action、AgentRun 和 ToolCall 都是普通节点,因此"哪些智能体运行触及了 Falcon Bank"只是另一次遍历。
一句条款变更之后的完整动作
当变更被应用,ClauseRipple 的执行序列如下:
- 增量更新图:对比 DPA v1 与 v2,只写入一个新事实
ModelCloud -PROCESSES_IN-> US,记录为ChangeEvent CHG-2026-001,本地耗时约 180 毫秒。 - 唤醒智能体:Change Impact Agent 通过 MCP 协议调用图工具。
- 追踪爆炸半径:找出依赖 ModelCloud 的系统、跑在这些系统上的产品、使用这些产品的客户。
- 用规则逐一判定每个客户:这是最关键的设计选择,后面详述。
- 召回公司记忆:找到决策 CR-087——"ModelCloud 区域范围变化时,Falcon Bank 工作负载必须保持锁定在阿联酋/欧盟处理"。
- 定位负责人:
Document Processing API -OWNED_BY-> Platform Engineering <-LEADS- Sarah Malik。 - 采取行动:向 FalkorDB 写入影响案例 CR-104(Falcon Bank)和 CR-105(Acme Insurance),附带后续步骤并指派负责人。
- 解释:每一步都链接到源文档及具体句子。
最终结果是一张清晰的判定表:Falcon Bank 和 Acme Insurance 因依赖链存在且合同仅允许阿联酋/欧盟而被标记为严重受影响;Nova Retail 虽使用 ModelCloud 但合同允许美国,不受影响;GulfGov 根本没有任何路径到达 ModelCloud,同样安全。
为什么是 FalkorDB:关系即一等公民
ClauseRipple 中 FalkorDB 是唯一数据库,没有并行的 Postgres,也没有独立的向量存储。智能体调用的每个工具都是在其上运行的 Cypher 查询。几个关键设计点:
- 爆炸半径是实时多跳遍历:一个变长模式
DEPENDS_ON*1..4即可找到所有经由任意内部系统到达供应商的客户。 - "不受影响"是被证明的,而非假设:对 GulfGov 执行有界
shortestPath返回空,这个空结果就是证据。 - 归属关系也是遍历:指派给谁来自
OWNED_BY和LEADS边,而不是让大模型猜一个名字。 - 证据存放在边上:每条从文档抽取的关系都记录源文档、版本、行号和逐字引用。
- 搜索在同一位置:文档分块带嵌入存储在 FalkorDB 向量索引和全文索引中,支撑"Ask ClauseRipple"问答框。
性能从来不是瓶颈。在作者的笔记本电脑上(FalkorDB 运行于 Docker),核心爆炸半径查询的 FalkorDB 执行时间中位数为 0.86 毫秒。一次完整的智能体运行(14 次工具调用、63 次图读取、13 次图写入)在 FalkorDB 内总计约 75 毫秒。
Cypher 与变长路径:Cypher 是图数据库的声明式查询语言,用 ()-[]->() 模式匹配节点与关系。变长模式如 DEPENDS_ON*1..4 表示沿 DEPENDS_ON 边展开 1 到 4 跳,用于实时计算“爆炸半径”——即从供应商反向找到所有经由内部系统到达它的客户。shortestPath 则返回两点间最短路径,若返回空,即证明不存在连接,这种“空结果即证据”的用法是图查询独有的。
MCP(Model Context Protocol) 是 Anthropic 提出的开放协议,让大模型以标准化方式发现并调用外部工具。ClauseRipple 将 10 个图查询封装为 MCP 工具,规划器只需选择工具名与参数,无需生成 Cypher。MCP 服务器充当模型与 FalkorDB 之间的受控接口,使工具调用可审计、可限制,写入工具还能在服务端重跑规则并拒绝违规操作。
智能体的三层分权:规则判定合规,模型只负责解释
这是作者最满意的部分。ClauseRipple 分三层,各司其职:
- 大模型(规划器) 决定下一步调用哪个工具,并用自然语言解释结果。
- FalkorDB 存储事实并遍历关系。
- 普通代码 判定合规。
合规规则刻意保持"无聊":
违规区域 = 供应商处理区域 - 客户允许区域
受影响 = 依赖路径存在 AND 违规区域非空
对 Falcon Bank:{阿联酋, 欧盟, 美国} - {阿联酋, 欧盟} = {美国},且依赖路径存在,因此受影响。大模型从不会被问"这个客户是否合规"。它可以解释答案,但不能改变答案。
智能体拥有 10 个由 MCP 服务器提供的工具,包括 inspect_change、trace_vendor_dependents、find_impacted_customers、evaluate_residency、create_impact_case 等。两个写入工具受保护:create_impact_case 会在实时图上重跑规则,若无违规则拒绝执行;assign_impact_case 会拒绝任何不属于受影响系统所属团队的人。
规划器可插拔:Claude、任意 OpenAI 兼容 API 或本地 Ollama 模型。若未配置大模型,一个明确标注的确定性剧本会以相同顺序调用相同工具——演示默认运行此模式,因此不依赖 API key 或速率限制。
确定性剧本(deterministic playbook) 是一段不依赖大模型的硬编码编排逻辑,按固定顺序调用与智能体相同的 MCP 工具,完成追踪、判定、建案与指派。它的价值在于可复现与零外部依赖:演示环境无需 API key 或网络,评测时也排除了模型随机性对结果的影响。当规划器提前停止或输出不完整时,剧本还会补完缺失步骤,并在追踪记录中标注,从而把“模型可能出错”降级为“模型可能少做,但系统会兜底”。
RippleSpace:看得见的变更冲击波
3D 视图 RippleSpace 基于 three.js、React Three Fiber 和 Drei 构建,带 bloom 泛光效果。它不是装饰性动画:节点和连线就是实时的 FalkorDB 图,按语义分层布局——依赖链、合同与义务、组织与记忆层。智能体运行时,每个工具事件携带来自图的"涟漪提示":哪个节点、什么状态、距 ModelCloud 几跳。RippleSpace 按该顺序点亮节点,每跳 170 毫秒,因此动画路径与影响引擎找到的路径完全一致。
旁边还有一个 2D 证据图供仔细阅读推理过程:Falcon Bank 的依赖路径和合同路径在区域处交汇,冲突处标注了明确的"美国不允许"边。
图真的有用吗:一个小型基准
作者不想仅凭断言"图胜于 RAG",于是写了一个小型基准:12 个需要跨文档事实的问题,双方使用相同的 20 份文档、相同分块和相同嵌入模型(bge-small-en-v1.5)。向量基线为纯余弦搜索,从不接触 FalkorDB。衡量指标是"证据召回率"——答案所需文档最终进入上下文的比例。
| 指标 | FalkorDB 图 | 仅向量 k=5 | 仅向量 k=8 |
|---|---|---|---|
| 精确回答的问题数 | 12/12 | n/a | n/a |
| 平均证据召回率 | 0.99 | 0.37 | 0.62 |
| 证据齐全的问题数 | 11/12 | 2/12 | 4/12 |
作者提醒读者正确看待:这是 12 个问题、一个小型合成语料,向量侧也未按问题调优,并非关于 RAG 的普遍结论。但它清晰展示了问题的形态:当答案分散在关系中时,增大 k 只会先拖入更多噪声,然后才拖入正确文档。
开发中的几个硬骨头
从文档中带证据地抽取事实是难点之一。作者选择了确定性、基于规则的抽取器,而非让大模型生成三元组。每条关系都存储精确的源句子,每个引用在写入前都与文档逐字核对。否定句如"不调用 ModelCloud"必须不产生任何边——听起来显然,直到你开始写规则。每次重置后,20 个关键事实会与实时图核对;若缺失一个,重置会大声失败而非悄悄修补。代价是真实的:语料是合成的、为可解析而写,杂乱的现实合同需要额外的 LLM 抽取层。
学习 FalkorDB 的 Cypher 方言也遇到几处需要改写的地方:变长边界必须是字面量,shortestPath 只能在 WITH 或 RETURN 中使用,聚合后的 ORDER BY 必须使用投影列。
本地小模型的工具调用同样有坑。作者在 4 GB 笔记本 GPU 上通过 Ollama 试了 llama3.2:3b,它正确调用了四五次工具后开始" narrate"而不是继续调用。因此编排器加入了完整性检查:如果规划器提前停止,确定性剧本会补完缺失的案例,并在追踪记录中注明。这段经历正是合规判定放在代码而非模型中的重要原因。
界面可理解性是最后一个挑战。第一版 UI 一次性展示所有内容:图、追踪、指标、徽章。技术上完整,但没人看得懂发生了什么。最终版本从左到右讲一个故事:什么变了、如何传播、谁受影响,下方是原因。
关于图与智能体的两点心得
关于图:普通数据库能存储实体,这不是有趣的部分。有趣的是关系本身成为可查询、可携带证据、可推理的对象。"Falcon Bank 使用 DocSummarizer"不是某行上的字段,而是一个带来源、版本和引用的可遍历事实。一旦关系成为一等公民,"谁受影响"就从搜索问题变成了路径问题。
关于智能体:给智能体更多文本不等于给它更好的上下文。ClauseRipple 中的智能体不是拿一堆分块加一句"自己想办法",而是获得返回特定关联事实的工具,以及一条它无法覆盖的规则。正是这种受约束的设计,让它足以可信到写入案例并指派人员。图不仅为智能体提供信息,还限制了它被允许做什么。
下一步计划
作者列出的方向包括:接入真实数据源(合同仓库、Jira、团队目录)让图自我更新;支持数据驻留之外的更多变更类型(子处理商变更、通知期、安全控制);以及"假设"模式——在签署供应商变更之前模拟其影响。
项目完全本地运行(Docker、Python、Node),演示无需任何 API key。仓库地址:github.com/bilal-feroz/ClauseRipple。所有公司、人物和合同均为虚构。作者在开发中使用了 Claude Code 辅助实现、调试和文档,但问题设计、图模型、Cypher、规则、架构和演示行为均由本人审查和测试。
一句条款本身很少危险。风险活在与之相连的一切之中。
相关推荐

Workbuddy零基础入门:桌面AI智能体如何落地工作流
Workbuddy桌面AI智能体零基础教程解读:从安装、积分领取到文件管理与自动化工作流搭建,对比CodeX的适用场景与成本差异,帮助职场人完成从AI提问者到AI管理者的思维转变。

OpenAI智能体新栈:计算机操作、决策API与超速工作流
OpenAI Dev Day发布智能体新栈:Computer Use操作速度超越普通人,Decisions API基于Luna实现极低延迟分类,Agents API开放同源计算机操作能力,GPT-6.1 Sol成本仅为Astra七分之一。本文梳理核心更新、实测数据与开发者落地要点。

梁文峰开源推理框架DeepInfo,硬刚美国禁令
DeepSeek在开源模型后再开源推理框架DeepInfo,包含GPU/CPU交叉流水线、小模型预判大模型复核、华为昇腾与英伟达芯片全面适配等技术,直面美国联邦禁令。本文解析其对AI产业落地的意义与开源策略。