音频语言模型评估新方法:同类别对照揭示局部音频证据的真实影响
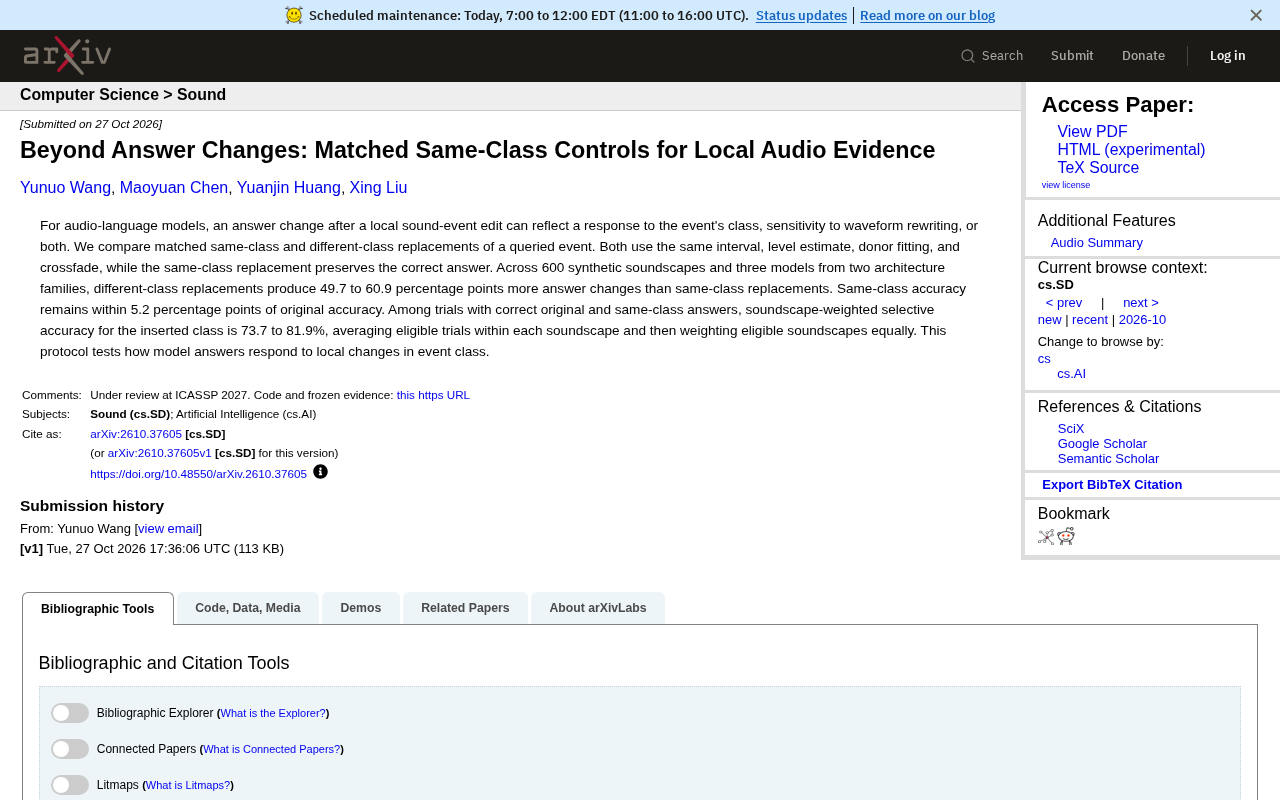
匹配同类别对照实验表明音频语言模型答案变化主要反映事件类别而非波形改写。
该研究针对音频语言模型在局部声音事件编辑后答案变化原因不明的问题,提出匹配同类别与不同类别替换的对照实验协议。实验覆盖600个合成声景和三个模型,结果显示不同类别替换引发的答案变化比同类别替换高出49.7至60.9个百分点,表明模型答案变化主要受事件类别驱动;同类别替换后准确率与原始准确率差距在5.2个百分点内,说明模型对波形改写具有较好鲁棒性。在原始和同类别答案均正确的试验中,声景加权选择性准确率为73.7%至81.9%。该协议为分离类别响应与波形敏感性提供了严谨工具,但限于合成声景和特定模型家族,未来需在真实录音和更多架构上验证。
音频语言模型(Audio-Language Models)在回答音频相关问题时,答案变化究竟反映了什么?一篇最新研究提出了“匹配同类别对照”的实验协议,旨在区分模型是对声音事件类别的真实响应,还是仅仅对波形改写的敏感。这项研究为音频模型的鲁棒性评估提供了更精细的工具。
问题背景:答案变化的多重解释
在音频语言模型中,对局部声音事件进行编辑后,模型答案发生变化可能有两种原因:一是模型正确识别了事件类别的改变;二是模型对波形本身的重写(如拼接、淡入淡出等操作)过于敏感,导致答案不稳定。传统评估方法往往只关注答案是否改变,却无法区分这两种情况。
该研究指出,这种模糊性会高估模型对语义内容的敏感度,或低估其鲁棒性。为了厘清这一点,作者设计了匹配的同类别与不同类别替换实验。
音频语言模型(Audio-Language Models) 是一类能够同时处理音频信号与自然语言指令的神经网络模型,通常通过大规模音频-文本对进行预训练,从而具备音频事件识别、音频描述生成、音频问答等能力。其典型架构包括音频编码器(如基于 Transformer 的声学特征提取器)和文本解码器,二者通过跨模态注意力或投影层对齐。与纯语音识别模型不同,音频语言模型需要理解环境声、音乐、语音等多种声音事件,并依据语言查询进行推理。因此,当输入音频被局部编辑后,模型答案的稳定性不仅取决于声学特征的鲁棒性,还取决于其是否真正将声音事件类别与语言语义正确绑定。
方法设计:同类别与不同类别对照
研究采用匹配对照设计:对查询到的声音事件进行替换时,分别使用同类别(same-class)和不同类别(different-class)的替代音频。两种替换在时间区间、电平估计、供体拟合和交叉淡化等处理上完全一致,唯一区别在于同类别替换保留了正确的答案。
这样,如果模型答案的变化仅仅源于波形改写,那么同类别和不同类别替换应产生相似的答案变化率;如果模型真正响应事件类别,则不同类别替换应导致显著更多的答案变化。
实验覆盖了600个合成声景(synthetic soundscapes)和来自两个架构家族的三个模型。通过这种控制变量法,研究者能够量化类别变化相对于波形改写的贡献。
合成声景(synthetic soundscapes) 指通过程序化方式将多个声音事件(如狗叫、汽车鸣笛、脚步声)按指定时间区间和电平混合生成的音频场景,而非真实环境录音。其优势在于研究者可以精确控制每个事件的出现时间、类别和信噪比,并方便地进行替换编辑。在音频语言模型评估中,合成声景常用于构造受控的问答对:给定一个查询(如“是否有狗叫声?”),模型需根据声景中是否存在对应事件作答。由于事件边界和混合参数已知,研究者能够对特定事件进行同类别或不同类别的替换,从而观察答案变化,这是真实录音难以实现的实验控制水平。
核心发现:不同类别替换引发更多答案变化
结果显示,不同类别替换产生的答案变化比同类别替换高出49.7到60.9个百分点。这一巨大差异表明,模型答案的变化主要受事件类别驱动,而非单纯的波形改写。同时,同类别替换后的准确率与原始准确率相差不超过5.2个百分点,说明模型对同类别替换具有较好的稳定性。
进一步分析中,研究者聚焦于原始答案和同类别答案均正确的试验,计算了声景加权选择性准确率(soundscape-weighted selective accuracy)。对于插入的类别,该准确率在73.7%到81.9%之间。计算方式为:先对每个声景内符合条件的试验取平均,再对符合条件的声景等权平均。这一指标反映了模型在正确回答基础上的选择性识别能力。
声景加权选择性准确率(soundscape-weighted selective accuracy) 是一种针对多声景、多试验设计的评估指标,用于衡量模型在“有资格”的试验子集上的正确率。具体而言,研究者先筛选出原始答案和同类别替换后答案均正确的试验,再对每个声景内这些试验的准确率取平均,最后对所有符合条件的声景等权平均。这种加权方式避免了试验数量多的声景主导整体指标,使每个声景的贡献相同。该指标反映了模型在已正确识别原始事件的基础上,面对同类别替换时仍能保持正确选择的能力,数值越高说明模型对波形改写越不敏感,对类别语义的依赖越强。
意义与局限
该协议为音频语言模型的评估提供了更严谨的框架,能够分离类别响应与波形敏感性的影响。不过,研究也限于合成声景和特定模型家族,未来需在真实录音和更多架构上验证。此外,同类别准确率的小幅下降(5.2个百分点内)提示波形改写仍有一定影响,但远小于类别变化的作用。
总体而言,这项研究强调了对局部音频证据进行匹配对照的重要性,为构建更可靠的音频理解评估标准迈出了一步。
相关推荐
VCP V工程实测:Token缓存95%命中,AI控制AI螺旋编程
VCP V工程实测:单轮对话Token缓存命中率95%以上,用AI控制AI实现螺旋编程,主控Agent策划、施工Agent写码,已策划工程可完全脱手。附完整配置步骤与局限分析。
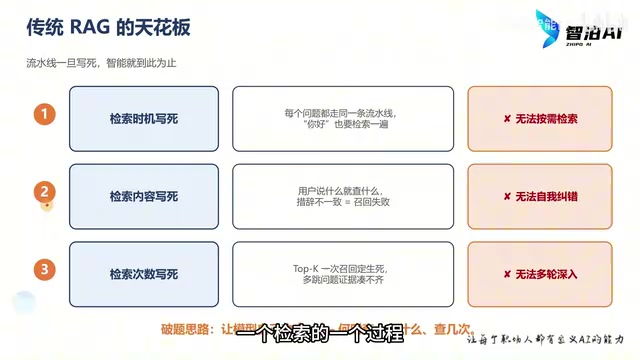
Agentic RAG实战:从原理到代码,手把手搭建智能检索系统
传统RAG检索时机、内容、次数全部写死,导致答非所问。本文基于B站教程拆解Agentic RAG原理:将检索封装为工具交给大模型自主决策,附四工具设计与完整代码实现,手把手搭建能自我纠错、多跳查询的智能检索系统。
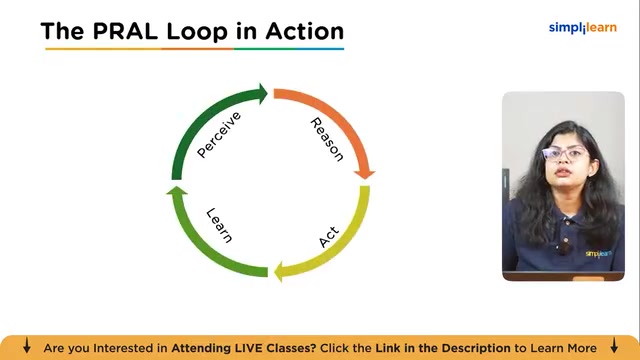
1小时搞懂Agentic AI:架构、设计模式与实战搭建
Simplilearn的Agentic AI速成课程解析:智能体三层架构(感知、认知、动作)、单智能体与多智能体对比、感知推理执行学习循环、三种设计模式,以及研究智能体、应用构建和反馈修复循环的实战演示。