英伟达 Mission Control 2.5:Kubernetes 自治恢复新进展

英伟达 Mission Control 2.5 将 GPU 集群的故障发现与处置推向自治恢复。
文章围绕英伟达 Mission Control 2.5 展开,讨论大规模 GPU 训练为何需要自治恢复。在数千卡规模下,硬件故障与网络抖动成为常态,传统依赖人工巡检和脚本重试的方式会导致大量算力空转。Mission Control 2.5 以 Kubernetes 为编排底座,把监控与自动化内建到系统中,弥补 Kubernetes 对 GPU 硬件故障语义理解不足的短板,使恢复动作能针对真实根因而非笼统重建 Pod。自治恢复的核心价值在于把"灰色故障"的定位与处置标准化,让运维重心从救火转向制定恢复策略。文章最后指出,这一方向要求细粒度的信号采集与可审计的恢复动作,标志 GPU 集群运维正向云原生范式收敛,集群弹性已成为必选项。
大规模 GPU 训练为何需要"自治恢复"
在成千上万块 GPU 上训练大模型,是一项高风险操作。硬件故障、网络抖动、驱动异常在如此规模的集群中不再是"偶发事件",而是常态。英伟达在开发者博客中给出的判断很直接:监控与自动化必须内建到系统中,才能优化集群的弹性(cluster resiliency)。
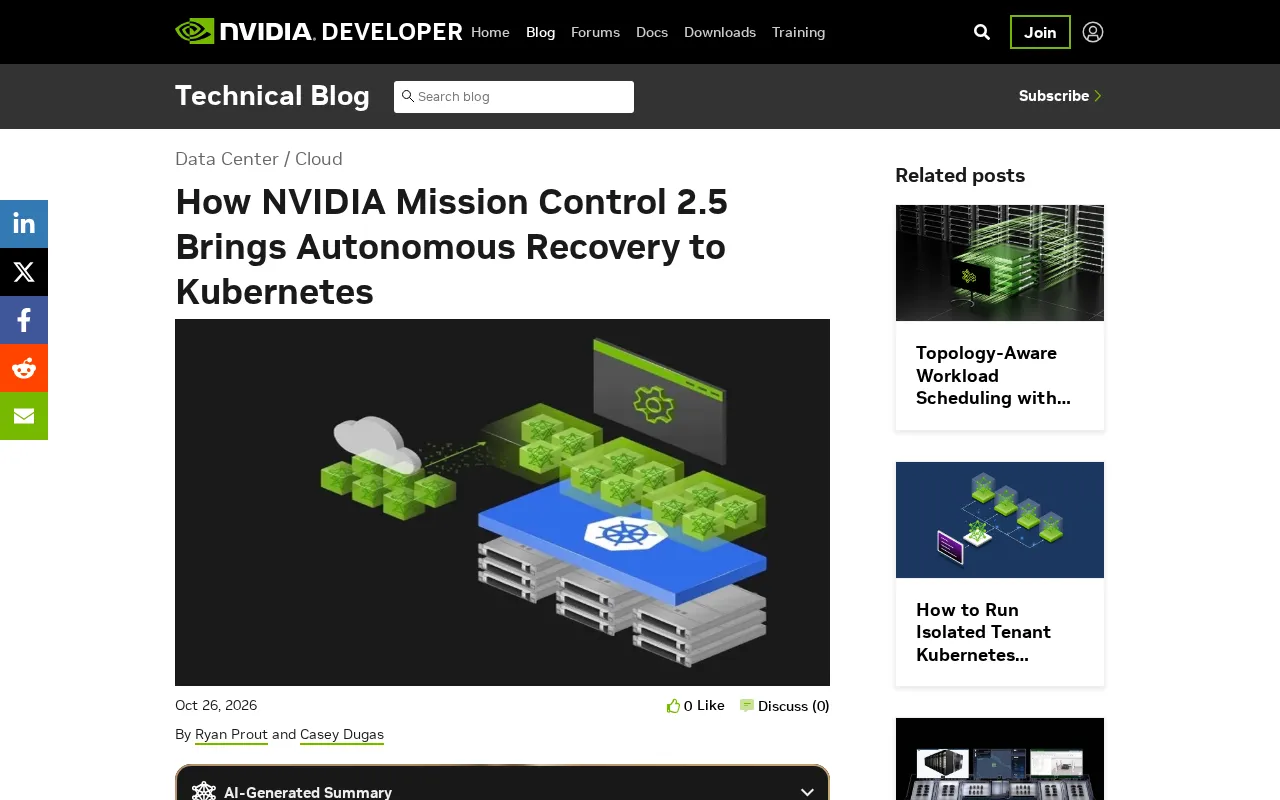
传统做法依赖人工巡检与脚本化重试:任务挂了,工程师登录节点看日志、判断是硬件问题还是软件问题,再决定重启容器还是隔离节点。这套流程在几十块卡的规模下尚可维持,到了数千卡的训练任务里,任何一次停顿都可能意味着数小时的算力空转。Mission Control 2.5 的定位,就是把这套"发现—诊断—处置"的链路交给平台自己完成,把恢复动作从人工运维推进到自动化甚至自治的层面。
Mission Control 2.5 的核心变化
从"监控告警"到"自主闭环"
英伟达对 Mission Control 的描述重点落在两个词上:监控与自动化。2.5 版本把 Kubernetes 作为承载训练的编排底座,意味着 GPU 集群的健康状态、任务状态与容器编排层被纳入同一套可观测与可执行体系。
这背后的逻辑并不复杂:Kubernetes 天然具备声明式管理与自愈能力,但它对 GPU 这类专用硬件的故障语义理解有限——它知道 Pod 挂了,却未必知道是某块 GPU 的显存出现不可恢复错误。Mission Control 补上的正是这一层"硬件语境",使恢复动作能够针对真实故障根因,而不是笼统地重建 Pod。
Kubernetes 的声明式管理与自愈机制,核心是控制器模式(controller pattern):用户声明期望状态(如某个 Deployment 需要 N 个副本),控制器持续比对实际状态并采取行动使二者收敛。这种模式天然适合表达"任务应当处于运行状态",但它对"运行状态"的定义停留在容器层面——Pod 是否就绪、进程是否存活。GPU 故障往往是容器仍然存活、进程也没有退出,只是计算结果出错或通信超时,Kubernetes 的默认探针无法感知。所谓 Operator 模式,就是把领域知识编码进自定义控制器:通过 Custom Resource Definition(CRD)定义 GPU 节点的健康状态与恢复策略,再由控制器监听硬件事件并执行隔离、重启或换节点等动作。Mission Control 在 Kubernetes 之上补的"硬件语境",本质上就是这类扩展机制的产品化实现。
自治恢复解决的实际问题
大规模训练中最消耗时间的往往不是故障本身,而是故障后的定位与协调。一个常见场景是:某个节点出现间歇性异常,任务反复失败但每次都能重启成功,人工很难判断该不该把该节点踢出集群。自治恢复的价值在于用策略和信号替代人的反复试错,把这类"灰色故障"的处理标准化。
对训练平台团队而言,这意味着运维重心从"救火"转向"制定恢复策略"。哪些故障允许原地重试、哪些必须隔离节点、哪些需要回滚到最近的检查点,这些决策可以预先写入规则,由系统在故障发生时即时执行。
文中提到的"灰色故障"在分布式训练中有一个更具体的对应概念:静默数据损坏(silent data corruption)与间歇性慢节点(straggler)。前者指 GPU 显存或互连链路出现位翻转,计算不报错但结果错误;后者指某张卡或某条网络链路性能退化,导致集合通信(如 AllReduce)被整体拖慢。这两类故障都不会让任务立即崩溃,却会让训练损失曲线异常或吞吐骤降,且难以从单点日志中定位。大模型训练通常配合周期性检查点(checkpoint)机制,自治恢复的"回滚到最近检查点"策略正是与此配合:系统在确认故障节点后,从最近一次持久化的模型状态重新拉起任务,牺牲一段已完成的计算来换取确定性。检查点间隔因此成为弹性与效率之间的关键权衡参数。
对 AI 基础设施团队的启示
英伟达把这件事放在 Kubernetes 语境下讨论,释放了一个信号:GPU 集群的运维正在向云原生范式收敛。过去训练平台常自建调度与健康检查体系,现在越来越倾向于复用 Kubernetes 的扩展机制,把 GPU 特有的故障处理以控制器或 Operator 的形式接入。
这也带来新的工程要求。自治恢复的前提是高质量的信号采集——GPU 指标、网络状态、任务进度必须足够细粒度且足够及时,否则自动化决策会建立在错误信息之上。同时,恢复动作本身需要可审计,团队要能回答"系统为什么重启了这个任务",这对日志与事件记录提出了更高要求。
从行业趋势看,随着模型规模继续膨胀,集群弹性已经从"加分项"变成"必选项"。Mission Control 2.5 的意义不在于某一个单点功能,而在于它把自治恢复作为产品方向明确下来,为训练平台的自动化演进提供了一个可参照的路径。
GPU 集群的可观测性通常围绕两类指标展开:硬件层由 NVIDIA 的 DCGM(Data Center GPU Manager)采集,涵盖显存错误、ECC 事件、温度、功耗与 XID 错误码;训练层则由框架侧上报吞吐、损失值与通信耗时。XID 错误码是判断 GPU 故障类型的关键信号,例如 XID 79 表示 GPU 已从总线脱落,XID 48 表示双位 ECC 错误,二者通常都要求隔离节点而非原地重试。自治恢复系统要做出正确决策,前提是把 DCGM 事件、Kubernetes 事件与训练框架日志在时间轴上对齐,形成统一的故障上下文。这也解释了为何可审计性要求很高:决策依据分散在多个数据源,只有完整记录事件序列,事后才能复盘某次重启是否必要。
相关推荐
OpenAI数学突破、Anthropic IPO与推理模型教程
OpenAI公布数学、计算机与物理三项成果,声称证明ETH不成立;Anthropic提交上市申请,披露营收与客户数据;SpaceX获400亿美元GPU融资;开源模型工具调用准确率问题与约束解码方案;8视频推理模型构建教程。

推理模型14个核心概念:从思维链到GRPO全面拆解
系统拆解推理模型14个核心概念:思维链、测试时计算、验证器、RLVR与GRPO、蒸馏与reward hacking,并给出思考token的成本控制规则,帮你判断何时值得为推理付费。

OpenAI称推翻ETH引热议,Meta豪赌AI基建
OpenAI宣布AI辅助发现,预印本声称推翻指数时间假设ETH,同时推出中端模型GPT-6.1 Tera。Cloudflare披露跨客户数据泄露复盘,Meta拟融资950亿美元投入AI基建。