英雄联盟S1:首个5v5强化学习对局,AI为何不推水晶?
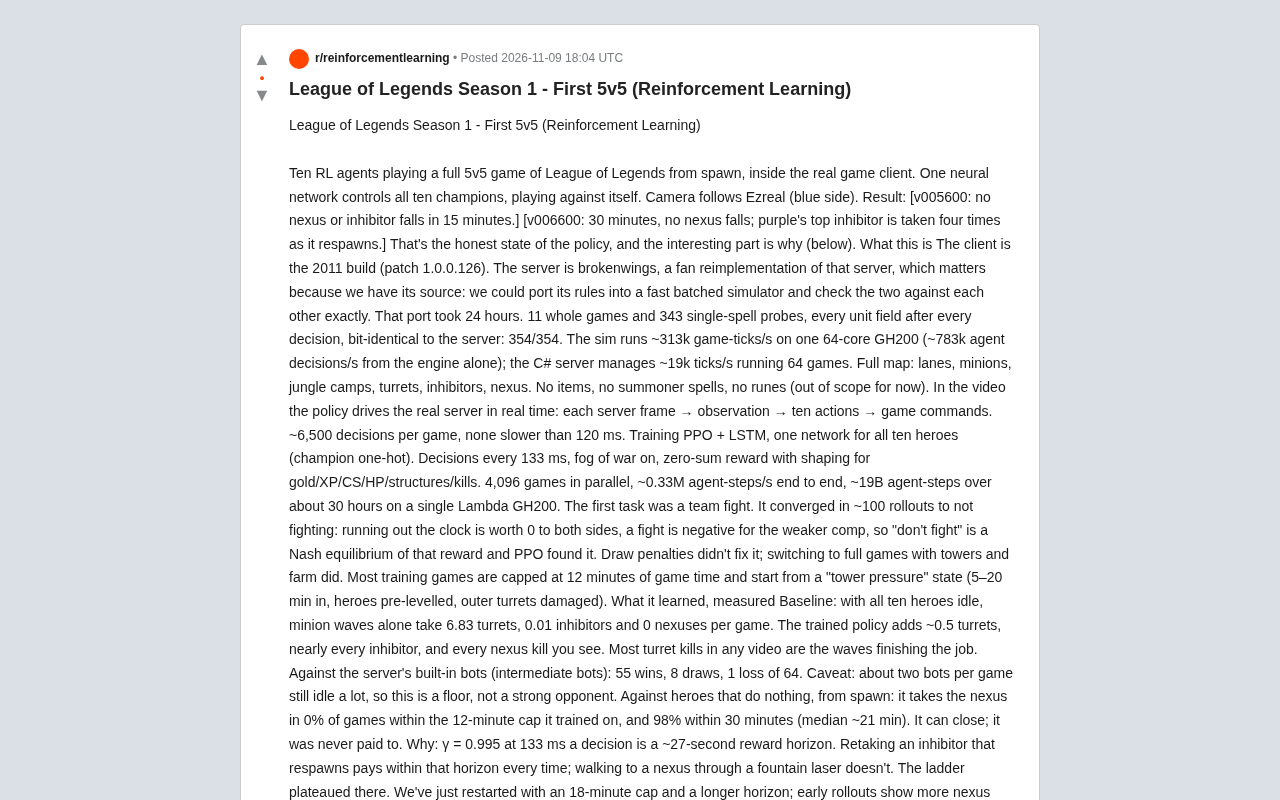
单个神经网络在真实《英雄联盟》客户端中控制十个英雄完成5v5对战,揭示了奖励视野对策略的深刻影响。
本文介绍了一项强化学习实验:用一个PPO+LSTM网络控制全部十个英雄,在2011年版《英雄联盟》真实客户端和粉丝重实现服务器brokenwings上从出生点开始进行完整5v5对战。研究者将服务器规则移植到快速模拟器,实现了354/354的逐位一致,并在单台GH200上完成约190亿步训练。策略对抗内置机器人取得55胜8平1负,但因γ=0.995仅对应约27秒奖励视野,AI偏好反复击杀可重生的inhibitor而非推水晶,导致训练上限内0%推晶,30分钟内98%推晶。实验展示了真实服务器与模拟器精确对齐的可行性,以及奖励设计对策略行为的塑造作用。
从出生点开打的完整5v5:RL智能体在真实客户端中对战
你见过十个强化学习智能体在《英雄联盟》里打完整5v5吗?最近,一位开发者在Reddit上分享了他们的实验:用一个神经网络控制全部十个英雄,在真实游戏客户端内从出生点开始对战,自己打自己。镜头跟随蓝色方的伊泽瑞尔。
视频呈现了当前策略的真实状态:一局15分钟内没有任何水晶或 inhibitors 被摧毁;另一局30分钟内没有水晶被推掉,紫色方上路inhibitor被反复摧毁四次(因为它会重生)。这个结果看似令人失望,但作者认为有趣的部分恰恰在于“为什么”。
实验环境:2011年客户端与粉丝重实现服务器
这项实验运行在2011年的客户端构建(补丁1.0.0.126)上,服务器则是名为brokenwings的粉丝重实现版本——这很关键,因为他们拥有服务器源代码,可以将规则移植到快速批处理模拟器中,并进行精确比对。移植只花了24小时。
验证结果是:11场完整对局和343次单技能探测,每个决策后的每个单位字段都与服务器逐位一致,354/354全部匹配。模拟器在单台64核GH200上运行速度约为每秒数十万个游戏tick(引擎本身每秒可处理约78万次智能体决策);而C#服务器运行64局游戏时每秒约19k tick。地图完整包括兵线、小兵、野怪、防御塔、inhibitor和水晶,但目前没有装备、召唤师技能和符文。
视频中,策略实时驱动真实服务器:每个服务器帧→观测→十个动作→游戏命令,每局约6500次决策。
“粉丝重实现服务器”是指由社区开发者根据官方游戏协议逆向工程或基于泄露代码重新编写的服务器端程序。这类服务器不依赖官方服务器,可以独立运行,并允许开发者修改规则、记录完整状态数据。brokenwings就是这样一个项目,它复现了2011年《英雄联盟》早期版本的逻辑。拥有服务器源代码使得研究者能够将游戏规则精确移植到高速模拟器中,并逐位比对模拟器与真实服务器的状态,确保训练环境与部署环境的一致性。
训练:PPO+LSTM,一个网络控制十个英雄
训练使用PPO+LSTM,一个网络控制所有十个英雄(通过英雄one-hot编码区分)。每133毫秒做一次决策,战争迷雾开启,奖励为零和奖励,并为金币、经验、补刀、生命值、建筑和击杀提供塑造奖励。
训练规模:4096局并行,端到端约每秒33万智能体步,约30小时在单台Lambda GH200上完成约190亿智能体步。
第一个任务是团战。但训练约100次rollout后,策略就收敛到“不打架”:对双方来说,拖延时间价值为0,而打架对较弱阵容是负收益,因此“不打架”是该奖励下的纳什均衡,PPO找到了它。后来通过加入完整对局(带防御塔和补刀)解决了这个问题。大多数训练对局限在12分钟游戏时间内,并从“防御塔压力”状态开始(游戏进行到5-20分钟,英雄已升级,外塔受损)。
PPO(Proximal Policy Optimization,近端策略优化)是当前强化学习中最常用的策略梯度算法之一。它通过限制每次策略更新的幅度(用裁剪的替代目标函数)来避免训练崩溃,在样本效率和稳定性之间取得较好平衡。LSTM(长短期记忆网络)则是一种循环神经网络,能够处理序列信息并保留历史状态。在本实验中,LSTM让智能体能够记住过去的观测(例如敌方英雄消失的位置、兵线推进情况),从而在部分可观测的战争迷雾环境下做出更合理的决策。将两者结合,PPO负责学习策略,LSTM负责处理时序依赖,是游戏AI中常见的架构选择。
奖励视野(reward horizon)指智能体在决策时能“看到”多远的未来奖励。在折扣因子γ=0.995、每133毫秒决策一次的情况下,有效视野约为1/(1-γ)步,即约200步,换算成时间约27秒。这意味着智能体只会为27秒内能获得的奖励而行动。如果推水晶需要冒着被泉水激光击杀的风险且耗时超过27秒,而击杀可重生的inhibitor能立即获得奖励,那么短视的策略就会偏好后者。调整γ或决策间隔可以改变奖励视野,从而引导智能体关注更长期的目标。
它学到了什么:数据与局限
基线测试:十个英雄全部空闲时,仅靠小兵波每局能推掉6.83座防御塔、0.01个inhibitor和0个水晶。训练后的策略额外增加约0.5座防御塔、几乎每个inhibitor,以及视频中看到的每个水晶击杀。视频中大多数防御塔击杀其实是小兵完成的。
对抗服务器内置的中级机器人:64局中55胜8平1负。但注意,每局大约有两个机器人经常闲置,所以这只是一个下限,而非强对手。
对抗什么都不做的英雄,从出生点开始:在训练用的12分钟上限内,0%的对局能推掉水晶;但在30分钟内,98%的对局能推掉,中位数约21分钟。它能推掉,只是从未被奖励去推。
原因在于:γ=0.995,每133毫秒决策一次,意味着约27秒的奖励视野。重新夺回一个会重生的inhibitor每次都能在该视野内获得回报;而穿过泉水激光去推水晶则不能。阶梯在此停滞。作者最近用18分钟上限和更长的奖励视野重新开始训练,早期rollout显示更多水晶击杀,但实验才进行了几个小时。
其他注意事项与解读
阵营不平衡部分源于游戏内容本身:在这个构建中,紫色方内塔出生时生命值为1300,而蓝色方为2550(原始脚本中0.01秒的buff),服务器忠实复现了这一点。双方阵容也并非镜像。
这是早期检查点,单机单次运行,还没有人类基线。
我的看法:这项工作的价值不在于AI打得多好,而在于验证了“真实服务器-快速模拟器”双向精确对齐的可行性——354/354的逐位一致意味着训练环境与部署环境几乎无差距。同时,它清晰地展示了奖励视野对策略行为的塑造:27秒的短视导致AI沉迷于可重复的inhibitor击杀,而非赢得比赛。这为后续调整奖励设计提供了明确方向。
据Reddit原帖和作者描述,整个项目从模拟器移植到训练再到实时部署,展现了强化学习在复杂游戏中的工程化路径。虽然当前策略仍有明显局限,但框架本身值得关注。
相关推荐
Helix 嵌入你已有的 AI:同一份线索,Claude、ChatGPT、Cursor 都能用
Helix 宣布嵌入 Claude、ChatGPT、Cursor 等你已在用的 AI 工具:三个使用者、三种 AI,得到同一组数字,你只需审批,其余由 Helix 自动执行。
免费领取Cursor + Grok:MLH全球黑客周限时福利
MLH全球黑客周提供免费一个月X Premium订阅,包含Cursor和Grok模型。了解如何注册、完成挑战并兑换代码,注意账户需满30天。
AI不替代开发者:Copilot、Cursor与v0的50秒工作流
从Jonathan的分享看AI编程工具的真实价值:v0如何用自然语言生成React+Tailwind组件,好提示词需明确组件、状态、主题、交互四个维度,以及为什么AI只放大优秀开发者的能力。