用12行代码实现AI Agent工具调用:Claude与OpenAI的Function Calling实战

AI Agent本质是「模型选工具、Python执行、按ID循环回答」,Claude与OpenAI仅术语不同逻辑完全相同。
本文揭示了AI Agent的核心本质:LLM不执行代码,只负责从工具菜单中选择函数并发出调用请求,由Python应用真正执行,再把结果连同ID返回给模型,在循环中完成任务。Claude的`tool_use`与OpenAI的`function_call`走的是完全相同的逻辑,仅字段命名和参数格式存在差异。工程实践中,工具内部错误应作为结果返回而非直接抛异常,以提供友好交互;Pydantic的strict模式只保证输出结构正确,业务规则必须写进工具代码而非依赖提示词。最常见的生产级错误是混用不同API调用之间的ID,导致上下文断裂。整套循环逻辑可用约12行代码实现,下一阶段的Agentic SDK本质上只是将这套手写循环封装起来。
一个被过度神化的概念:Agent 的本质是工具调用
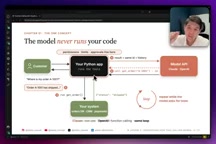
很多人把 AI Agent 想得过于复杂,但剥离框架后其核心逻辑异常简单。拥有 Apple、Microsoft 等 FAANG 企业十余年经验的讲师 Eldan 在应用系列课程第二讲中直言:大语言模型(LLM)本身不执行代码,它只负责调用。
这是理解 Agent 的第一性原理。当用户问「我的订单在哪?」时,模型并不会凭空知道答案,它会从你提供的工具菜单中选择 get_order 函数,由你的 Python 应用去查询订单数据库,再把结果(如发货状态)连同相同的调用 ID 和对话历史返回给模型 API,最后由模型组织出自然语言回复:「您的订单已发货」。
整个流程可以概括为一句话:模型发问,Python 执行,你按 ID 回答,在循环中完成。 这就是 Agent 工具调用的全部主干逻辑,复杂度远低于想象。
同一个循环,两套命名:Claude 与 OpenAI 的差异
讲师特别强调了一个容易混淆的点:Claude 和 OpenAI 走的是完全相同的循环逻辑,只是术语和字段名不同。
模型发出调用请求时
- 在 Claude 中,这叫
tool_use,出现在响应内容的 block 块里,输入参数已经是现成的字典(dictionary),ID 字段为tool_use_id。 - 在 OpenAI 中,这叫
function_call,位于响应的 output 项中,参数是 JSON 字符串,需要用json.loads解析,ID 字段为call_id。
结果返回时
- Claude 以
tool_result形式返回; - OpenAI 以
function_call的输出形式返回。
循环的终止条件
- Claude 检查
stop_reason是否等于tool_use; - OpenAI 则检查 output 中是否包含 function call。
工具选择(tool choice)上,两者共用 auto、required、none 等概念,默认都是自动模式。理解了这套「同构不同名」的映射关系,跨平台迁移代码几乎没有障碍。
定义工具与保证 Schema 的严格性
工具定义本质上就是一个普通的 Python 函数,加上清晰的描述和严格的 schema。课程中以订单查询为例:先初始化 Anthropic 客户端和系统提示词,用一个简单字典模拟订单数据库(实际可以是任意数据库或 CRM 系统),然后实现 get_order 函数。
一个关键的工程细节是错误处理策略:当订单 ID 不存在时,函数内部不会直接抛出异常中断流程,而是把错误信息作为结果(带上 is_error 标志)返回给模型。这样用户得到的不是生硬的 400 报错,而是「我找不到这个订单,能否再核对一下 ID?」这类友好提示——这是生产环境中值得借鉴的实践。
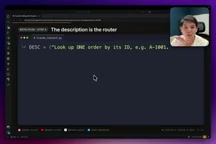
Schema 定义中最重要的部分包括:type 为 object、properties 中声明 order_id 字段、required 标注必填项,以及 additionalProperties: false 来禁止传入多余字段。Claude 把参数字段叫 input_schema,OpenAI 则叫 parameters,但 strict 严格模式两者通用。一个工具,两种形态,内核完全一致。
JSON Schema 是一种用于描述 JSON 数据结构的规范,广泛用于 API 参数校验。在工具调用场景中,additionalProperties: false 这一约束尤为关键:它告诉模型「只允许传入你声明过的字段」,防止模型幻觉出额外的参数导致下游函数报错。required 数组则显式列出所有必填字段,使模型在生成调用请求前就能自检参数完整性。与 REST API 的请求体校验不同,这里的 schema 不仅是服务端的防护墙,更是模型「理解工具用法」的唯一信息来源——描述写得越精准,模型选错工具或填错参数的概率就越低。这也是为什么课程强调工具描述(description)和 schema 定义需要同等认真对待:前者告诉模型「什么时候用这个工具」,后者告诉模型「怎么用这个工具」。
12 行代码跑通 Agent 循环
循环的实现堪称精简。核心是一个最多运行五轮的 for 循环(turns),每轮都调用模型,并把响应追加(append)到 messages 历史中——因为 API 本身是无状态的(stateless),必须由开发者手动维护上下文。
逻辑判断很直接:如果 stop_reason 不是 tool_use,说明任务完成,直接返回文本结果;否则,过滤出所有工具调用请求,逐个执行对应函数,再把工具结果塞回 messages 继续下一轮。
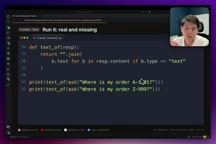
实际测试中,查询存在的订单会返回「已发货/处理中」等真实状态;查询不存在的订单(如编号 999)则返回「找不到该订单,请核对 ID」。OpenAI 侧的代码仅有三处差异:用 json.loads 解析参数、处理 error 字段、以及传递 call_id——其余逻辑几乎一字不差。
API 的无状态性(statelessness)是理解为何必须手动维护 messages 历史的根本原因。每次调用 LLM API,服务端不会记录任何上一轮的信息,每个请求都是独立的。这与传统的有状态服务(如保持 session 的 Web 服务器)截然不同。因此,开发者必须把完整的对话历史——包括用户输入、模型回复、工具调用请求和工具返回结果——全部序列化后随每次请求一并发送。这也意味着随着对话轮次增加,每次请求的 token 消耗会线性增长,长对话场景下需要额外考虑上下文窗口(context window)的大小限制以及截断策略。五轮循环上限的设计,正是防止模型陷入工具调用死循环而消耗过多 token 和时间的一种实用保护机制。
用 Pydantic 保证输出结构:从「能跑」到「可靠」
仅靠工具调用还不够,当需要把工单(ticket)结构化时,就要引入 Pydantic 的 BaseModel。课程定义了一个 Ticket 类:category 使用 Literal 限定为 shipping、billing、other 三种;order_id 为可选字符串;urgent 为布尔值。
Claude 通过 messages.parse 并指定 output_format=Ticket 来获取结构化输出,OpenAI 则用 responses.parse 配合 text_format=Ticket。两者都能直接拿到 parsed_output,字段严格匹配预定义的 schema。
讲师提出了一个深刻的警示:strict 模式只保证「结构正确」,不保证「业务正确」。 一个格式完美的调用,仍然可能去取消一个已发货的订单,或匹配到错误的客户。因此,业务规则应当写在工具代码里,而不是提示词里——因为代码可测试、可度量,而提示词难以保证一致性。
Pydantic 是 Python 生态中广泛使用的数据验证库,其 BaseModel 允许开发者以声明式的方式定义数据结构,并在运行时自动完成类型检查和数据转换。在 LLM 输出解析场景中,它解决的核心问题是:模型输出的自然语言或 JSON 字符串本质上是不可信的,直接用 json.loads 解析后访问字段极易因键名拼写错误或类型不符而崩溃。通过将 Pydantic 模型传递给 SDK 的 parse 方法,SDK 会在底层将模型结构自动转换为 JSON Schema,强制模型按此格式输出,再反序列化为强类型的 Python 对象。Literal 类型的使用尤为重要:它将字段值限定为有限枚举集合,彻底杜绝模型输出「Ship」「Shipping」「已发货」等变体字符串导致的下游 if-else 判断失效问题。
进阶挑战与常见错误
课程留了一道实操题:新增 cancel_order 工具,并要求它拒绝取消已发货的订单。在讲师的参考实现中,取消函数会先检查订单状态,若已发货则抛出提示并建议退货,否则将状态置为 cancelled。这正体现了 Agent 的决策能力——面对「取消这两个订单」的指令,模型会对已发货订单建议退货,对未发货订单执行取消。
最后,讲师归纳了工具调用中最高频的生产级错误:用错误的 ID 回应工具调用。
- Claude 会报
400 unexpected tool_use_id; - OpenAI 会报
400 no tool output found for function call。
根源通常是在多个 API 调用之间混用了不同的 ID,导致上下文断裂、答案错乱。记住一句话就够了:模型发问,你的 Python 执行,你按 ID 在循环中回答。
下一讲将进入 Agentic SDK(Claude Agent SDK 与 OpenAI Agent SDK),这些 SDK 已经把本文手写的循环逻辑封装好了——这正是 AI Agent 背后看似复杂、实则简洁的真相。
相关推荐

OpenAI与Shield合作:Astra智能体如何革新IT故障修复
OpenAI与Shield合作推出Astra智能体,可自动登录电脑和遗留系统,实时修复IT故障,比传统模型快35%到40%,仅在需要人类判断时引入人工。

iPhone Duo续航实测:一天一充跑不掉,大屏是耗电元凶
iPhone Duo续航实测:重度使用一天需至少充电一次,6.5小时亮屏约剩30%电量。大屏展开频率是耗电关键,MagSafe电池背夹可救场,长期衰减同样值得关注。

Kimi K3.1 Pro开源发布:2.8万亿参数逼近Opus
Moonshot发布开源MoE模型Kimi K3.1 Pro,2.8万亿总参数、1040亿激活参数,Terminal Bench 4.0仅落后Opus 5.5不到1分,单任务成本约三分之一,API价格减半,开源权重11月4日开放。