用Jacobian透镜探测视觉语言模型的"意识":选择性访问与全局工作空间
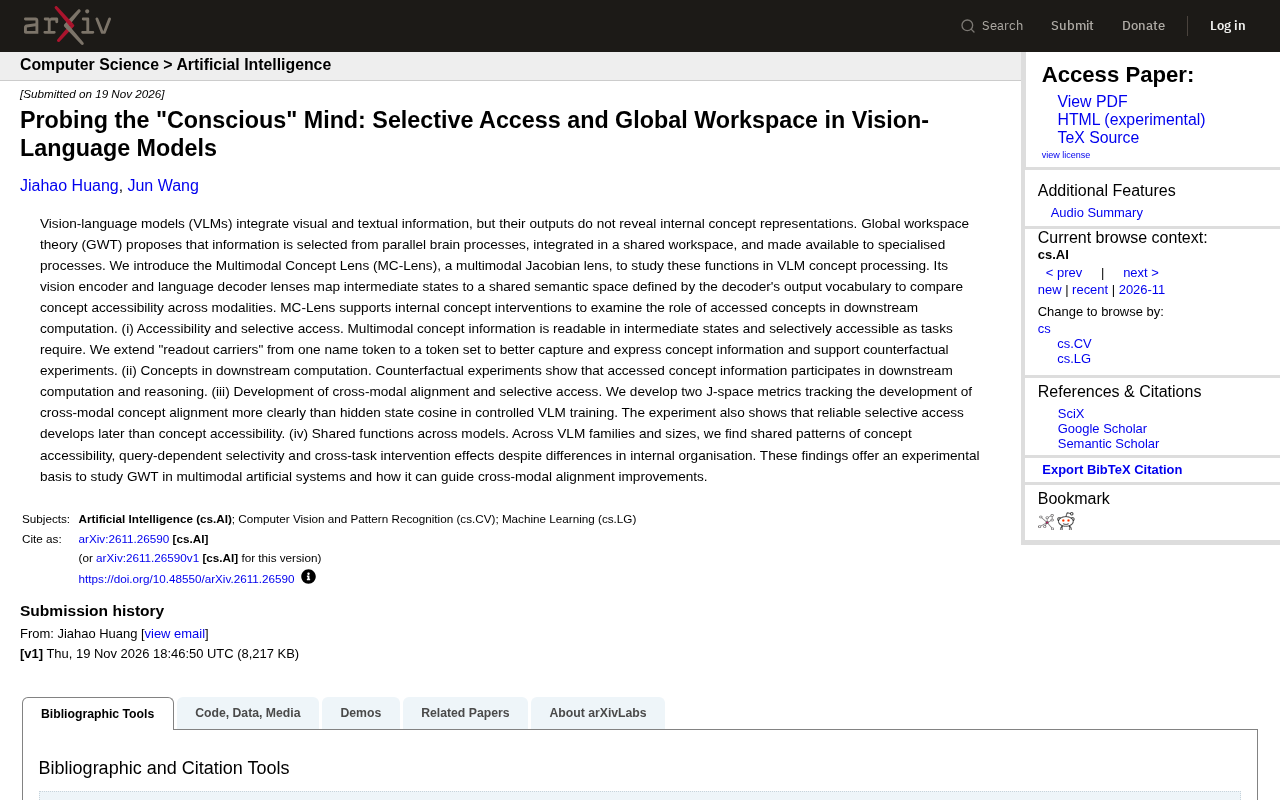
研究提出MC-Lens探测VLM内部概念表征,验证其符合全局工作空间理论。
研究借鉴认知科学的全局工作空间理论,提出多模态概念透镜MC-Lens,通过将VLM中间状态映射到共享语义空间,探测概念信息如何被选择、整合和利用。实验发现:概念信息在中间层可读且按任务选择性访问;反事实干预证明被访问概念实际参与下游推理;选择性访问能力的发展晚于概念可访问性;不同VLM家族间存在共享的功能模式。该工作为理解VLM内部机制提供了新工具和理论框架。
视觉语言模型(VLM)能看图说话,但它们的内部概念表征一直是个黑箱。最近一项研究借鉴认知科学中的全局工作空间理论(GWT),提出了多模态概念透镜(MC-Lens),试图打开这个黑箱,观察概念信息如何在VLM内部被选择、整合和利用。
全局工作空间理论遇上VLM
GWT认为,大脑的并行处理过程会筛选信息,将其整合到一个共享工作空间中,再提供给专门的处理模块使用。研究团队想知道,VLM是否也存在类似的功能架构。
他们提出的MC-Lens是一种多模态Jacobian透镜,包含视觉编码器透镜和语言解码器透镜,将中间状态映射到由解码器输出词汇表定义的共享语义空间。这样一来,就可以跨模态比较概念的可访问性,并支持对内部概念进行干预实验。
这种方法的关键创新在于,它不依赖模型输出,而是直接探测中间层表征,为理解VLM的内部计算提供了新工具。
Jacobian透镜是一种用于解释神经网络内部表征的技术。其核心思想是利用模型输出对中间层激活的雅可比矩阵(即输出关于中间层状态的偏导数),将中间层的激活向量映射到输出空间(如词汇表空间),从而解读每个中间神经元或维度对最终输出的贡献。与仅依赖前向传播的探针方法不同,Jacobian透镜能够捕捉中间状态与输出之间的局部线性关系,揭示模型如何将内部概念转化为具体预测。在MC-Lens中,研究者将这一思想扩展到多模态场景,分别对视觉编码器和语言解码器构建透镜,并将二者映射到共享的语义空间,从而实现跨模态的概念比较与干预。
概念信息可读且可选择性访问
实验的第一个发现是:多模态概念信息在中间状态中是可读的,并且会根据任务需要被选择性访问。
研究团队将"readout carriers"(读出载体)从单个名称token扩展到token集合,以更好地捕获和表达概念信息,并支持反事实实验。这意味着,模型内部的概念表征并非孤立存在,而是以集合形式组织,能够灵活应对不同任务需求。
例如,当模型需要识别图像中的物体时,相关概念信息会被优先访问;而在其他任务中,这些信息可能被抑制。这种选择性访问机制与GWT的预测一致。
反事实实验在可解释性研究中指通过人为干预模型内部状态(如激活值、概念方向),观察输出如何变化,从而推断该状态是否对模型行为具有因果作用。与仅观察相关性的探测方法不同,反事实干预能够建立因果关系:如果修改某个概念表征导致输出按预期改变,则说明该概念参与了计算。在MC-Lens中,研究者利用读出载体定位概念信息后,对其进行定向修改(如替换或抑制),并观察模型推理结果的变化,以此验证被访问概念的下游功能角色。
被访问的概念参与下游计算与推理
第二个发现更具说服力:反事实实验表明,被访问的概念信息确实参与了下游计算和推理过程。
研究人员通过干预内部概念状态,观察模型输出的变化。结果显示,改变被访问的概念会显著影响模型的推理结果,这证明这些概念不是旁观者,而是计算过程的实际参与者。
这一发现对于理解VLM的推理机制很关键。它表明,模型并非简单地记忆训练数据,而是真的在内部构建并操作概念表征。
跨模态对齐与选择性访问的发展
研究还追踪了跨模态概念对齐和选择性访问的发展过程。团队开发了两个J-space指标,在受控的VLM训练中,这些指标比隐藏状态余弦相似度更清晰地反映了跨模态概念对齐的进展。
一个有趣的发现是:可靠的选择性访问发展晚于概念可访问性。换句话说,模型先学会"知道"概念,然后才学会"按需调用"概念。这类似于人类认知发展中,知识积累先于执行控制能力的成熟。
J-space指标是研究团队为量化跨模态概念对齐与选择性访问而设计的评估度量。与传统的隐藏状态余弦相似度相比,J-space指标基于Jacobian透镜映射后的语义空间进行计算,能够更直接地反映概念在输出词汇表空间中的可访问性与任务依赖性。具体而言,这些指标衡量同一概念在不同模态(如图像与文本)下的表征在共享语义空间中的一致性,以及模型能否根据查询需求选择性地激活相关概念。在受控训练实验中,J-space指标显示出比余弦相似度更清晰的进展趋势,表明其更适合追踪概念对齐的动态发展。
不同模型间的共享模式
最后,研究团队在不同VLM家族和规模上进行了验证,发现尽管内部组织存在差异,但概念可访问性、查询依赖的选择性和跨任务干预效果等方面存在共享模式。
这表明,这些功能特性可能是VLM的普遍属性,而非特定架构的产物。这为GWT在多模态人工系统中的适用性提供了实验基础,也为改进跨模态对齐提供了潜在方向。
对AI研究的启示
这项工作的价值不仅在于提出了新的探测工具,更在于它为理解VLM的内部机制提供了一个理论框架。通过将认知科学的理论引入AI可解释性研究,研究者们开辟了一条新的路径。
当然,这并不意味着VLM真的具有"意识"——标题中的引号提醒我们,这只是一个类比框架。但通过研究这些功能层面的相似性,我们或许能更好地理解和改进这些模型,让它们的内部计算更加透明和可控。
未来,这类方法可能帮助我们发现模型中的偏见、错误推理模式,甚至指导更高效的训练策略。对于AI安全和可解释性研究而言,这无疑是一个值得关注的方向。
相关推荐
哈佛AI安全课程CS 2881R引热议
哈佛大学CS 2881R AI Safety课程在Hacker News被提及,本文介绍课程背景、AI安全的核心议题及对学习者的启示,帮助理解顶尖高校如何培养AI安全人才。

拓展社交圈:值得尝试的几款交友应用
交友应用怎么选?本文梳理朋友发现平台BFF与活动导向应用Timeleft等不同定位的友谊类应用,分析两类思路的适用人群,并给出线下见面安全与预期管理的实用建议。
为什么不该在个人电脑上运行Hermes智能体
为什么不应该在个人电脑上运行Hermes等自主AI智能体?本文从安全风险、资源占用、凭证泄露和自主性需求四个角度,分析为何应将智能体部署到独立VPS而非主力设备,并给出隔离部署的实践逻辑。