用Lean形式化验证Transformer:从零证明模型不变量

用Lean定理证明器为Transformer建立数学级不变量验证,探索形式化方法进入深度学习的可行路径与边界。
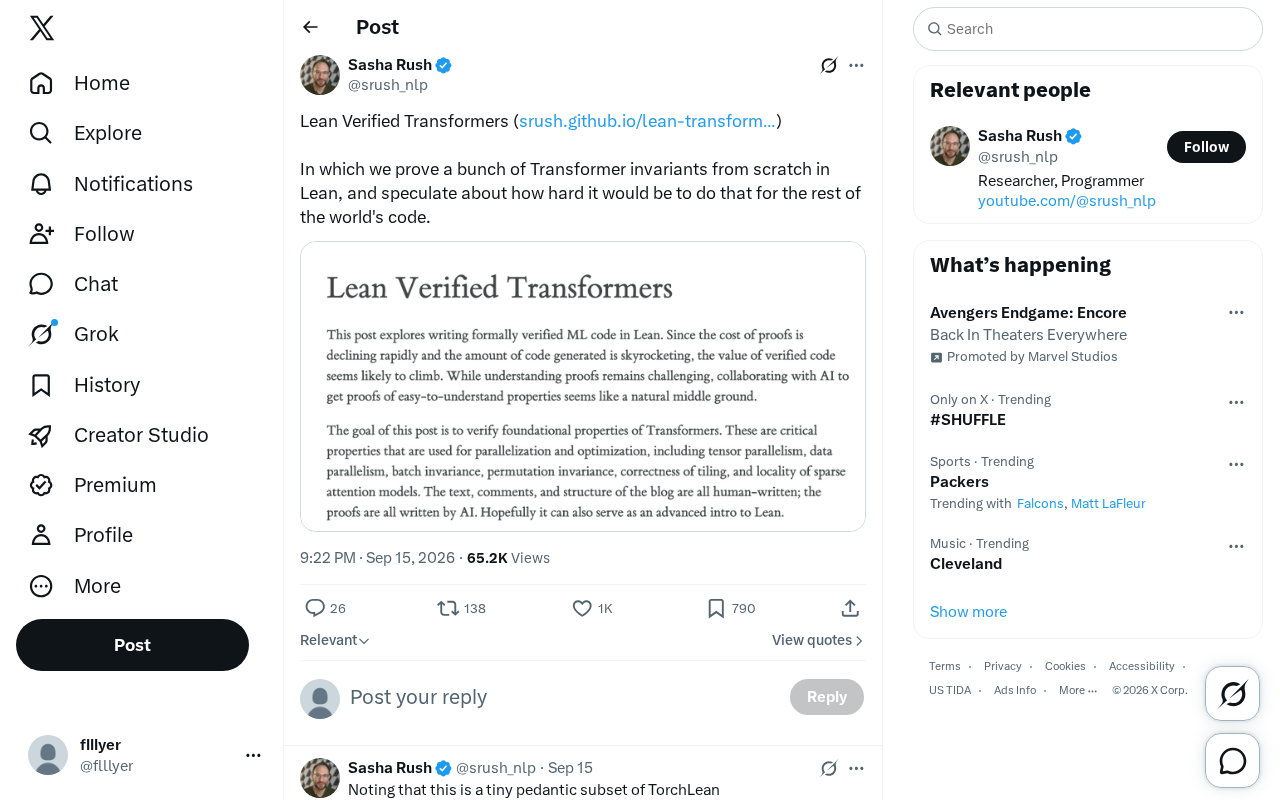
「Lean Verified Transformers」项目将形式化验证引入深度学习领域,使用交互式定理证明器 Lean 从零证明 Transformer 架构的一系列不变量,包括张量形状守恒、softmax 输出归一化等性质,实现了超越单元测试的数学级正确性保证。Transformer 因其矩阵运算为主、数学结构规整的特点,成为这一尝试的友好起点。文章同时探讨了将同等严格性推广至「世界上其余代码」的现实困境——验证成本高昂、规约难以精确定义是长期瓶颈。作者也明确指出边界:验证计算图的正确性远不等同于验证模型的语义安全性,形式化方法目前无法触及权重层面的有害输出问题。这项工作的意义更在于示范了一条将严格数学工具引入 AI 基础设施的可行路径。
当形式化验证遇上深度学习
形式化验证(Formal Verification)长期以来是数学证明和关键系统软件(如航空航天、编译器、密码学协议)的专属领域。而一项名为「Lean Verified Transformers」的工作,尝试把这套严格的证明机制引入到深度学习的核心架构——Transformer 之上。
这项工作的核心思路是:使用交互式定理证明器 Lean,从零开始(from scratch)证明一系列 Transformer 的不变量(invariants)。这意味着不是通过大量测试用例来「经验性地相信」模型行为符合预期,而是用数学证明的方式,严格地保证某些性质在所有可能输入下都成立。
什么是「Transformer 不变量」
在软件与算法语境中,「不变量」指的是在特定操作前后始终保持为真的性质。对于 Transformer 而言,这类不变量可能包括:
- 形状不变量:张量在经过各层计算后,其维度变换符合预期,不会出现意料之外的维度错配。
- 数值性质:例如 softmax 输出的每一行之和恒为 1,注意力权重始终为非负。
- 等变性/不变性:某些排列或变换下模型行为的对称性。
用 Lean 这样的证明助手来「机器检查」这些性质,好处在于证明一旦通过,就是无懈可击的数学保证,而非依赖抽样测试可能遗漏的边界情况。这对追求高可靠性的 AI 系统构建者而言,具有相当的吸引力。
Lean 为何适合这类任务
Lean 是近年来在数学界和形式化方法社区快速崛起的定理证明器。它兼具函数式编程语言的表达能力和依赖类型系统(dependent types)的强大表达力,能够把「一个程序满足某种规约」这件事,编码成一个可被机器检查的类型命题。
把 Transformer 的计算过程在 Lean 中重新实现,并为其关键步骤附上证明,实际上是在构建一个「带证明的参考实现」。这条路径与传统机器学习工程中「写代码 + 单元测试」的范式截然不同——它要求开发者对每一步计算的数学含义有精确理解。
依赖类型系统(dependent types)是理解 Lean 能力边界的关键。在普通类型系统中,类型仅描述数据的「种类」(如整数、字符串),而依赖类型允许类型本身依赖于值——例如,可以定义「长度恰好为 n 的向量」这一类型,其中 n 是一个运行时的具体数字。对 Transformer 验证而言,这意味着可以在类型层面直接表达「一个形状为 [batch, seq_len, d_model] 的张量经过注意力层后输出形状为 [batch, seq_len, d_model]」这类约束,而非靠运行时断言捕获错误。Lean 4 还基于 Curry-Howard 同构,将「命题」与「类型」统一:证明一个数学命题等价于构造一个特定类型的程序,这使得数学证明可以被编译器像类型检查一样自动验证,从根本上消除了「证明本身出错」的可能性。Mathlib 是 Lean 社区维护的庞大数学库,已覆盖线性代数、分析、数论等大量基础数学定理,为 Transformer 验证中涉及的矩阵运算性质提供了可复用的证明积木。
从 Transformer 到「世界上其余的代码」
作者在原文中提出了一个更具野心的追问:把 Transformer 这样一个相对规整、数学结构清晰的架构验证出来之后,要把同样的严格证明推广到「世界上其余的代码」(the rest of the world's code),究竟有多难?
这个问题触及了形式化验证长期以来的核心瓶颈:验证成本。为一段代码写出完整的形式化规约与证明,工作量往往数倍乃至数十倍于代码本身。Transformer 之所以是一个相对友好的起点,正因为它由矩阵乘法、归一化、注意力等结构高度规整的操作组成,数学性质明确。而现实世界中充斥着副作用、并发、外部状态、模糊需求的代码,其规约本身就难以精确定义,更遑论证明。
作者的「speculate(推测)」态度也很诚实——这更像是一次探索性的思想实验,而非宣称形式化验证已经能够规模化覆盖所有软件。
形式化验证的「规约问题」往往比「证明问题」更棘手。规约(specification)是对「系统应该做什么」的精确数学描述,而现实代码的需求常常以自然语言存在,充满歧义与隐含假设。历史上,形式化验证的成功案例集中在边界清晰的领域:seL4 微内核用 10 人年完成了约 10,000 行 C 代码的验证;CompCert 验证编译器花费了约 6 人年。这些项目的共同点是:系统行为可以被精确数学化,且几乎不涉及模糊的业务语义。相比之下,Transformer 的不变量(如 softmax 输出和为 1、维度守恒)天然就是数学命题,无需「翻译」,这正是它作为验证起点的独特优势,也是为何同样方法难以直接移植到业务逻辑代码的根本原因。
对 AI 可靠性的启示
随着大模型被部署到越来越关键的场景,如何为 AI 系统提供可验证的行为保证,正成为一个受关注的方向。形式化验证 Transformer 至少提供了一种思路:先从架构层面的确定性性质(如数值稳定性、维度正确性)入手,建立可证明的基础设施,再逐步向更复杂的语义性质延伸。
当然,需要清醒地认识到边界:验证 Transformer 的计算图正确,并不等同于验证模型「不会产生有害输出」或「推理结果正确」——后者涉及的是学习到的权重与语义层面的问题,远超当前形式化方法能够触及的范围。
这项工作的价值,更多在于示范了一条把严格数学工具引入深度学习基础设施的路径,以及对这条路径能走多远的坦率思考。
注:本文基于一条推特的简短介绍撰写,项目的具体证明细节请以原始链接及代码仓库为准。
相关推荐

Harness架构实战:企业级智能体项目拆解与AI岗位进阶指南
深度拆解基于Harness(驾驭工程)架构的企业级智能体实战项目,涵盖多模型配置、ASGI部署、MCP协议对接ERP系统、Sandbox沙箱隔离等核心模块,帮助AI大模型求职者理解工程化落地方向的面试要点。

fal.ai API密钥配置与n8n集成完整教程
手把手教你创建 fal.ai API 密钥并连接到 n8n:涵盖官方集成节点配置、凭证保存、HTTP 请求替代方案以及密钥安全注意事项,快速跑通首次 AI 媒体生成工作流。

系统设计面试笔记开源项目:2.4万星的学习利器
开源项目 liquidslr/system-design-notes 整理了经典书籍《System Design Interview》的学习笔记,GitHub 收获 2.4 万 Star。本文解析其内容价值、适用人群及系统设计面试复习建议。