用Skill赋能AI Agent自动统计公众号运营数据

从手动统计到智能自动化
对于内容创作者来说,定期整理公众号后台数据是一项耗时又枯燥的工作。每周发布内容后,需要登录微信公众号后台,逐页翻查发表记录,再手动将阅读量、点赞量等数据录入Excel进行分析——不仅费时,还容易出错。
而借助AI Agent与Skill(技能包)的结合,这套流程正在被彻底改变。用户只需用自然语言描述需求,Agent便能自主完成从登录后台、抓取数据到生成报表的全流程操作。本文将以一个实际演示案例为基础,拆解Skill如何辅助Agent完成公众号数据统计任务。
什么是Skill加持的AI Agent
AI Agent:从"回答问题"到"完成任务"的技术跨越
AI Agent(智能代理)是一种能够感知环境、自主规划并执行多步骤任务的AI系统,与传统的单轮问答式大语言模型有本质区别。其核心架构通常包含三个关键组件:感知层(接收用户指令与环境反馈)、规划层(基于大模型进行任务拆解与决策)以及执行层(调用工具、API或外部服务完成实际操作)。
这三层架构在工程实践中远比概念描述更为复杂:感知层不仅处理文本指令,还可摄入网页截图、HTML DOM树乃至音视频等多模态输入;规划层在思维链推理之上,通常还引入ReAct(Reasoning + Acting)范式——这一由Google与普林斯顿大学于2023年联合提出的框架,将推理(Reasoning)与行动(Acting)交织进行,使Agent能够在执行过程中根据每一步的中间结果动态调整后续计划,而非在行动前一次性生成完整计划,极大地提升了应对意外状况的鲁棒性;执行层则通过工具调用(Tool Calling)机制将高层意图映射为具体API请求或界面操作序列。
规划层通常还依赖「思维链」(Chain-of-Thought)推理能力——这一由Google研究团队于2022年提出的技术,通过在Prompt中加入中间推理步骤,显著提升了模型处理多步骤复杂任务的准确率,其本质是将"直接给答案"改为"边推理边给答案",更接近人类解题时的认知过程。当前Agent能力的天花板,很大程度上取决于底层大模型的上下文窗口长度与指令遵循精度——这也是为什么GPT-4o、Claude 3.5 Sonnet等长上下文模型在Agent场景中表现更为出色。当前主流的Agent框架如LangChain、AutoGPT、OpenAI的Function Calling机制等,均在探索如何让模型从"理解语言"扩展到"操控世界"。Skill机制正是执行层的核心抽象——它将特定领域的操作逻辑封装为可复用的能力单元,让Agent无需每次从零推理如何完成一项具体任务。
Skill的核心作用
在AI Agent的语境下,Skill可以理解为赋予Agent特定能力的"技能包"。原生大语言模型擅长理解和生成文本,但缺乏执行具体操作(如登录网站、读写表格)的能力。Skill正是弥补这一短板的关键——它为Agent注入了完成特定任务所需的可执行逻辑。
值得一提的是,Skill这一概念在不同AI平台中有不同的实现形式,但底层逻辑高度一致:将外部能力以结构化方式暴露给大模型调用。OpenAI将其称为"Function Calling"或"Tools",Anthropic的Claude使用"Tool Use",微软Copilot生态中则对应"Plugin"与"Connector"体系。从技术标准化角度看,2024年底由Anthropic提出并开源的**MCP(Model Context Protocol,模型上下文协议)**正试图成为连接AI模型与外部工具的统一接口规范——其设计灵感来源于微软于2016年为VS Code提出的LSP(Language Server Protocol):在LSP出现之前,每种编程语言都需要为每款编辑器单独开发插件,M种语言×N款编辑器意味着M×N的集成工作量;LSP将这一复杂度降为M+N,MCP试图在AI领域复现同样的降维效果,让任意Skill能够被任意兼容的Agent调用,彻底打破各平台的能力孤岛。
MCP协议的设计不仅解决了工具调用的碎片化问题,更引入了**资源(Resources)、提示模板(Prompts)和工具(Tools)**三类原语,形成完整的上下文管理规范:Resources允许Agent读取文件、数据库等外部上下文;Prompts提供可复用的任务模板;Tools则封装具体可执行的操作逻辑。这一三位一体的设计,使MCP Server既能向Agent提供"知识",又能赋予其"行动力"。截至2025年,已有包括Cloudflare、Block等头部企业宣布对MCP的官方支持,VS Code、Cursor等主流开发工具相继集成MCP客户端,标志着这一协议正从社区标准走向行业规范。目前已有数百个MCP Server被开源社区贡献,覆盖文件操作、数据库查询、浏览器控制等核心场景,这一生态的成熟度将直接决定"自然语言驱动一切"这一愿景的实现速度。
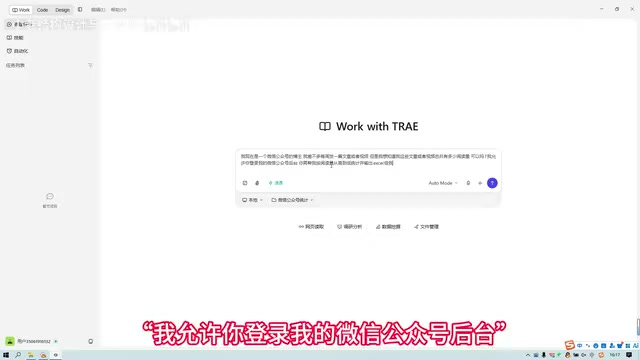
在本案例中,创作者选好目标文件夹后输入指令:"我每周发一篇作品,我允许你登录我的微信公众号后台,按照阅读量从弱到低进行Excel统计。"这段自然语言包含了明确目标(Excel统计)、数据来源(公众号后台)和排序规则(阅读量从低到高),Agent据此即可展开行动。
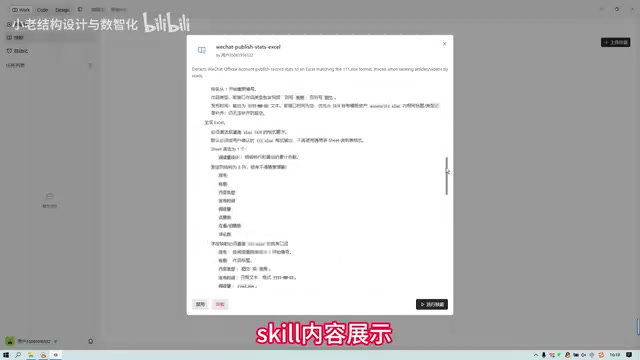
从需求到执行的转化
用户点击运行后,Agent调用对应的Skill进行任务拆解与规划:如何登录后台、访问哪些页面、提取哪些字段、按什么规则排序、以何种格式输出结果。Skill的加持,使抽象的自然语言意图得以转化为具体、可执行的操作序列。
自动化数据统计的完整流程
第一步:自主登录后台
Agent获得用户授权后,直接登录微信公众号后台,进入发表记录页面。这一步体现了Agent的自主导航能力——无需人工逐步引导,它能根据任务目标自行定位到目标界面。
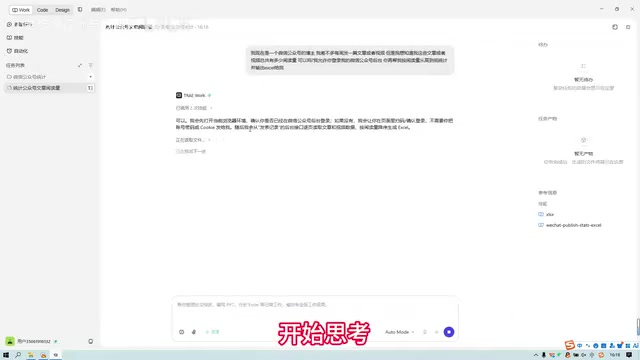
第二步:逐页抓取数据
进入发表记录后,Agent开始遍历所有分页。公众号历史文章通常分布在多个页面,Agent能识别分页结构,依次抓取每一页的文章标题、阅读量等关键指标,确保数据完整无遗漏。
这一自动遍历能力,与传统RPA(机器人流程自动化,Robotic Process Automation)技术有着本质差异。传统RPA工具如UiPath、Blue Prism通过录制用户操作轨迹生成固定脚本,一旦目标网站改版,脚本即告失效,维护成本极高——其核心局限在于「脆弱性」:基于坐标定位或DOM路径的固定脚本,面对UI微小变化便可能整体失效。
而AI Agent引入的多模态感知能力——尤其是基于**视觉语言模型(VLM,Vision-Language Model)**的屏幕理解——使其能以语义层面而非像素层面理解界面。以GPT-4V、Claude 3系列、Gemini Ultra为代表的VLM,其核心能力在于将视觉特征与语言语义对齐:在Web自动化场景中,VLM可直接"阅读"网页截图,识别按钮功能、表单字段含义,甚至理解复杂数据图表,无需依赖HTML结构或坐标定位。Agent"看到"一个按钮,理解的是"这是一个用于翻到下一页的导航控件",而非"坐标(452, 318)处有一个蓝色矩形"。即便目标平台完全重构前端代码,Agent也能凭借视觉理解重新定位操作路径,将自动化脚本的维护成本大幅降低。这种语义级感知赋予Agent在界面布局发生变化时的自适应能力,这一范式转变被业界称为「认知自动化」(Cognitive Automation),代表着从规则驱动向意图驱动的自动化演进,使Agent在应对微信公众号后台此类可能随时更新的平台时,具备了传统RPA难以企及的鲁棒性。

第三步:生成并存储Excel报表
数据抓取完成后,Agent按用户指定规则(阅读量从低到高)完成排序,自动生成Excel表格,并存储至用户预先指定的文件夹中。整个过程无需人工干预,一气呵成。
这一模式的价值与启示
大幅降低自动化门槛
传统自动化脚本(如Python爬虫)需要一定编程基础,且页面结构一旦变化就需要重新维护。而Skill加持的AI Agent通过自然语言交互,将复杂操作封装在Skill内部,让没有技术背景的运营人员同样能享受自动化带来的效率提升。
授权边界与数据安全
值得关注的是,本案例中用户明确表达了"我允许你登录我的微信公众号后台"这一授权声明。在Agent能够代替用户操作敏感账户的场景下,权限授予与数据安全是不可绕开的议题。
从行业最佳实践来看,成熟的授权方案应遵循OAuth 2.0协议——这一由IETF制定的开放标准(RFC 6749)是目前互联网最广泛采用的授权框架,其核心机制是「令牌换权限」:用户通过授权服务器颁发访问令牌(Access Token)给第三方应用,令牌可设置作用域(Scope)和有效期,从而在不暴露账户密码的前提下实现权限的精细化控制,并可随时撤销。例如,一个仅需读取数据的Agent,其令牌Scope应被限定为只读权限,从根本上杜绝越权写入的风险。
在面向Agent的下一代授权协议演进中,OAuth 2.1正在整合PKCE(Proof Key for Code Exchange)等安全增强机制,而专为AI代理场景设计的授权讨论也在IETF工作组中持续推进,以应对Agent代表用户跨多服务执行操作时的委托授权(Delegated Authorization)复杂性。在Agent场景下,理想的授权模型还应叠加**「人工确认节点」(Human-in-the-loop)**——即Agent在执行高风险操作(如写入、删除)前,需显式获取用户的实时确认,而非仅依赖初始的一次性授权声明。
然而微信公众号后台目前并未对第三方Agent开放标准的OAuth接口,这意味着Agent登录往往依赖用户直接提供凭证或通过浏览器会话接管实现,存在一定的安全灰色地带。用户在使用此类工具时,应优先选择支持权限最小化原则(即Agent仅能访问完成任务所必需的最少数据)、操作可审计(提供完整操作日志)的平台,以在便利与风险之间建立可信边界。用户需清楚Agent会访问哪些数据、执行哪些操作,才能在便利与风险之间找到合理平衡。
Agent能力扩展的方向
公众号数据统计只是Skill辅助Agent的一个缩影。随着Skill生态持续丰富,Agent有望胜任更多运营场景——从数据统计延伸至内容排版、评论回复、跨平台数据聚合分析等。当AI真正从"回答问题"进化为"完成任务",其对生产力工具的重塑才算正式开始。
结语
通过Skill赋能AI Agent自动统计公众号数据的实践,我们看到了AI从辅助工具向自主执行主体演进的清晰趋势。对于内容创作者和运营人员而言,掌握这类工具意味着从重复性劳动中解放出来,将精力真正投入创造性的内容生产。而这一切背后,正是Skill机制让通用大模型具备了落地具体业务场景的可能性——从MCP协议推动的标准化工具调用接口与其资源-提示-工具三层原语设计,到ReAct范式带来的动态规划能力与VLM驱动的认知自动化界面理解跃升,再到不断丰富的跨平台Skill生态,AI Agent的能力边界正在以我们难以预料的速度向外扩张。
核心要点
相关推荐

耳机进入黄金时代:降噪普及、AuraCast崛起与开放式耳机爆发
The Verge Cast深度探讨耳机行业黄金时代:降噪技术全面普及不再是竞争护城河,AuraCast广播技术崛起,开放式耳机集体爆发。附Nothing、Sonos Ace Ultra、AirPods、Beats 360、Sony XM4C五款新品速评与选购建议。

用Codex在NVIDIA Jetson上部署独立VLM视觉终端实战
基于 YouTube 技术演示,详解如何借助 AI 编码代理 Codex 在 NVIDIA Jetson 上部署本地视觉语言模型(VLM),并改造为开机自启、离线可用的独立 kiosk 终端,涵盖硬件评估、权限安全与环境适配全流程。

NASA DART任务:人类首次成功偏转小行星轨道
NASA通过DART任务首次验证了动能撞击偏转小行星的可行性。探测器撞击小卫星Dimorphos后,其轨道周期缩短32分钟,远超预期的73秒,为人类行星防御提供了关键数据。