游戏中习得的AI技能,能迁移到现实工作吗?

用铁路游戏训练AI竟能提升金融研究表现,关键在于训练设计而非训练任务本身。
Good Start Labs用铁路调度游戏训练AI的实验产生了一个反直觉的发现:特定版本的模型在完全无关的金融研究任务上表现更优。实验揭示,能力跨域迁移的决定因素不是训练数据或任务类型,而是训练设计本身——具体而言,是奖励函数是否引导模型学习通用推理模式,而非死记单一场景的最优解。游戏因其规则清晰、反馈可量化的特性,成为低成本培养可迁移能力的理想环境。这一发现对AI开发具有务实价值:投资于能培养通用推理能力的训练方法,或许比针对每个下游任务单独训练更具性价比。但该结论目前仍属初步观察,迁移的稳健性与可推广性尚待系统性验证。
一个铁路游戏引出的迁移学习实验
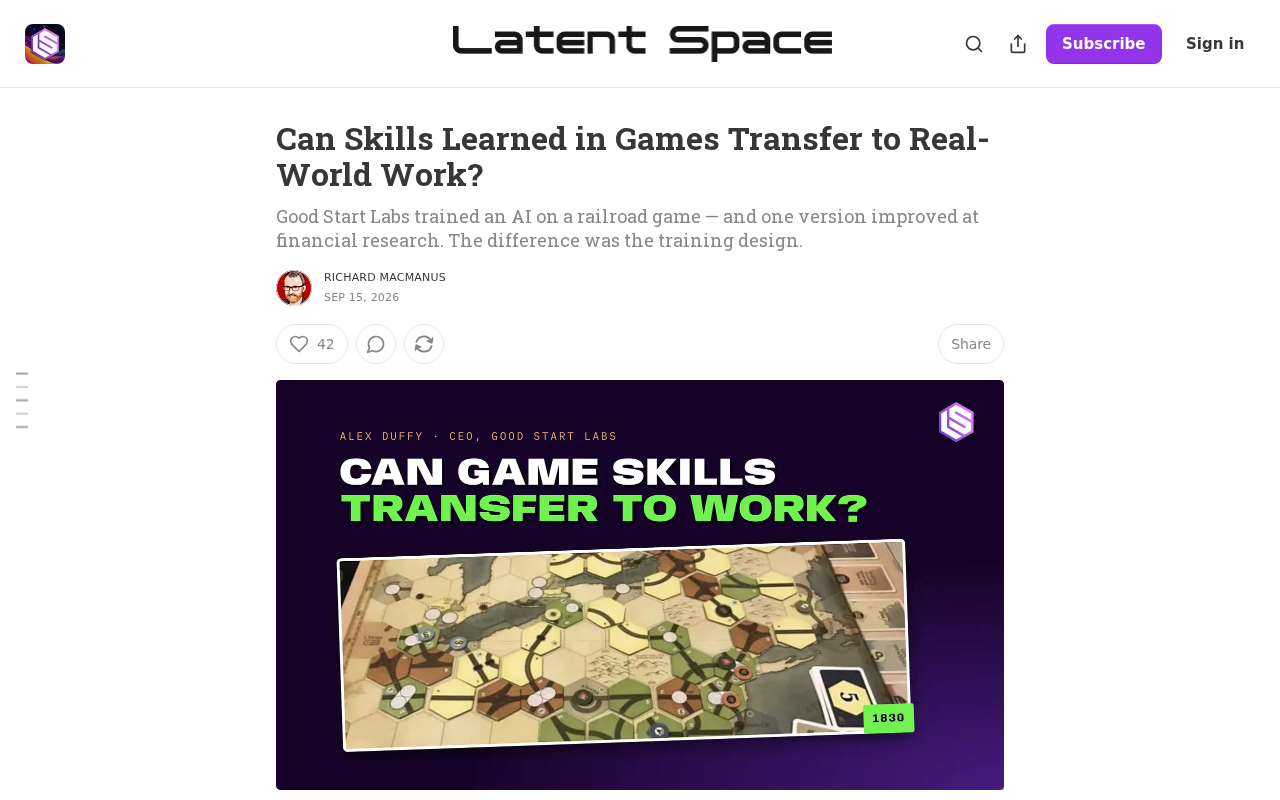
Good Start Labs 做了一件看似不着边际的事:他们用一款铁路调度游戏来训练AI,结果其中一个版本的模型在完全不相关的金融研究任务上表现得更好。这个反直觉的结果背后,藏着一个关于AI能力迁移的核心命题——技能到底能不能跨领域转移,以及决定这种转移能否发生的关键因素是什么。
从表面看,铁路游戏和金融研究几乎没有交集:前者关乎路径规划、资源调度、时序约束;后者涉及数据检索、逻辑推理、信息整合。但如果剥离掉具体的领域外壳,两者共享了一些更底层的认知结构,比如在多重约束下做序列决策、在不完整信息中权衡取舍、以及为达成目标而进行多步骤规划。这恰恰是迁移学习真正关心的东西。
决定成败的不是任务,而是训练设计
这次实验最值得玩味的一点在于:并非所有用铁路游戏训练出来的版本都能迁移到金融研究,只有特定的一个版本做到了。区别不在训练数据本身,而在训练设计(training design)。
这意味着,能力迁移不是训练某个游戏就会自动发生的副产品,而是需要刻意设计出来的结果。同样的游戏、同样的目标,如果训练方式不同——比如奖励函数如何设定、模型被引导去优化哪种策略、是记住具体解法还是学习通用的解题框架——最终得到的模型泛化能力可能天差地别。
换句话说,如果训练过程鼓励模型去学习可迁移的推理模式,而非死记硬背特定场景的最优解,那么这些能力就更有可能在陌生任务中复用。反之,一个只擅长"通关"的模型,其能力往往被牢牢锁死在训练分布之内。
奖励函数(reward function)在这里扮演着关键角色。在强化学习框架下,奖励函数定义了模型"什么行为值得被强化"。如果奖励仅针对最终结果(如通关成功),模型会倾向于走捷径、记忆特定场景的解法;而如果奖励被设计成鼓励中间过程的推理质量——例如约束满足的效率、资源分配的灵活性、对新情况的适应速度——模型就有动机去内化更抽象的策略模式。这与课程学习(curriculum learning)的思路也有共鸣:通过精心安排训练任务的难度与多样性,引导模型逐步构建可泛化的能力图谱,而非在单一难度的重复样本中退化为查表式记忆。
为什么这件事很重要
这个实验触及了当前AI研究中一个高价值的方向:如何让模型学到真正通用、可复用的能力,而不是过拟合到单一任务上。
游戏之所以成为理想的训练场,是因为它提供了清晰的规则、可量化的反馈和几乎无限的可控环境。研究者可以在游戏里低成本地塑造某种认知能力,再观察这种能力能否迁移到成本更高、更难标注的现实任务中。铁路调度到金融研究的跨越,本质上是在验证"抽象能力"是否可以脱离原始语境独立存在。
对企业和开发者而言,这带来一个务实的启示:与其针对每个下游任务单独训练模型,不如投资于能培养通用推理能力的训练环境和训练方法。一个设计得当的"训练场",其产出的能力可能覆盖多个看似无关的应用场景,从而摊薄训练成本、提升模型的适应弹性。
迁移学习(transfer learning)本身并不是新概念——预训练大语言模型的核心范式就是先在海量通用数据上学习,再迁移到具体任务。但这里讨论的是一种更精细的迁移:通过有意设计的专项训练环境,向已有基础能力的模型"注入"某种特定的推理倾向,再让这种倾向在跨域任务中自然显现。这与"微调"(fine-tuning)的常规路径不同——微调往往以牺牲泛化性为代价换取特定任务的精度,而这里追求的是在不损失通用性的前提下强化某类认知结构。两者之间如何取得平衡,是当前对齐研究与能力研究共同面对的核心张力之一。
有待验证的开放问题
必须指出,这只是一个初步的、单一来源的观察结果,还有大量问题没有答案。比如:这种迁移效应有多稳健?是否能推广到金融研究之外的其他领域?"正确的训练设计"具体包含哪些可复制的原则?以及,游戏这种高度结构化的环境,能否代表现实世界那种模糊、开放、充满噪声的问题空间?
目前公开的信息还不足以回答这些问题。Good Start Labs 的这次尝试更像是一个引子,提示我们迁移学习的杠杆点或许不在数据规模,而在训练过程的精巧设计。真正的价值将取决于后续能否把"什么样的训练设计能带来迁移"这件事,从个案总结成可复现的方法论。
相关推荐
HuggingFace开始内容审查?下架模型引发社区争议
HuggingFace下架一个标注「用于网络攻击」的去审查GLM模型,引发开源社区关于内容审查的争议。本文梳理事件始末,分析abliterated模型的敏感性,以及平台治理透明度这一真正痛点。
Cayu:构建长周期领域智能体的开源Python框架
Cayu 是一个用于构建领域专用、长周期 AI 智能体的开源 Python 框架。它让开发者围绕工具、知识与业务规则组装 harness,并提供集成的持久化运行时处理会话、状态、恢复、审批与可观测性。本文解析其核心思路与落地场景。
社交媒体真的在伤害青少年吗?一场悬而未决的科学争论
社会心理学家乔纳森·海特在《焦虑的一代》中将青少年心理健康下滑归咎于社交媒体,但这一论断在学术界引发分歧。本文探讨相关性与因果关系的争议,以及这场辩论对公共政策的现实意义。