语音AI为何还没迎来自己的ChatGPT时刻?

语音AI因上下文理解的结构性缺陷,至今未能复制ChatGPT式的大众爆发时刻。
多位行业高管指出,语音AI尚未迎来类似ChatGPT的突破性临界点。核心原因在于语音AI的处理管线高度脆弱:语音识别、语义理解、对话管理、响应生成等多个环节的误差会逐级叠加,而"上下文层"对关键信息的遗漏往往导致整条链路崩溃。与文本交互不同,语音交互的实时性和连续性使每一个环节的失误都被即时放大,用户的容忍度极低。技术能力的提升并不自动转化为产品体验的成熟——要真正普及,语音AI必须跨越"让普通用户愿意反复依赖"的可靠性门槛。多模态大模型的发展被视为最有希望的突破路径,但产业化落地的瓶颈依然存在。
语音AI的"ChatGPT时刻"迟迟未到
当ChatGPT以惊人的对话能力重塑了人们对AI的认知后,整个行业都在寻找下一个爆发点。语音AI曾被寄予厚望,被认为是继文本交互之后最具潜力的交互方式。然而,多位行业高管认为,语音AI至今尚未迎来属于自己的"ChatGPT时刻"——那种让技术从小众走向大众、彻底改变用户习惯的临界点。
这一判断背后,反映的是语音AI技术在实际落地中仍面临的结构性难题。尽管语音识别和语音合成的质量近年来大幅提升,但要构建一个真正可靠、流畅、能理解复杂语境的语音交互系统,依然困难重重。
上下文理解:语音AI的致命短板
行业观察指出,语音AI最核心的问题之一在于其"上下文层"(context layer)常常遗漏关键信息。在一段对话中,用户表达的意图往往依赖于前文、环境以及隐含的背景知识。一旦系统在理解上下文时出现偏差,就可能导致整个处理流程(pipeline)崩溃。
这与纯文本的大语言模型有本质区别。文本交互中,用户可以从容地组织语言、修正表达;而在语音场景下,交互是实时的、连续的,任何一个环节的错误都会被迅速放大。语音AI的管线通常包含语音识别、语义理解、对话管理、响应生成和语音合成等多个环节,每一环的误差都会向后传递并累积。
换句话说,语音AI不是单点技术的突破就能解决的问题,而是一个端到端系统工程的挑战。上下文理解的缺失,恰恰是让整条链路变得脆弱的关键节点。
为什么上下文如此难以处理
语音交互的实时性要求系统在极短时间内完成多轮推理,同时还要应对口音、语速、背景噪音、口语化表达等现实干扰。相比文本输入的规整,语音输入充满不确定性。当系统无法准确捕捉用户真实意图时,后续的所有处理都建立在错误的基础之上,最终反映为用户体验的断裂。
语音AI的处理管线(pipeline)是理解其脆弱性的关键框架。一条典型的语音AI管线至少包含以下环节:自动语音识别(ASR,将声音转为文字)、自然语言理解(NLU,解析意图与实体)、对话状态追踪(DST,维护多轮对话的上下文)、对话策略与响应生成,最后是文字转语音(TTS)合成输出。每个环节都有各自的错误率,而这些错误不会相互抵消,而是逐级叠加——语音识别将"明天飞北京"误识别为"明天去背景",后续所有推理就全部建立在错误前提之上。这种"错误级联"效应在文本交互中几乎不存在,因为用户输入的文字本身就是准确的,但语音场景天然缺少这一前提保障。
从技术到产品的鸿沟
高管们的观点揭示了一个更深层的行业现实:技术能力的提升并不自动等同于产品体验的成熟。ChatGPT之所以成为现象级产品,不仅因为底层模型强大,更因为它在特定交互形态下提供了稳定、连贯、可预期的体验。
语音AI要复制这种成功,需要在可靠性上实现质的跨越。用户对语音助手的容忍度其实很低——一次听错指令、一次答非所问,都可能让用户彻底放弃使用。这正是语音AI尚未真正普及的核心原因:它还没有达到让普通用户"愿意反复依赖"的可靠性门槛。
ChatGPT的爆发为何被视为"时刻"而非渐进式进步,值得深究。2022年11月ChatGPT发布后,5天内用户突破100万,两个月内月活超过1亿,创下消费级应用增长最快纪录。这一爆发的底层逻辑在于:它在足够宽的任务范围内首次达到了"好用到不需要说明书"的体验门槛。研究者将此称为"感知可靠性临界点"——当技术的失败率低于某个阈值,用户的心理模型从"工具偶尔有用"切换到"默认依赖"。语音助手(Siri、Alexa、Google Assistant)存在已逾十年,用户渗透率虽高,但"深度依赖"率始终低迷,正是因为从未跨越这一临界点。当前语音AI面临的核心挑战,本质上是如何在语音这一更高难度的交互形态下重现ChatGPT的这次跨越。
行业的下一步在哪里
要迎来语音AI的"ChatGPT时刻",关键或许在于重新设计整个上下文处理架构,让系统具备更强的容错能力和语境记忆能力。随着多模态大模型的发展,将语音、文本、环境信息统一建模,有望从根本上改善上下文理解的质量。
对于创业者和产品团队而言,这意味着不应盲目追逐语音交互的热度,而要正视其工程复杂性。谁能率先解决上下文层的可靠性问题,谁就可能定义语音AI的下一个时代。
当下,语音AI仍处在爆发前夜。技术的拼图正在逐块拼合,但那个决定性的临界点尚未到来。
多模态大模型是当前被寄予最多期望的技术路径。以GPT-4o、Google Gemini为代表的原生多模态模型,尝试将语音、文本、图像作为统一的输入流进行联合建模,而非像传统管线那样先转文字再理解。这一架构的优势在于:语音的韵律、停顿、语气本身携带的语义信息不会在ASR环节被丢弃,系统可以直接从声学特征中提取情绪与意图线索。2024年OpenAI演示的GPT-4o实时语音模式展示了这一路径的潜力——响应延迟降至约200毫秒,接近人类对话的自然节奏,且能感知说话者的情绪变化。然而,原生多模态语音模型的训练数据需求、推理成本以及在嘈杂真实环境中的鲁棒性,目前仍是产业化落地的主要瓶颈。
相关推荐
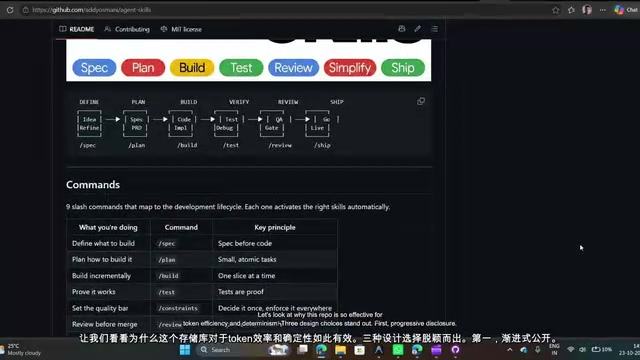
别再往CLAUDE.md塞两万行:10个技能砍掉上下文成本
与其往CLAUDE.md塞两万行规则,不如用渐进式披露的技能体系。本文拆解10个Claude Code技能:Addy Osmani Agent Skills、Graphify语义知识图谱、Superpowers子代理编排、LSP插件等,教你削减token成本并提升代码质量。

苹果iPhone Duo折叠屏开箱:万元级新物种值不值?
苹果首款折叠屏iPhone Duo开箱上手:顶配近5000加元,哑光内屏成最大亮点,折痕控制出色,护照式宽矮比例引领新形态。本文梳理屏幕、铰链、手感和价格的完整体验。
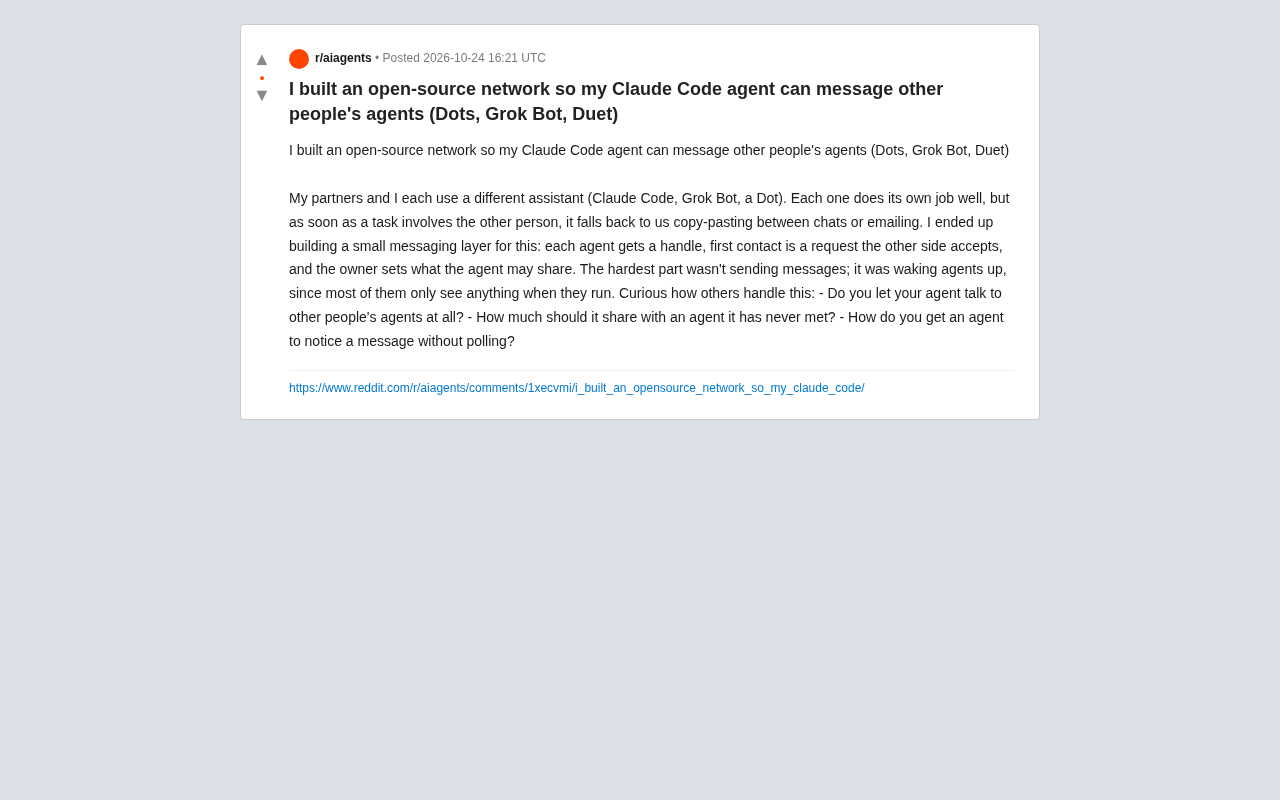
开源智能体消息网络:让Claude Code与其他AI助手直接对话
开发者构建开源消息层,让Claude Code、Grok Bot等AI智能体直接通信。项目采用句柄与握手机制控制权限,但唤醒休眠智能体成为最大技术挑战。探讨智能体互操作性的未来与信任边界。