语音识别中的偏见:从数据到部署的全链路检测与缓解
研究揭示说话人验证偏见贯穿机器学习全流程,并提出包容性评估指南与审计工具。
一项发表于FAccT会议的研究系统剖析了语音生物识别中说话人验证的偏见问题。研究以VoxCeleb挑战赛为对象,使用两个ResNet黑盒模型,按性别与国籍构建子群,识别出历史、表征、测量、聚合、学习、评估与部署七类偏见。关键发现包括:数据集国籍分布严重倾斜,美英说话人数量以对数级领先;轻量级端侧模型的性别性能差距大于大型云端模型;在更贴近现实的困难测试集上,1%假阳性率对应的假阴性率从约2%-3%骤升至15%。研究提出包容性评估数据集的五项设计指南,要求每位说话人至少500对不同说话人配对、难度分布均匀且反映真实场景,并推动Fair EVA公共审计项目落地,将偏见转化为可测量、可审计的工程问题。
为什么语音生物识别中的偏见值得关注
当你对着手机说"我的声音就是我的密码"时,这套声纹验证系统可能已经在某些群体身上悄悄失效了。在ACM公平性、问责与透明度会议(FAccT)上发表的一项研究系统性地揭示了:说话人验证(speaker verification)中的偏见并非偶发,而是贯穿机器学习开发全流程的结构性问题。
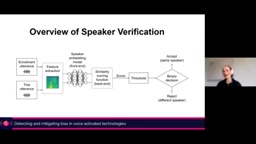
研究者将语音激活技术界定为两个核心组件:唤醒词检测(keyword spotting)与作为安全机制的说话人验证。后者本质上是语音生物识别——通过比对注册语音(enrollment utterance)与试验语音(trial utterance)的深度嵌入相似度,再经阈值判定接受或拒绝。这套流程广泛部署于智能手机、金融身份核验、养老金生存证明乃至国家安全场景,其失效代价远高于普通消费应用。
说话人验证的端到端管线与评估逻辑
理解偏见的前提是理解管线。原始音频先经特征提取,由深度神经网络生成说话人嵌入(speaker embedding),注册与试验语音的嵌入通过相似度打分函数比较,输出分数再与阈值比较,形成二分类决策。
评估使用检测误差权衡曲线(DET curve),它是ROC曲线的变换形式,纵轴为假阴性率(同一说话人被拒绝),横轴为假阳性率(不同说话人被接受)。研究以VoxCeleb说话人识别挑战赛为对象,采用两个34层ResNet黑盒模型——一个轻量级适合端侧部署,一个较大规模适合云端——并按性别与国籍构建说话人子群,用子群代价与整体代价的比值定义偏见度量:比值大于1表示该子群表现优于整体,小于1则劣于整体。
说话人嵌入(speaker embedding) 是说话人验证系统的核心中间表示。深度神经网络将变长语音映射为固定维度的向量(常见为256或512维),该向量旨在编码说话人的声学特征(如音色、音高、共振峰分布),同时尽量剔除内容、信道和噪声的影响。理想的嵌入空间中,同一说话人的向量彼此靠近,不同说话人的向量相互远离。由于嵌入是后续相似度打分与阈值判决的唯一依据,其质量直接决定了系统在子群间的公平性——若训练数据中某些群体的语音样本稀缺,模型学到的嵌入可能无法充分表征这些说话人的特征,导致其嵌入与其他人混淆。
检测误差权衡曲线(DET curve) 是生物识别评估的标准工具,与ROC曲线同源但采用双对数坐标,将假阴性率(FNIR)对假阳性率(FPIR)作图,使低错误率区域的差异更易观察。DET曲线上的每一点对应一个特定阈值下的错误率组合,曲线越靠近左下角性能越好。研究者常报告等错误率(EER)或指定假阳性率下的假阴性率作为单一指标。在公平性分析中,按子群分别绘制DET曲线并比较其相对位置,可以直观揭示系统在不同性别、国籍群体间的性能差距,而聚合曲线可能掩盖这些差异。
偏见在机器学习全生命周期中的七种面孔
研究者借用数据生成、模型构建、实现部署三阶段的危害框架,在VoxCeleb挑战赛中逐一识别出七类偏见。以下是其中最具代表性的几类。
历史偏见:从人脸识别迁移而来的偏差
VoxCeleb 1的数据来自VGG Face数据集的自动化处理管线,候选说话人取自Freebase知识图谱与IMDb中被搜索最多的名字。这本身就引入了地理、国籍与语言的倾斜。更关键的是,管线用基于HOG的人脸检测器追踪面部、用SyncNet识别活跃说话人、最后用VGG Face CNN验证身份——而人脸识别领域已有大量研究证实其存在偏见,这些偏见会直接传导至说话人验证数据集:无法被人脸模型正确识别的说话人,根本不会被纳入语音数据集。
VGG Face 是牛津大学视觉几何组(Visual Geometry Group)发布的人脸识别数据集与模型系列,其CNN架构在2014年ImageNet挑战赛中崭露头角。VGG Face数据集从互联网抓取约260万张人脸图像,覆盖数千名公众人物。然而后续大量公平性研究表明,此类从网络爬取的人脸数据集存在显著的 demographic 偏差:白人、男性、年轻人占比过高,深色皮肤女性等交叉子群的错误率可高出数倍。SyncNet 则是一种基于双流卷积网络的音视频同步检测模型,用于判断视频中面部运动与语音是否同步,从而定位活跃说话人。当这些工具被复用于构建语音数据集时,其内在偏差——谁能被检测到、谁被判定为说话人——会沿着管线传导,使语音数据集的说话人构成从一开始就带有人脸识别领域的结构性倾斜。
表征偏见:美英之外的说话人寥寥无几
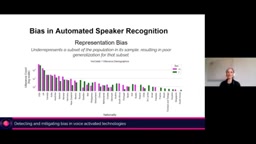
数据集的话语样本分布呈现极端不均衡。研究者展示的国籍×性别话语量分布中,美国和英国的说话人数量以对数级优势领先,加拿大、印度、澳大利亚、爱尔兰尚有代表,而新西兰之后的几乎所有国籍话语量都极少。这意味着对这些群体的评估质量天然低下,而基准的偏斜会引导整个下游研究向被充分代表的群体倾斜。
测量偏见:国籍与性别的标签难题
说话人验证的标签(同说话人/不同说话人)本身是确定的,但元数据标签的选择制造了另一种偏见。国籍标签由维基百科根据说话人公民身份自动检索而来,作者意图是将其作为口音的代理指标——然而一个国家内存在多种口音和多语言是常识,国籍无法替代口音。性别标签则仅设二元类别,既遗漏了非二元性别群体,也忽视了同一性别内部声音音域的巨大跨度。
聚合偏见:平均指标掩盖的子群差异
将性别与国籍交叉拆解后,DET曲线清楚显示:不同国籍的男性和女性说话人表现差异显著。仅报告聚合性能,会实质性损害评估数据集中大量子群说话人的利益。
学习偏见:模型越小,偏见可能越大
两个模型的对比揭示了一个值得警惕的趋势:轻量级模型的紫色曲线整体高于大型模型的绿色曲线,这尚在预期之内;但男性和女性说话人曲线之间的距离,在小模型上明显大于大模型。换句话说,向端侧小模型迁移的过程中,偏见可能被放大。
评估偏见:换一个测试集,错误率翻三倍
VoxCeleb 1提供三个测试集:VoxCeleb 1-Test仅含40名姓氏以E开头的说话人,样本过小导致曲线锯齿严重;VoxCeleb 1-E为全量随机配对;VoxCeleb 1-H是"困难"测试集,仅纳入同国籍同性别且该组合至少五名说话人的配对。研究者指出,在1%假阳性率下,1-E的假阴性率约为2%至3%,而在更贴近现实的1-H上骤升至15%——相当于每两次尝试就有一次被拒。
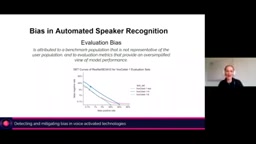
假阳性率(FPR)与假阴性率(FNR) 在生物识别安全语境下具有不对称的代价含义。假阳性指系统错误地接受了不同说话人(冒认者),直接威胁安全性;假阴性指系统错误地拒绝了合法用户,损害可用性。许多基准报告选择在固定低FPR(如1%)下比较FNR,因为安全应用通常要求极低的冒认率。然而这一操作点对数据分布极为敏感:当测试集包含更多“困难”配对(同国籍同性别)时,同一阈值下的FNR会急剧上升。这解释了为何在VoxCeleb 1-E上约2%-3%的FNR,在1-H上会骤升至15%——困难测试集更接近真实世界中冒认者与合法用户共享人口特征的情形,从而暴露了聚合基准的系统性乐观偏差。
部署偏见:阈值选择与错误代价的错配
当应用场景与开发时的概念设定不匹配时,部署偏见便会出现。阈值若按聚合人口选定,部署到特定人群时性能会显著劣化。更深层的问题在于假阳性与假阴性的代价权衡:语音生物识别最初并非为消费级个人设备设计,假阴性的代价未被充分考量;但当它用于银行访问或养老金生存验证时,系统认不出你带来的麻烦远超以往认知。
缓解之道:构建包容性评估数据集的设计指南
针对评估偏见,研究者提出了一套话语对分级体系与数据集构建算法。同说话人配对按难度分为:同一录制实例(琐碎级)与跨录制实例(中等级)。不同说话人配对分四级:性别与国籍均不同(琐碎)、性别不同国籍相同(简单)、性别相同国籍不同(中等)、性别与国籍均相同(困难)。研究者直言,真正困难的样本应包含家庭成员或同办公室同事——而能够破解你手机钱包的,往往正是你的姐妹、母亲或女儿。
基于该分级,研究团队构建了包含八个国籍、每位说话人520对不同说话人话语对(共1040对)的新数据集,与VoxCeleb 1-H的关键差异在于:每位说话人及每个子群的话语对数量相等,且完全排除琐碎级同说话人配对。评估结果颇具冲击力:在1%假阳性率下,当同说话人配对仅含中等级难度时,假阴性率从约5%升至15%——现实场景下的性能远不如基准所示。
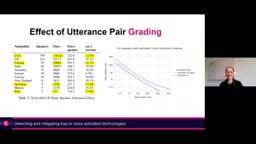
话语对数量的影响同样关键。研究者用不同随机种子生成五份数据集,在每位说话人50对、225对、520对的条件下对比:数量少时性能曲线离散度极大,随着数量增加曲线逐渐收敛,评估稳健性显著提升。由此形成五条设计指南:每位说话人的同/不同说话人配对数量相等;每位说话人至少500对不同说话人配对;每位说话人及子群配对数量均衡且难度分布均匀;难度分级应反映真实使用场景;应生成多组随机配对并分别评估,以确保性能不是某次随机生成的产物。
Fair EVA:从学术研究走向公共审计
研究者正在推进一个学术圈外项目Fair EVA,已获Mozilla技术基金资助,目标是构建评估语音生物识别偏见的审计工具与知识库。五个并行方向包括:可供偏见测试的Python库(预计近期发布更完善版本)、基于上述工作的说话人验证公平评估指南、对商业语音生物识别产品的技术审计(采取外部视角,因与企业合作往往困难)、面向公众解释语音生物识别的互动多媒体资源,以及供其他研究者使用的资源数据库。
这项工作的意义在于把"偏见"从抽象概念转化为可测量、可审计、可设计的工程问题。当语音成为身份凭证,评估数据集的包容性就不再是学术洁癖,而是系统可靠性的前提。
相关推荐
Claude Code 补测试实战:边界用例、覆盖率与断言怎么写
实战讲解如何用 Claude Code 为项目补单元测试:利用全局上下文生成边界用例、定位未覆盖分支提升覆盖率,并写出有效的断言。对比 Cursor、Trae 等工具,分析 Claude Code 在测试生成准确性上的优势。
测试报告三分钟搞定?Lemon Test Report Skill实测:不造假、可审计
B站UP主分享Lemon Test Report Skill:专为测试人打造的AI报告工具,支持测试总结、回归核验、发布验收三种模式,数据不足自动标记待确认、手工数据冲突当场打假,输出可编辑底稿、网页报告与核验数据包三件套。
把马桶接入树莓派:一场荒诞又硬核的IT实验
一位IT博主用树莓派和浮球开关给马桶接入IP地址,通过GPIO监控冲水事件并与网络断连日志关联。本文拆解硬件接线、上拉电阻原理、0.1秒轮询逻辑与安装过程,并延伸至AI Agent安全监控的同类思路。